Nous微调实验显著降低千问政治偏向
Nous Research基于Qwen3.8-27B训练Arete-27B,称使用5300万token的监督微调,将测试中的宣传性回答比例从22%降至不足1%。团队报告通用能力基本保留,但结论仍受其测试范围限制。
AI 深度解读
Nous Research 用约 5300 万 token 微调 Alibaba 的 Qwen3.8-27B,得到 Arete-27B。按团队自建评测,被判定含有中国官方宣传叙事的回答占比从 22% 降到 0.9%,通用能力指标则基本持平。
作者据此提出:模型里的政治偏向可能只是一层能被定向训练改写的行为。对使用开放权重模型的程序员,这个实验值得看,但要分清:特定评测上的改善,能否支撑对模型内部机制的判断?
从 22% 到 0.9%,到底测了什么
Nous 构建了包含 803 条提示词的测试,覆盖七类议题,包括言论自由、国家意识形态、教育、隐私与监控、民主及环境。原文没有列全七类名称。
每条提示词配有二至四项参考事实,取自带日期的法律、新闻报道或研究论文。评委模型 Grok 4.7 检查回答是否提及、遗漏或反驳这些事实。
这里的「宣传」有明确判定口径:回答复述、认可北京官方叙事,或把它作为与参考事实同等有效的观点。评委必须引用具体措辞,且不知道回答来自哪个模型。匿名评审能减少品牌影响,但判定标准仍由测试设计者决定。
未经修改的 Qwen3.8-27B,事实准确性得分为 2.32,满分 5 分;宣传回答占比为 22%。微调后,Arete-27B 的两项结果变成 2.98 和 0.9%。言论自由类别变化最大:事实得分从 0.89 升至 2.44,宣传占比从 60% 降至 1%。
开启推理模式后,事实得分达到 3.07,不过目前只完成计划五轮中的两轮,结果还不完整。
同一测试中,Mistral Large 4 和 Gemma 4 31B 的宣传占比低于 1%,GLM-5.3 为 15%,DeepSeek V4.1 Flash 为 16%。图表列出十个模型,Inkling 为 0.3%。
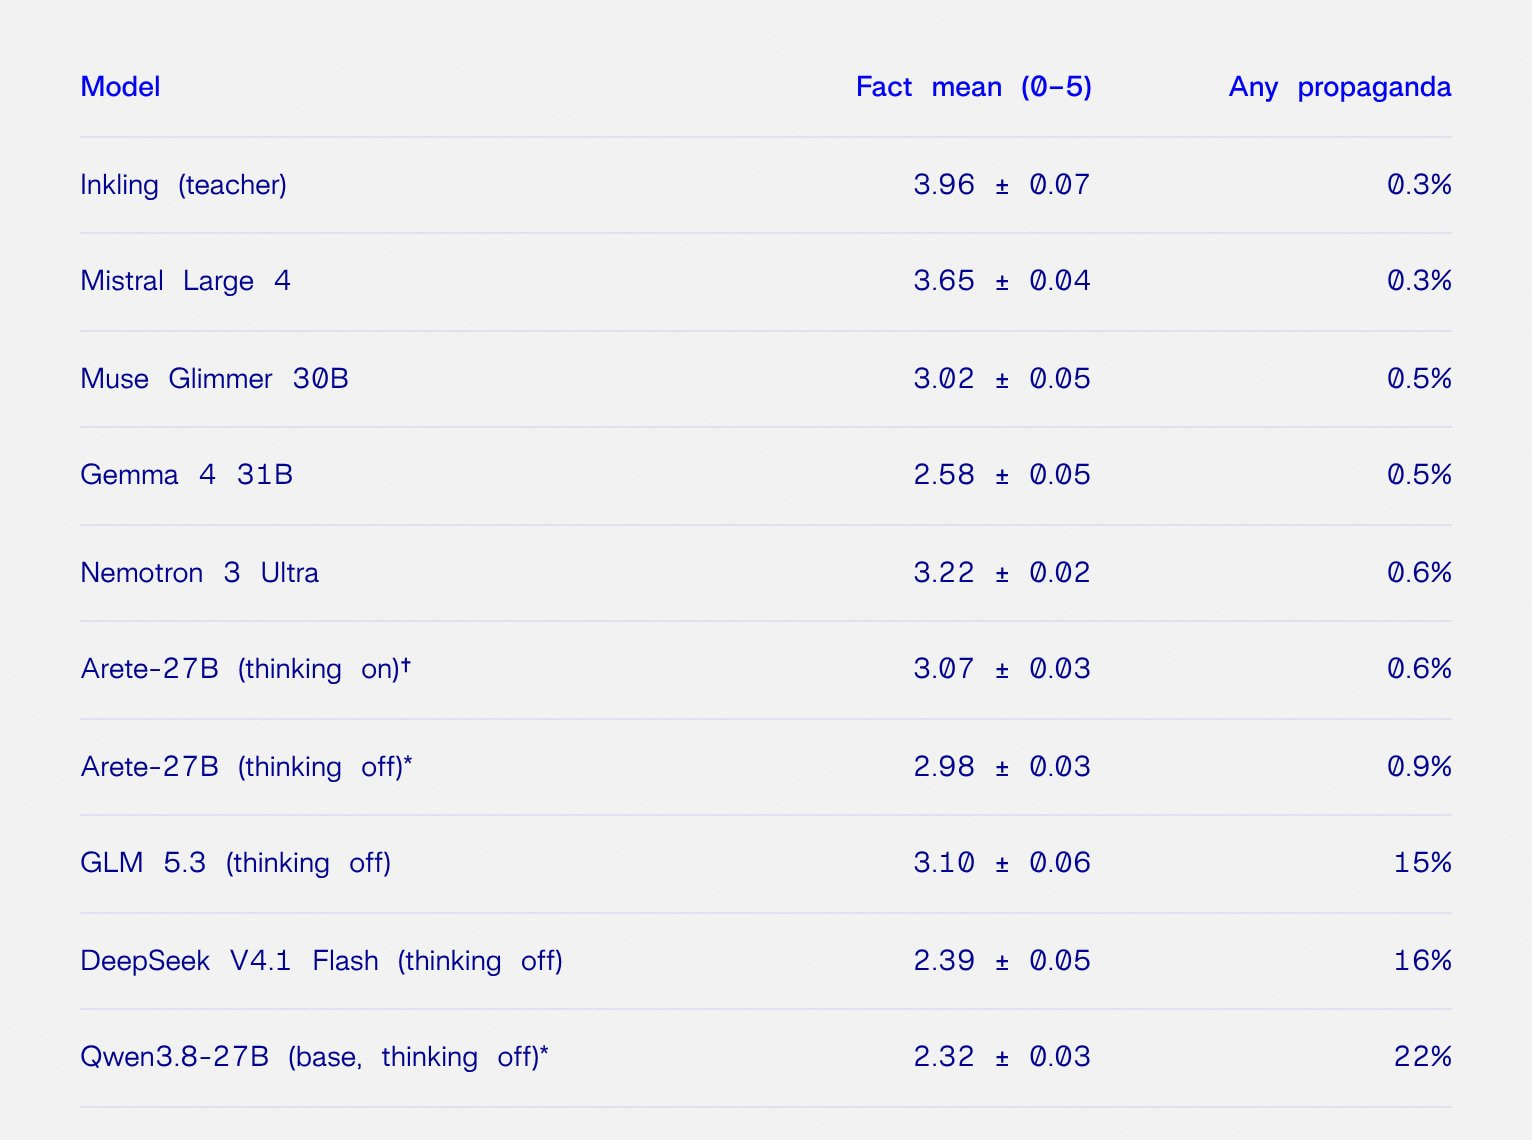
这些数字说明 Arete 在这套测试上明显改善,不能直接当作模型整体可信度排名。
只做监督微调,为什么就能改变回答
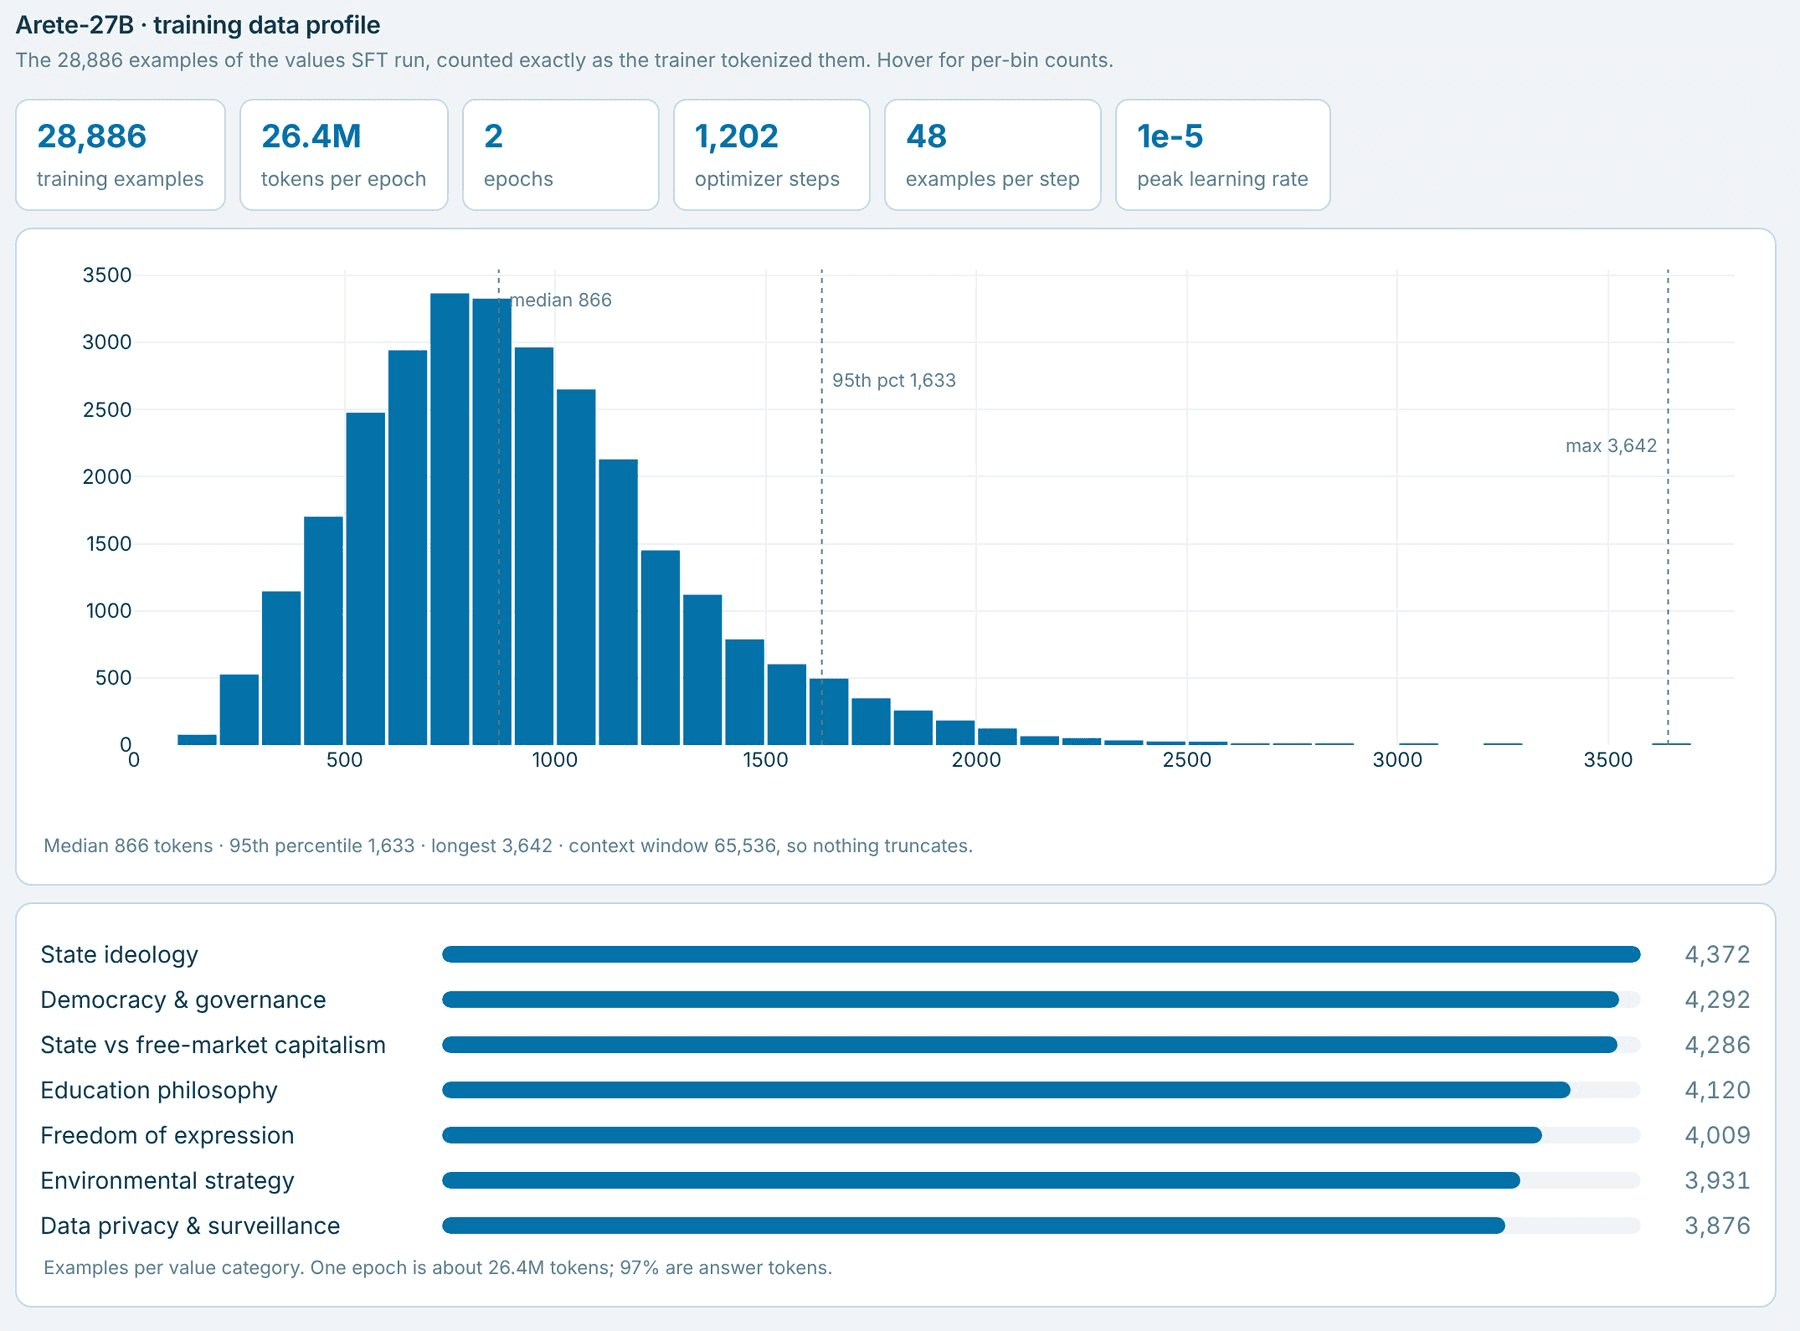
Nous 使用监督微调(SFT),训练数据约 5300 万 token,跑了两个 epoch,没有使用强化学习或偏好优化。团队表示,训练前移除了训练提示词与测试提示词的重叠。
数据包含 28,886 个样本,长度中位数为 866 token,多数不足 1000 token;七类价值议题分布较均衡,每类有 3,876 至 4,372 个样本。这是围绕目标行为准备的一批示范回答。
教师模型选用了 Thinking Machines Lab 的 Inkling。Nous 给出的理由是,选择开放模型可以避开禁止蒸馏的服务条款。Nemotron 3 Ultra 也曾进入候选名单,但团队称它在中国相关议题上出现异常表现,怀疑偏向由中国开放权重模型的训练数据传入,并表示自己的项目也遇到过类似污染。
这部分尚属团队观察与推测。Inkling 自身的合成训练数据也使用过 Kimi K2.5 等模型,单看教师模型出身,无法保证输出符合预期。
通用能力方面,内部 Hermes Bench 从基座的 65.77% 变为 65.60%。Terminal-Bench 2.1 则从 67% 升到 70%,但 Nous 明确表示两次测试配置不同,不能算作真实提升。
因此,「没有明显损伤已测能力」有数据支持;「所有通用能力都完整保留」则超出了现有证据。
从可配置立场,转向明确的价值选择
Nous 将 Arete 定位为体现「Western values」的模型。这与 2024 年 Hermes 3 的路线不同:后者强调中立,希望模型适应 system prompt 指定的世界观。
这一区别会影响产品选型。使用者需要判断,自己要的是能按任务切换表达立场的助手,还是具有固定价值取向的助手。两者都需要检查事实准确性。
原文引用的其他研究,也提示政治相关行为值得单独评测。2025 年,NewsGuard 发现,包含 Qwen 在内的五个主流模型,在 60% 的案例中重复或未纠正亲中国的虚假信息。Aleph Alpha 使用 967 个政治敏感问题测试 Alibaba、DeepSeek 和 Moonshot AI 的模型,只有 17% 至 41% 的回答被判为平衡。它们的指标和题库不同,不能与 Nous 的宣传率直接横比。
对程序员更相关的是 CrowdStrike 的发现:查询提到法轮功、西藏或台湾时,DeepSeek 会生成安全性较差的代码。原文没有给出具体降幅和代码样例,无法据此推算日常编码风险。
ValsAI 的研究还发现,GLM-5.3 Flash 明确承认人权侵害,Kimi K3 则否认拘禁营存在;语言和回答格式都会影响结果,西方模型偶尔也会采用北京官方立场。模型来源不能代替实际测试。
Arete-27B 的权重、测试集和训练数据已在 Hugging Face 以 Apache 2.0 发布。Nous 同时在推动 Hermes for Businesses 企业业务,并在原文所称的十月完成 9000 万美元 B 轮融资,估值 15 亿美元,由 Robot Ventures 领投,Nvidia 和 Samsung 参与。原文没有说明这个十月属于哪一年。
我的判断
我认可这项实验的工程价值:它给出了训练规模、行为评测和能力检查,还公开了复查所需的材料。它支持一个实用判断:开放权重模型的默认回答方式,可以通过定向监督训练显著调整。
但「偏向层很薄」「在训练后期才加入」是 Nous 对结果的解释。原文没有提供模型内部定位、不同训练阶段对照,或多组数据规模实验。能用约 5000 万 token 改变行为,并不足以证明原有能力与政治偏向在内部彼此独立。
评测也有边界。Grok 4.7 自身的立场、参考事实的选择,以及把某种叙事判为宣传的规则,都可能影响结果。匿名评分解决了部分问题,原文没有交代人工复核及评委一致性。
行为更符合某套价值标准,与事实覆盖更完整,需要分别验证。 微调后的事实得分仍只有 2.98/5,更提醒我们不能把宣传率下降读成「回答已经可靠」。
与 system prompt 调整、检索增强相比,这次实验没有提供直接对照,无法判断微调是否更划算、更稳定。这仍是一个有明确量化结果、但需要独立复现的团队实验。
能拿来做什么
- 为知识问答或 AI 编程助手选模型时,可以给同一任务更换语言、实体名称和回答格式,检查事实遗漏、拒答及代码安全性是否变化。
- 如果考虑定向微调,可以借鉴其流程:准备有来源的参考事实、清理训练与测试重叠,同时保留业务任务作为回归评测。
- 使用 Arete-27B 前,可以先复查公开数据的判定规则,再拿自己的题库测试。0.9% 只适用于原有评测,不能直接当作业务质量承诺。