GPT-6.2 双模型开放 API,Astra 缓存降价
OpenAI 开放 GPT-6.2 Astra 和 Sol 的 API,Simon Willison 的 LLM CLI 也已在 0.38 版支持两款模型。Astra 每百万输入和输出 token 分别为 8 和 40 美元,缓存输入从 1 美元降至 0.40 美元,Sol 维持 2 和 10 美元。
AI 深度解读
OpenAI 在 2026 年 11 月 17 日推出 GPT-6.2 Astra 和 GPT-6.2 Sol。Astra 的输入、输出单价降了两成,缓存输入降得更多,Sol 则维持原价。Simon Willison 跑了两组测试,发现模型降价和单次任务变便宜是两回事。
对用 Codex 写代码的人,这篇最值得看的是两个细节。Astra 在 max 档画一张图,比上一代花得更多。两款新模型用 Ultra 做同一个 Three.js 动画,也都没把需求里最重要的变形动作做好。
Astra 降了单价,为什么单次任务还可能更贵
两款模型的 API 名称是 gpt-6.2-astra 和 gpt-6.2-sol,Willison 发布的 LLM 0.38 已支持它们。
按每百万 token 计,GPT-6.2 Astra 的输入和输出分别是 $8 和 $40,为 GPT-6 Astra 的 80%。Claude Fable 5.2 也是 $8 和 $40,同样降到了前代价格的 80%。GPT-6 Astra 和 Claude Fable 5 原先都是 $10 和 $50。Astra 的缓存输入则从每百万 token $1 降到 $0.40。长时间运行的 agent 如果多次复用相同上下文,命中缓存的部分就能用上这档价格。
GPT-6.2 Sol 的输入和输出分别是 $2 和 $10,与 GPT-6.1 Sol、GPT-6 Sol 一致,也是 GPT-5.6 Sol($4 和 $20)的一半。
单价之外,还得看一次任务实际用了多少 token。Willison 让四款模型画骑自行车的鹈鹕,每款各试 high、xhigh、max。下表是图中标出的单次花费,单位为美分。
| 模型 | high |
xhigh |
max |
|---|---|---|---|
| GPT-6.2 Astra | 11.55 | 17.70 | 88.71 |
| GPT-6.2 Sol | 2.41 | 6.74 | 13.69 |
| GPT-6 Astra | 18.37 | 33.85 | 63.21 |
| GPT-6.1 Sol | 3.66 | 5.39 | 13.48 |
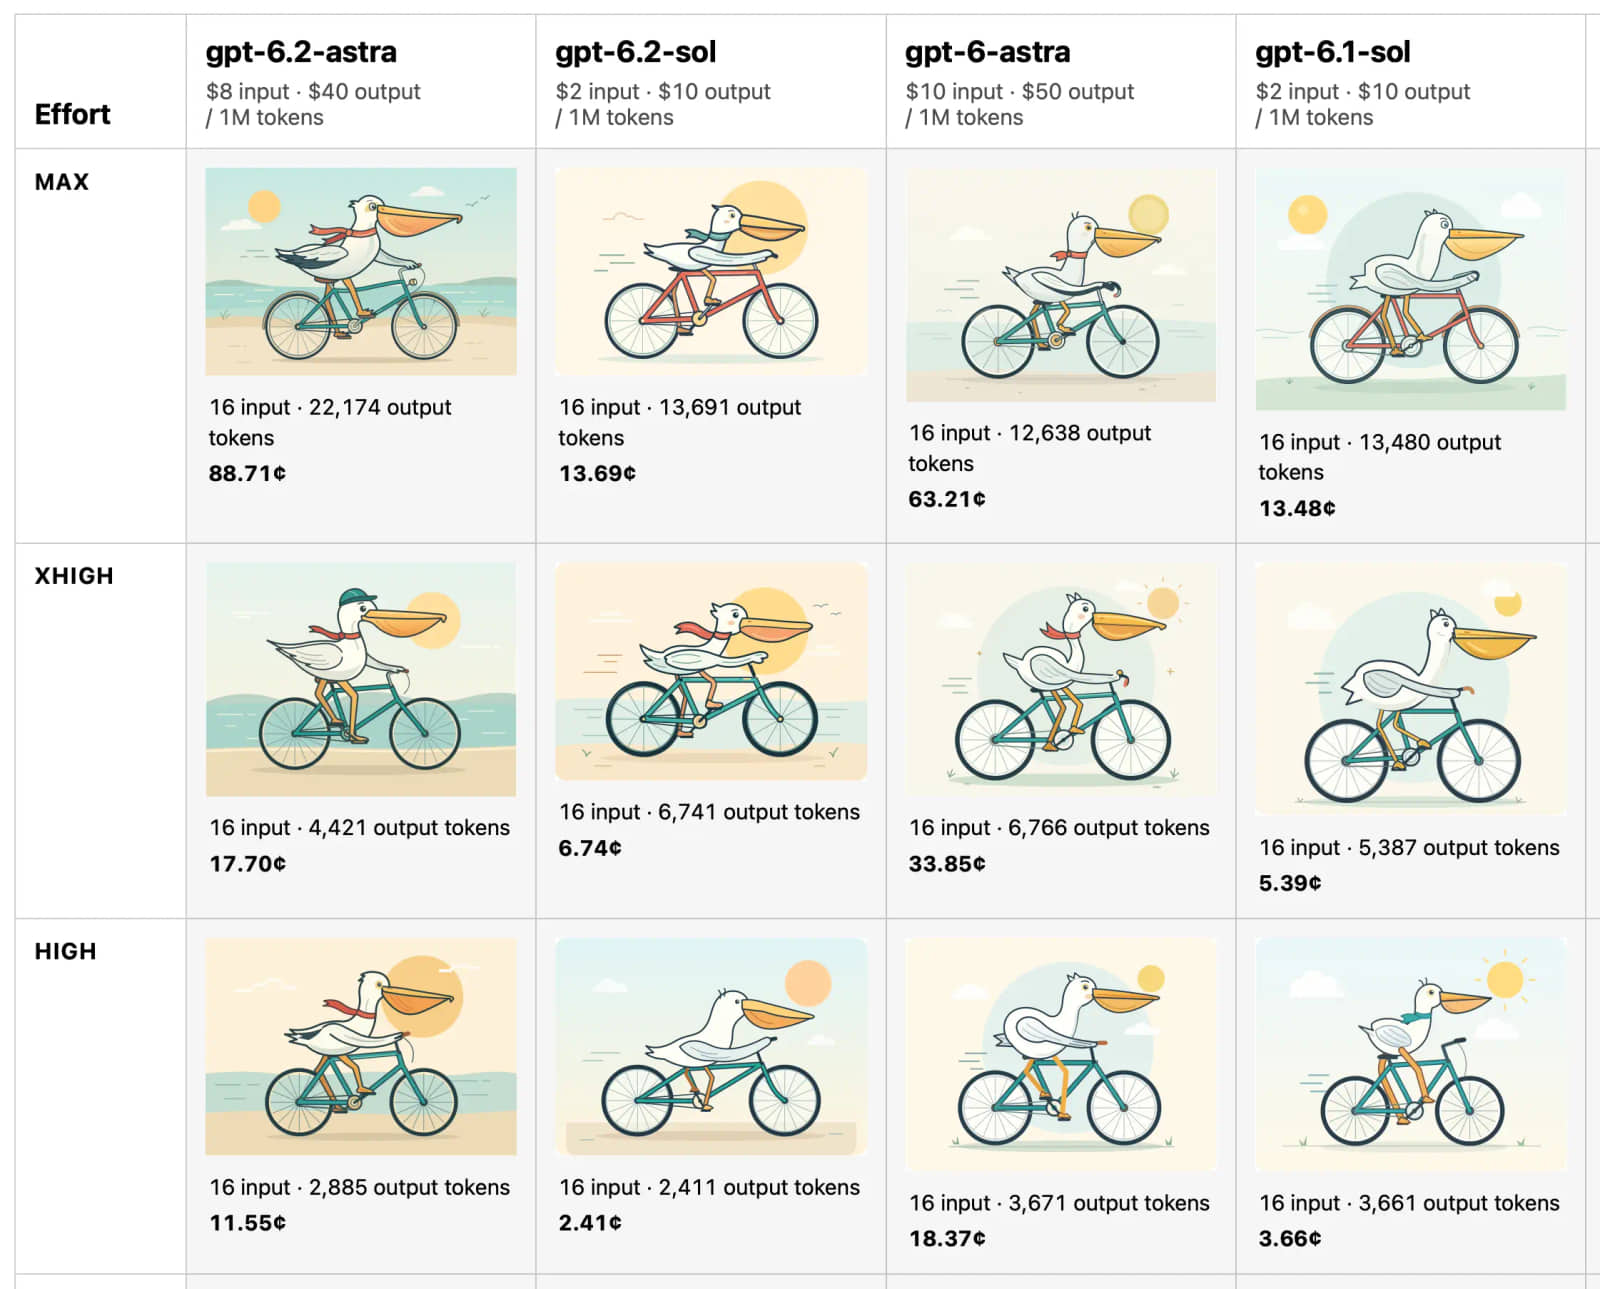
十二张图都能认出鹈鹕和自行车,差别主要在羽毛细节,以及握车把、踩踏板的姿势是否可信。GPT-6.2 Astra 的 max 图细节最多,这次也花了 88.71 美分,高于上一代同档的 63.21 美分。原文没有给出 token 用量拆分,单凭图上的账单无法判断差额出在哪一部分。
Three.js 动画最难的是让城市真的站起来
Willison 在 Codex CLI 里用 Ultra 跑同一个提示词。他要求模型使用 OpenStreetMap 数据做一段 Three.js 动画,让 Yonkers 以一个有冲击力的动作站起来,变成巨型机甲,再踏过 Manhattan、Queens 和 Brooklyn。
按作者的判断,Astra 和 Sol 都没做好「城市变成机甲」这一步,效果落后于 Claude Fable 5.2 和 Gemini 4 Carbon。这是作者对这一道题的观察,原文没给评分标准或多次运行的数据。
作者随后用 Codex 桌面版里的 GPT-6.2 Astra(Ultra)制作对比视频。他要求各取前 10 秒,Astra 放上半部,Sol 放下半部,各自叠加模型名,导出为 2000×2000 像素的方形视频。这一步处理的是已有成品,交付要求具体,回看也容易。它和前面的动画测试考查的是两种能力。
长任务接得住,为什么还会卡在一个文件名上
Theo Browne 在发布前给 OpenAI 的反馈里说,模型能调动并协调多个子代理,但有时会把内部实现细节抛给用户。他用 /goal make a new level for Outer Wilds 发起任务,约 2 小时后,任务进入 blocked。模型想知道一个审查代理会把视频片段写到 24_g521.mp4 还是 24_p11.mp4。用户只给了关卡目标,手上也没有可用来回答这个问题的信息。
Willison 还提到,Astra 6.2 在一些基准上低于 Fable 5.2,也有人觉得它的沟通方式难懂。原文没有列出具体基准分数,Theo 的案例也只说明这种阻塞发生过一次。
我的判断
选模型时,我会优先看同一验收条件下的实际花费。牌价适合估预算,鹈鹕图能帮助检查模型会不会处理握把和踩踏板这些细节,但团队要决定日常任务用哪个模型,还得拿自己的需求试跑。对需要长上下文的任务,缓存折扣能省多少,也取决于实际命中了多少输入。
Three.js 这个例子里,直接用 Ultra 跑完整需求可以观察模型独立交付的上限。日常开发也可以先验收最难的变形动画,再接地图和行走路线。拆开做更容易定位问题,作者没有对比过这两种流程,文章也没有给出档位之间的成功率。至于长任务中的沟通,Theo 的反馈适合作为一次具体的失败案例参考,无法用来判断这种中断有多常见。
能拿来做什么
- 拿一条现有的前端需求,用相同提示词和验收条件跑 Sol 与 Astra,记录实际花费、交付结果和需要人工补的工作。
- 做 Three.js 原型时,先把关键动作写成能回放验收的条件。例如,镜头要完整展示城市从地面结构抬起、展开并站稳,再决定要不要继续接地图数据和路线。
- 给 Codex 布置长任务时,交代哪些决定需要你拍板。临时文件名和产物路径这类问题,可以让它先检查产物目录或代理输出,再自行处理。