把CI报告变成可持续查看的质量看板
作者在GitHub Actions末尾汇总测试、覆盖率、Lighthouse、包体积及评估报告,生成HTML看板并发布到GitHub Pages。页面采用内联SVG和本地资源,无脚本及外部请求。
AI 深度解读
CI 变绿之后,测试耗时、覆盖率、包体积这些报告去了哪里?在作者的个人项目里,它们通常躺在构建产物中,90 天后过期,几乎没人再看。
作者给 GitHub Actions 加了最后一道工序:把报告变成质量看板,再用历史数据寻找退化,让 AI 辅助解释异常、审查代码。这套实践最有参考价值的地方,是把「收集指标、发现问题、解释原因」分开处理;至于个人项目是否值得照搬,作者自己的答案也偏向否定。
先让 CI 已经知道的事情被看见
作者是 QA Engineer,项目 SprintScout 是一个根据风况安排骑行路段挑战时间的纯浏览器应用。它坚持没有服务器、账号和 API key,也不发起骑手没有主动要求的请求。质量看板沿用了这些约束。
实现集中在 packages/testing/src/dashboard.ts,最终生成一个 HTML 文件,随应用发布到 GitHub Pages。页面没有脚本,图表全部使用内联 SVG,带 role="img" 和标签,数值也保留为正文。没有图表库、CDN 或外部请求,字体放在页面旁边;历史记录则通过构建产物中的 JSON 文件传递,不需要数据库。
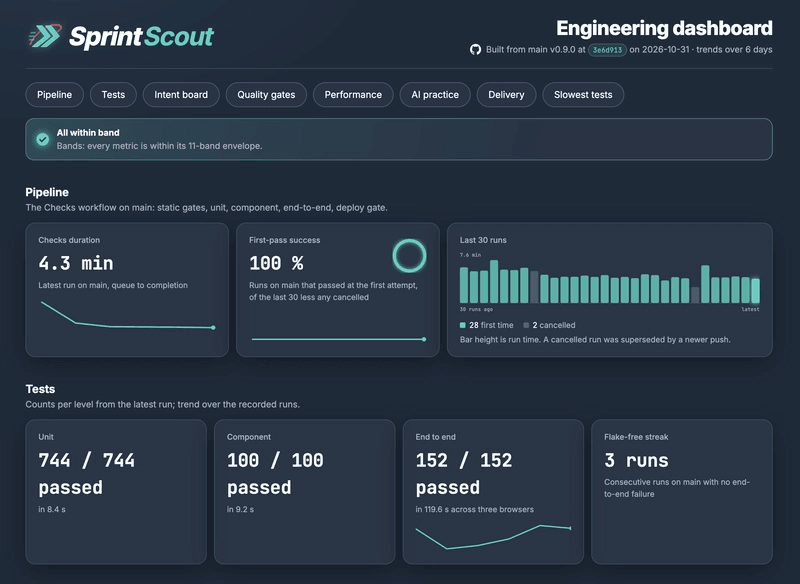
看板共有八个区域:流水线、测试、意图看板、质量门禁、性能、AI 实践、交付效率,以及最慢测试。README 徽章也复用它输出的小型 JSON 文件,供 shields.io 读取。
这些数据能放在一起,才容易看出取舍。例如,作者当时的流水线耗时为 4.5 分钟,最近 30 次运行中,24 次首次通过,6 次因更新的推送而取消,展示的首次通过率为 100%。这个数字需要连同取消次数一起读。
测试侧有 701 个单元测试,耗时 5.5 秒;96 个组件测试,耗时 9.9 秒;跨三个浏览器的 139 个端到端测试,耗时 106.8 秒。最慢的五个测试都是 WebKit 无障碍测试,但作者没有进一步解释原因。
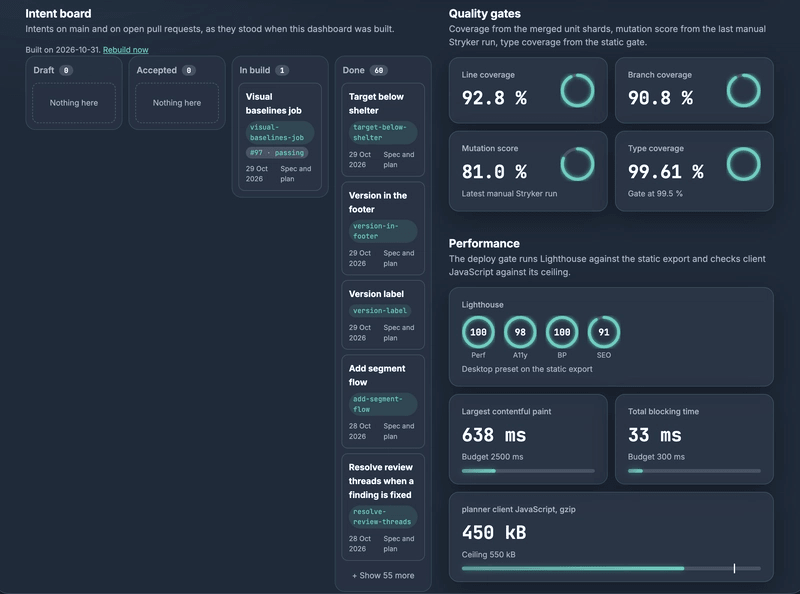
质量门禁包括行覆盖率 92.7%、分支覆盖率 90.8%、最近一次 Stryker 的变异测试得分 81.0%,以及对照 99.5% 门槛的 99.62% 类型覆盖率。变异测试会故意修改代码,检查测试能否发现错误,比单看代码有没有执行过多问了一层。
性能区域展示 Lighthouse 的 96、98、100、91 四项得分,原文没有逐项标注名称;另有 LCP 628 ms、TBT 49 ms,以及对照 550 kB 上限的 450 kB 客户端 JavaScript。
缺少报告时,卡片显示 n/a,不会把缺失值记成零,也不会因此阻止发布。PR 周期和每周合并量则从 GitHub API 获取。
固定门槛管底线,历史波动找退化
覆盖率低于 80% 很容易判断,但端到端测试连续两周每天慢四秒,固定门槛未必能及时发现。
作者为此在 YAML 中定义了 11 条波动规则。下面这一条监控端到端测试耗时,并指定数值升高属于恶化:
- id: e2e-duration
  label: End-to-end duration
  path: e2e.durationMs
  worse: higher
  unit: ms
  minSigma: 5000
要留意 minSigma: 5000:单位是毫秒,它给标准差设置了下限,避免历史数据过于平稳时,把一秒的小波动判成严重异常。
每次 main 运行都会与此前 20 天比较,计算指标在恶化方向偏离均值多少个标准差,也就是 σ:
- 达到 1σ,写入 job summary。
- 达到 2σ,在看板上标注。
- 达到 3σ,让看板任务失败,本次 GitHub Pages 不发布。
报告缺失可以降级,明确的趋势异常仍然会让流水线变红。
规则积累满五天历史才启用。若团队主动删除冗余测试,可以在同一提交里用 since 指定新的基线起点,避免一直拿旧结构作比较。
3σ 异常还可以触发 GitHub issue:模型拿到指标和上一个平稳日以来的提交,用只读工具分析可能原因,草拟工作意图。这一步会产生模型用量,因此单独设有开关。原文没有给出异常识别的准确率或误报率。
AI 可以解释和审查,但验收交给脚本
这个仓库对 AI 的依赖很深:当时 main 上 283 次提交中,有 232 次带 Claude Code 的共同作者署名。作者主要负责写意图、做取舍。
每项工作从 intent/<slug>/ 开始,依次提交 intent.md、spec.md、plan.md。意图状态包括 draft、accepted、in build、done、dropped。看板读取 main 和所有开放 PR 分支里的文件,把工作排成看板流程。
他们还为 Agent 配置编写了评估任务:收到缺陷报告时是否加载 bugfix skill,无关请求是否保持不动,修复期间 guard hook 能否阻止不同路径下的测试修改。
每个任务都让 Claude Code 使用 Sonnet,在仓库的一次性副本上运行。结果由普通脚本检查文件和运行记录,模型不负责给模型评分。每项任务还要用一个不调用模型的免费 dry run 演示朴素做法会失败;如果检查仍然通过,就说明评估没有检验出目标行为。
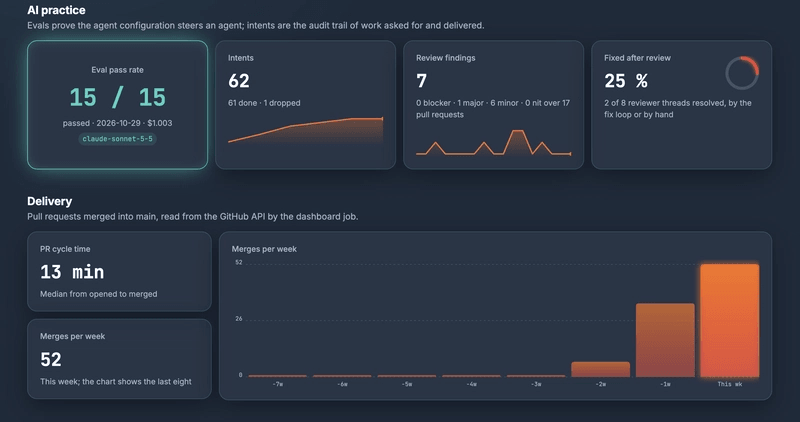
PR 审查同样由 Claude Code 作为 GitHub Action 执行,依据 REVIEW.md 和对应意图的计划留下讨论线程,跳过草稿、fork 和机器人 PR。
作者最关注的是「Fixed after review」,即审查线程被修复循环或人工处理后解决的比例。不过,线程解决并不能单独证明建议正确,还需要看实际修改。
评估、审查和异常 issue 都能通过仓库变量关闭。作者使用 claude setup-token 生成的 CLAUDE_CODE_OAUTH_TOKEN 登录,消耗 Pro/Max 订阅额度,CI 与个人使用共享限制。这里没有按量 API key,不代表没有成本。
我的判断
这套方案最值得借鉴的是职责划分:已有工具产出事实,脚本判断规则,模型补充解释。团队可以先把报告和历史趋势做起来,再决定是否加入付费分析。
但标准差不是根因分析。浏览器版本、运行环境或用例结构变化,都可能影响基线;20 天窗口、五天启用条件和 3σ 分级是否适合其他仓库,原文没有对照实验。since 能处理已知变化,也依赖维护者正确判断哪些变化应该重置基线。
原文同样没有证明,AI 审查比人工审查发现了更多有效问题,或比现有质量平台更省钱。这是一份可参考的个人项目实践。作者也承认,单人副项目投入这些机制大概并不划算,作为学习试验场才有它的价值。
能拿来做什么
- 给已有 Vitest、Playwright 和 Lighthouse 的前端仓库加一个报告汇总页,先复用 CI 产物,并明确区分报告缺失、检查失败和真实零值。
- 同时保留包体积上限等固定门禁与测试耗时趋势,先观察波动记录,再决定哪些异常值得阻止发布。
- 为日常 AI 编程中重要的 skill 和 hook 编写行为评估,用脚本验收,并构造应该失败的对照路径,检查评估是否真的有效。
- 引入 AI 审查时记录建议的处理情况、实际修复与用量成本,再判断它是否值得持续运行。