金融智能体的日志要能回答哪些审计问题
文章从风控、合规和审计的取证需求出发,提出记录智能体执行的动作、涉及的数据和授权依据。它以新加坡等地的监管动向为背景,说明可观测性记录如何为治理和控制提供可查证的证据。
AI 深度解读
当一个 AI Agent 查了客户资料、调了工具,最后给出业务建议,审计人员能查到它当时看到了什么、用了哪个模型、谁批准了下一步吗?作者把金融业的 Agent 可观测性放在这个问题上检验:一次任务能否留下足够完整、可信的记录,让风险、合规和内审人员复核,甚至质疑当时的决定。
这套思路也能帮做前端和全栈的同学判断埋点该补在哪里。页面上一个「已完成」,到了事故排查或事后复核时,往往需要拆成一串能对得上的事件。
为什么审计会追问 Agent 当时做了什么
按原文所述,新加坡金融管理局于 2026 年 10 月 7 日发布《Guidelines on Artificial Intelligence Risk Management》。指引适用于金融机构,覆盖各类 AI 技术,并明确涉及 AI Agent。治理要求从 2027 年 10 月 7 日起适用,包含生命周期控制及配套能力的其余章节分阶段落实,最迟到 2028 年 10 月 7 日。该机构还计划在 2027 年就 Agentic AI 的进一步指引征询业界意见。
原文还引用了马来西亚国家银行行长在 2026 年 7 月 8 日开幕致辞中的数据:超过 70% 的马来西亚金融服务提供商已经部署至少一种 AI 应用。这个比例涵盖各类 AI 应用。行长把 AI 提到董事会议程上,追问风险、合规和内审团队能否解释结果、质疑决策。两地信号指向相似的治理问题,具体要求仍由各机构结合所在地的规则判断。
一次 Agent 任务要留下哪些证据
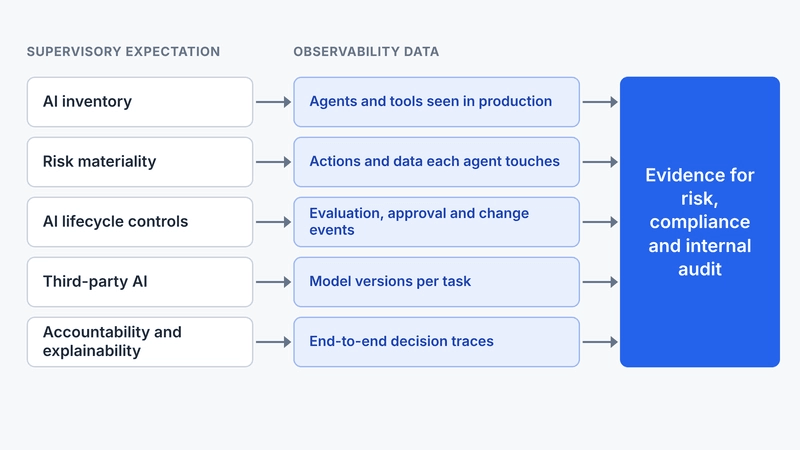
先看两份清单能不能对上。一份是机构登记的 Agent、模型和工具,另一份是生产环境里实际观察到的调用。定期比对可以发现漏登记的 Agent,也能检查某个已登记的 Agent 实际用了哪些工具。判断一个用例的风险有多大,还要看它有权调用什么、实际碰了哪些数据、多久执行一次,以及造成了什么结果。能读资料和能修改业务记录,是两种不同的权限。
对单次任务,作者要求保留端到端追踪(trace)。把输入、检索拿到的上下文、工具调用、输出和人工介入串起来,复核者才能看清某条建议依据了什么,以及人在哪一步批准或改写了结果。把多次任务放在一起,历次评估结果、版本和配置变更、质量指标又能帮助团队检查行为何时发生偏移。用了第三方模型,还要能查到哪次任务由哪个模型版本处理,供应商更新前后的行为有什么变化。机构仍对投入使用的第三方 AI 负责。
日志要满足什么条件,才能交给审计复核
记录首先要覆盖任务全程,还要有明确来源和防篡改保护。否则复核者即使看到一串事件,也难以确认记录从哪里来、事后有没有被改过。提示词和输出可能带有个人信息,采集时就要考虑脱敏,留存期限和读取权限也要符合机构政策。碰到数据驻留要求,还得沿着采集、传输和存储路径检查遥测数据去了哪里。
所以选平台时,作者建议现场看它能不能展示完整任务链路,能否按策略配置留存、脱敏和访问控制。私有部署或混合部署是否满足数据驻留要求,平台是否支持开放标准、能否接入现有审计和治理流程,也都要逐项看。作者披露自己供职于 Bonree,并举自家的 Bonree ONE 为例,称它可采集基于 LangChain、LangGraph、Dify 和 OpenClaw 的 AI 应用追踪及用量数据。材料能否满足具体审计要求,仍由机构评估。
我的判断
我认同先从复核问题倒推采集字段。靠手工登记,可以知道团队申报了什么。靠应用日志,可以排查某个接口或工具为什么失败。要查一次跨模型、检索、工具和人工审批的任务,就得把这些事件按同一个任务串起来。已有日志系统如果能做到这一点,并满足留存、脱敏、权限和完整性要求,也可以承载这条链路。
原文没给出实际审计样本、采集覆盖率,也没给出 Bonree ONE 与现有日志方案的对照数据。平台选型部分属于经验建议。用遥测反查台账也有个前提,采集得覆盖相关的生产入口。某个 Agent 没出现在记录里,可能是从未运行,也可能是调用绕开了采集点。至于哪些动作允许交给 Agent、哪些必须人工审批、出了问题由谁负责,仍要由机构自己定。
能拿来做什么
- 给 Node 服务里的每次 Agent 任务生成同一个任务 ID,把模型调用、检索、工具执行和前端触发的人工审批串起来。挑一条测试任务,检查能否从最终结果追到当时的输入、工具和审批人。
- 维护一份 Agent、模型和工具的台账,再拿生产调用记录定期核对。发现差异时顺手查采集入口,区分登记遗漏和埋点遗漏。
- 给提示词、检索结果和输出定义允许采集的字段,并在写入前做脱敏。用含模拟敏感信息的任务检查记录是否既能支撑复核,也遵守字段访问和留存策略。
- 升级第三方模型或修改 Agent 配置时,把变更前后的评估结果关联到各自的版本和配置。供应商只暴露模型别名时,按实际可见的信息记录,把版本是否可追溯留作评估项。