Agent 跨会话记忆如何设计与落地
介绍 AI Agent 的短期与长期记忆架构,以及生产环境中的状态管理。结合 n8n 与 Cognee,展示保留上下文、共享知识和跨会话积累信息的工作流。
AI 深度解读
LLM 不会自动记住上一次调用。客服追问、跨天执行的工作流、持续协作的编程助手,能否接着上次的进度做事,靠的是模型外部的状态管理。这篇 n8n 文章的核心判断是:Agent 的记忆能力,取决于系统如何保存、更新和找回信息。
它的价值在于把「接上聊天记录」与「长期可用的记忆」分开讨论,并给出 n8n 的两种接入方式。不过,文章最后落到了 n8n 与 Cognee 的组合方案,架构思路和产品推荐需要分开看。
记住对话,为什么还不等于拥有长期记忆
每次 LLM 请求,模型只读取本次收到的输入。所谓 Agent 记得用户偏好,是应用先保存了这些信息,再在后续调用前找回来,放进提示词。
记忆改变的是提示词的组装方式。
一次请求可以同时包含新消息、当前会话记录,以及与任务有关的长期记忆。模型看起来能够延续之前的工作,是外部系统替它完成了这些准备。
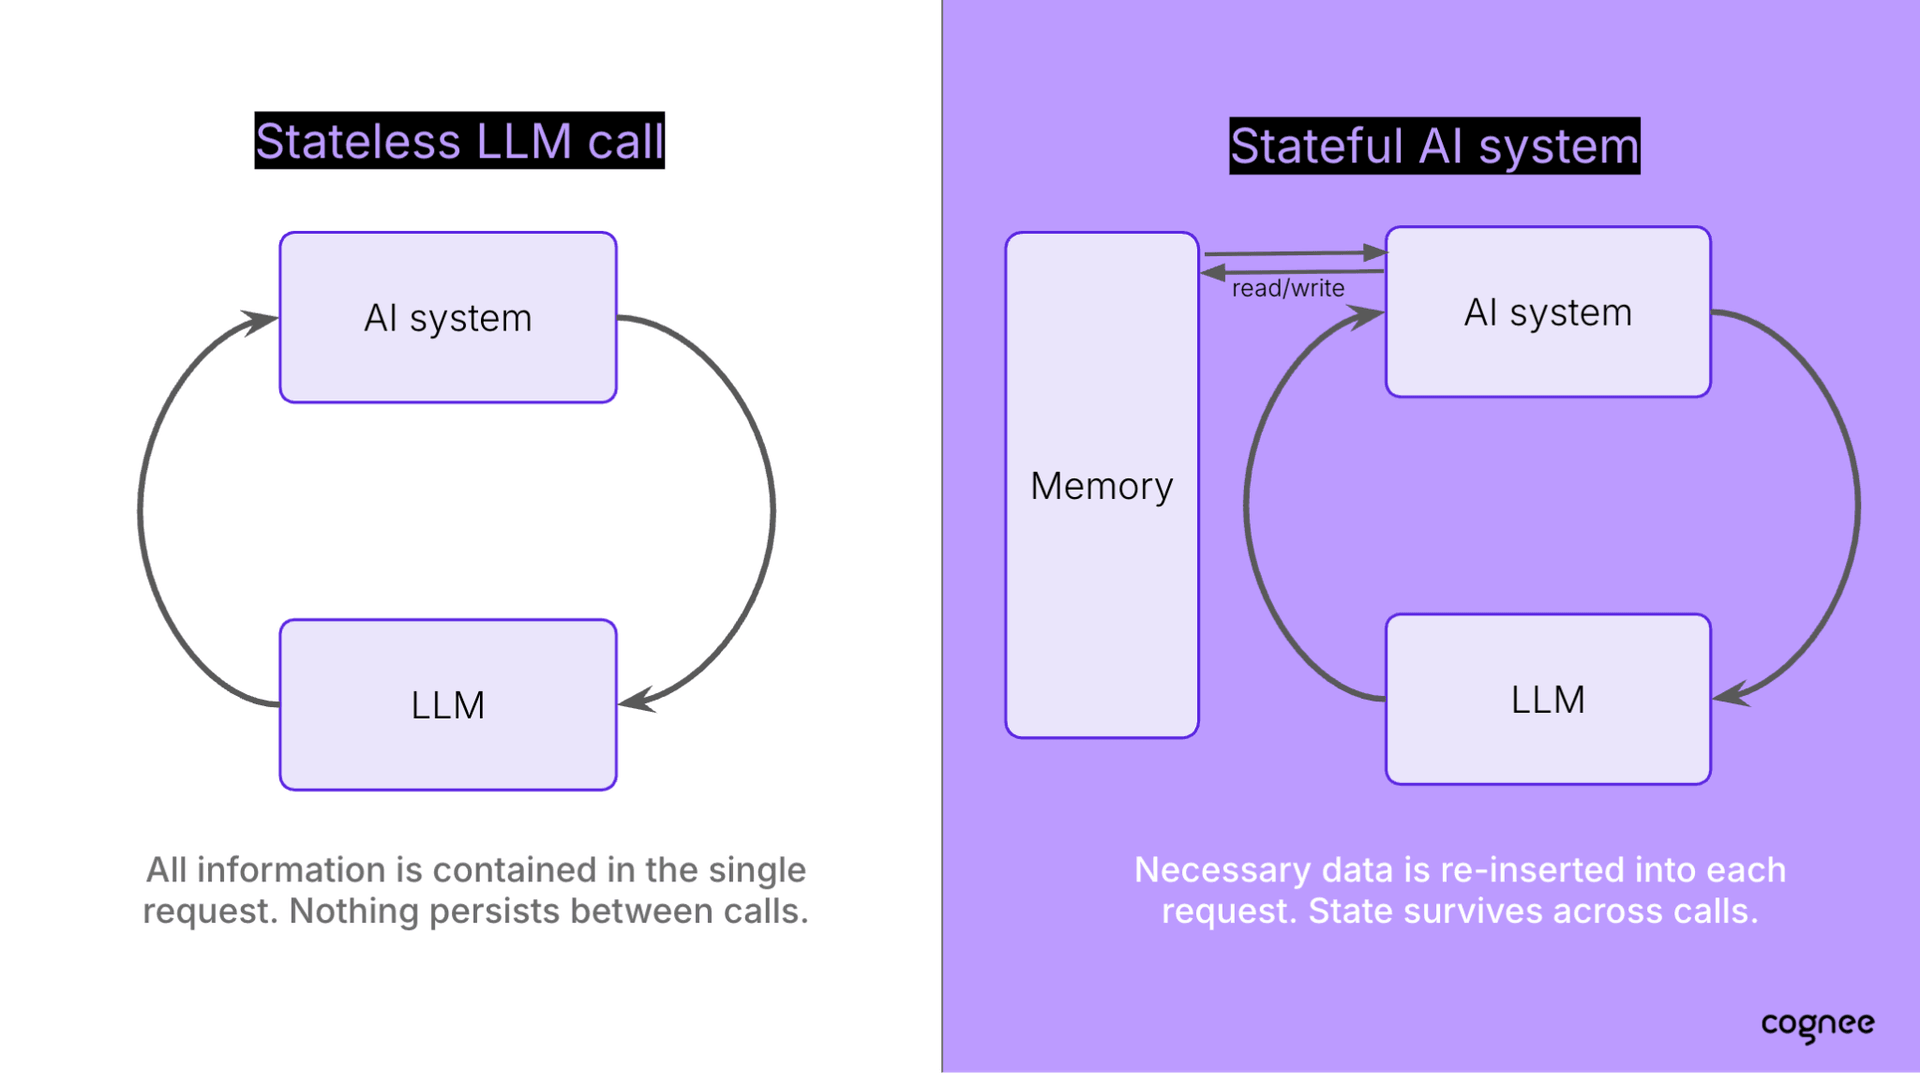
短期记忆负责眼前的任务,包括最近的消息、工具输出和执行状态。上下文窗口装不下时,可以把历史压缩成摘要,但摘要会丢细节。中间稿、昂贵计算的结果,也不适合只留一个概括。
长期记忆则要跨会话保存用户偏好、任务结果、过去有效或无效的做法,以及文档、工单、CRM 记录。这里需要的不只是存储,还得决定保留什么、如何组织、何时取回。
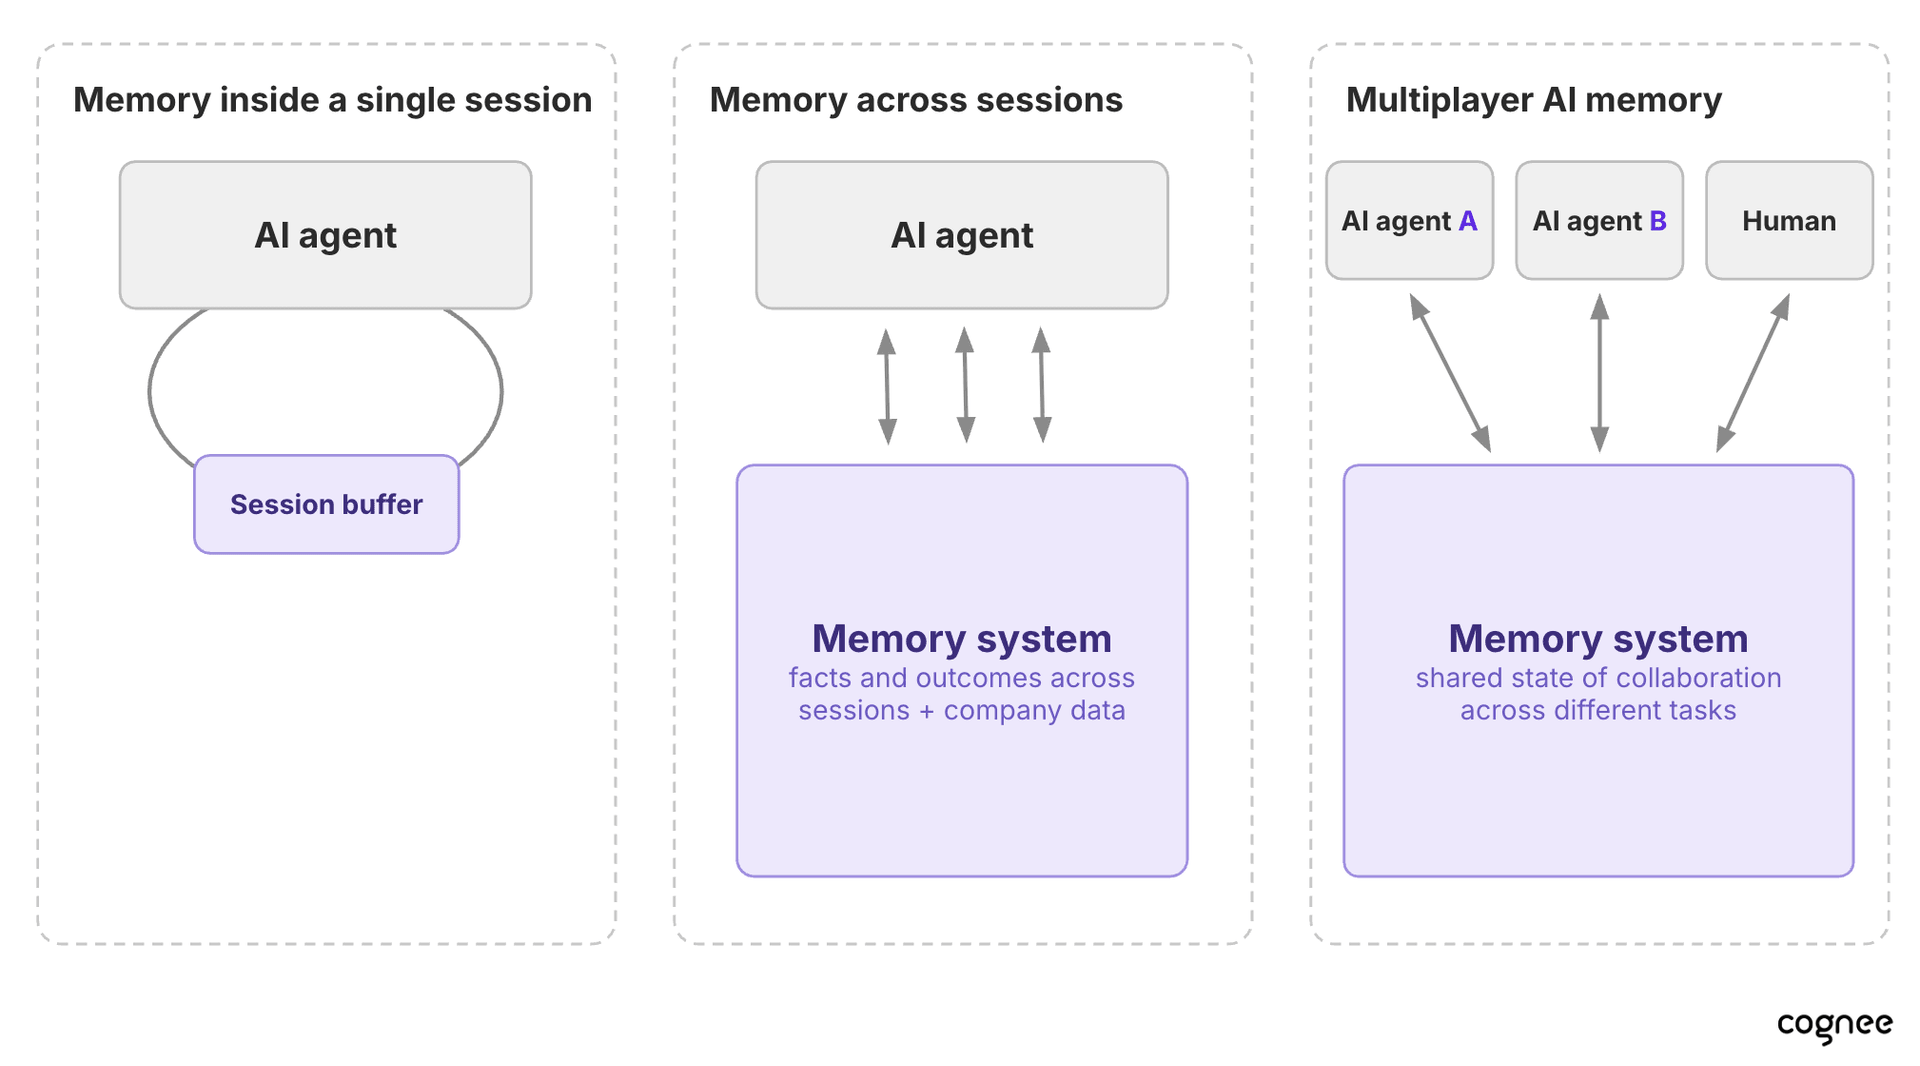
文章还区分了几个容易混用的概念:
- 模型权重里的知识来自训练或微调,是模型学到的模式,不能自动吸收当前会话。
- 上下文工程(Context Engineering)负责挑选本次调用的输入。窗口再大,也不负责跨会话持久化。
- RAG 从文档、数据库或 API 取出已有知识,用来支持回答。
- Agent memory 还包含写回,把新偏好、新事实和任务结果保存下来,供以后调用。
例如,销售助手通过 RAG 查询本季度业绩,通过记忆得知用户希望欧洲数据以欧元展示,并按国家拆分。两者可以协作,解决的问题不同。
选数据库之前,先想清楚怎么更新和遗忘
原文把记忆系统拆成三个部分:持久化存储、写入逻辑和检索接口。只选一个数据库,后两部分不会自动出现。
向量数据库通过嵌入向量(Embedding)做语义检索,上手容易,但语义接近不代表事实正确。Q3 sales 和 Q4 sales 可能非常相似,系统仍需识别季度、时间和当前有效版本。
纯文件方案,例如 MEMORY.md,透明、便于版本管理,也适合编码 Agent。局限是检索通常依赖全文加载或 grep,多个 Agent 共同修改时,维护会变复杂。
知识图谱把事实组织成实体与关系。找到销售报告后,可以沿关系继续找到欧洲订单、计价货币和账单来源。它更适合回答有关联的问题,代价是写入时需要做更多结构化处理。
混合方案则按数据特点分工:精确 ID 用结构化索引,关系用图,模糊匹配用向量,历史问题依赖时间信息。覆盖面更广,组件和维护成本也更多。
存得越来越多,不代表记得越来越准。
文章提出三项持续管理工作。首先是归并,把零散记录整理成更少、更有用的摘要或事实,同时保留原始来源。其次是更新,事实变化时保留时间与历史,避免覆盖后无法回答「三月时是什么情况」。最后是遗忘,过期数据、纠错记录和删除请求,都应有明确处理方式,不能只降低检索权重。
文章还建议利用反馈调整记忆权重:答案被确认,相关记忆增加权重;答案被纠正,误导性记忆降低权重。但它没有给出具体算法,也没有展示这种机制长期运行的对照结果。
n8n 的两个接入口,分别解决什么问题
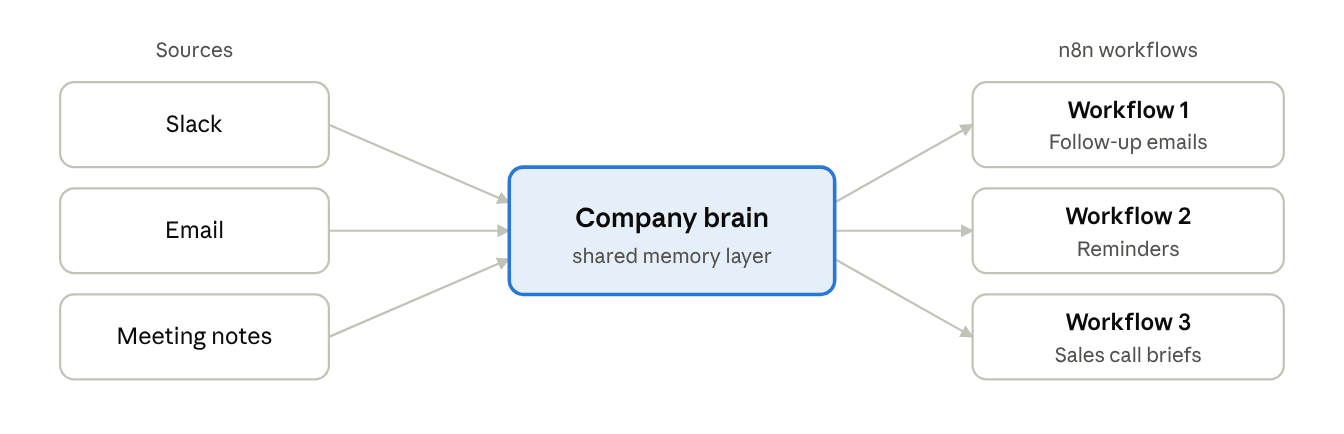
第一种方式是在工作流外建立共享记忆。
采集工作流监听已关闭工单、通话摘要、表单提交等事件,把新内容送进记忆层;执行工作流则在回复客户、分派升级请求或准备销售材料之前,查询同一份记忆。
这样,周三收到追问的工作流,就有机会查到周一提出过什么修复方案。多个工作流也能共享客户状态和承诺,而不必各自维护一套背景资料。
第二种方式是在单个 n8n AI Agent 内连接记忆。
Memory port 用于接入会话记忆。默认的 Simple Memory 保存当前会话中可配置长度的聊天历史,适合作为起点,也可以换成其他提供方。
长期知识则通过 Tool port 接入外部记忆层。Agent 在任务中按需调用工具,查询公司知识或保存新的信息。
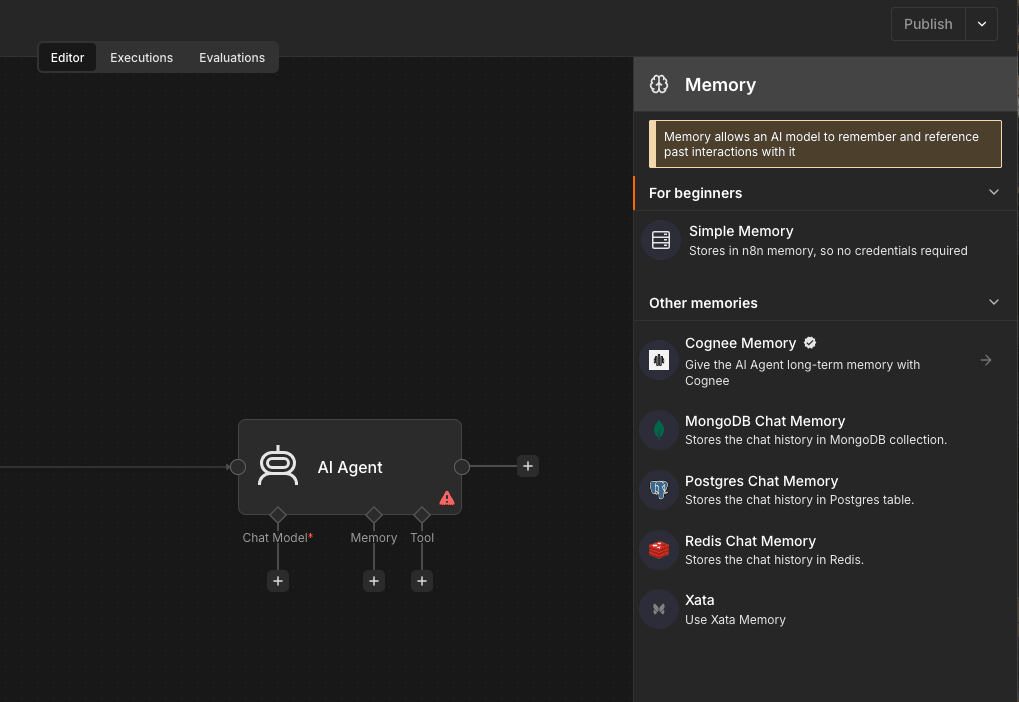
两者的区别很实际:聊天记录让 Agent 接得上当前对话,共享记忆让它找到其他会话、其他工作流积累的信息。
但接上工具,只提供了读写入口。哪些信息值得写入、什么时候必须检索、冲突如何处理,仍要靠系统设计。原文没有展开这些策略,也没有提供可直接复用的工作流配置或代码。
我的判断
文章最有用的地方,是把 Agent memory 还原成应用架构问题。用户偏好、任务结果和历史状态需要持久化,这对前端、Node 开发者并不陌生。新增的难点是:自然语言信息不够规整,而且每次都要挑出一小部分送给模型。
不过,原文对 RAG「只读不写」的划分更适合作为理解概念的边界。检索增强本身不负责记忆写入,但具体应用完全可以在 RAG 外围增加写入、更新和删除流程,不能据此认定采用 RAG 的系统无法演化。
共享「公司大脑」也有前提。把 Slack、工单和 CRM 内容汇到一起后,来源权限、租户隔离、重复记录和冲突事实都会成为问题。文章没有解释这些边界,不能把集中存储直接等同于所有 Agent 都能放心使用。
评测部分则需要保留原文的归属。文章列出:LoCoMo 对话约 26k tokens,LongMemEval 常见变体约 115k,BEAM 测试十种记忆能力,对话最长达 10M tokens。它报告 Cognee 在 BEAM 的 100K tokens 和 10M tokens 条件下分别达到 79% 和 67%,此前最好结果为 73.4% 和 64.1%。
这些是原文报告的成绩。所给内容没有展开模型配置、成本、延迟和复现细节,不能据此判断 Cognee 对一般团队就是最优选择。
作者关于评测规模的提醒是成立的:如果整段历史能塞进上下文,测试就未必充分检验外部记忆。但长上下文也不保证准确,埋在输入中间的细节仍可能被忽略。
相比直接引入图谱或混合记忆层,已有的 Postgres 表、聊天记录和明确查询条件,仍可能满足简单业务。原文没有提供这些方案之间的完整对照,其架构取舍有合理解释,产品优劣仍需自行验证。
能拿来做什么
- 为前端或 Node 聊天应用分开定义会话状态与长期记录。先列出需要跨会话保留的偏好、任务结果和失败方案,再决定存储结构,避免把全部聊天历史都当作长期记忆。
- 使用
MEMORY.md辅助 AI 编程时,优先记录稳定约定、已确认结论和失败尝试,并保留必要的时间与来源。完整中间稿、昂贵计算结果应单独保存,避免摘要丢失关键细节。 - 在 n8n 中先验证单个闭环:一次执行保存工单处理结果,下一次追问能够准确取回。当前对话接
Memory port,跨执行知识通过Tool port查询,再逐步扩展共享范围。 - 用同一批任务比较开启和关闭记忆后的结果,观察重复提问、跟进准确率或工单解决情况,同时记录成本与延迟。优先证明记忆改善了自己的业务,再决定是否增加图谱和混合存储。