30 秒速记
- 导航、资源、用户标记分别对应性能条目
- 新采集用导航条目,别依赖旧
performance.timing PerformanceObserver持续观察新增数据- 自定义流程用
mark/measure - 回调频率、内存接口都有支持与解释边界
Performance API 提供的是时间证据,帮助把等待拆成具体阶段。 导航条目看页面加载,资源条目看图片和脚本,自定义标记可以测量提交到完成等业务过程。持续变化的数据适合用观察器收集,不必全部等页面加载结束。跨域详细时序受权限限制,动画回调间隔也不等于完整的实际呈现质量,采集后仍要结合场景解释。
版本校准: 原理文章中的代码代表特定实现与写作时间。应用到当前项目时,应先确认浏览器、框架或工具的主版本,再区分稳定的规范语义、可变化的内部实现和项目自身约束。
Performance 提供导航、资源和用户计时等条目。新采集优先读取 PerformanceNavigationTiming、PerformanceResourceTiming,再用 PerformanceObserver 监听需要的条目,不必统一等到 load 才开始。
function reportNavigation() {
  const nav = performance.getEntriesByType('navigation')[0]
  if (!nav) return
  console.table({
    ttfb: nav.responseStart - nav.startTime,
    download: nav.responseEnd - nav.responseStart,
    domReady: nav.domContentLoadedEventEnd - nav.startTime,
    load: nav.loadEventEnd > 0 ? nav.loadEventEnd - nav.startTime : null
  })
}
// 延后一项任务,避免在 load 回调内部把尚未确定的 loadEventEnd 当成最终值
if (document.readyState === 'complete') setTimeout(reportNavigation, 0)
else window.addEventListener('load', () => setTimeout(reportNavigation, 0), { once: true })

const observer = new PerformanceObserver(list => {
  for (const entry of list.getEntries()) {
    console.log(entry.name, entry.duration)
  }
})
observer.observe({ type: 'resource', buffered: true })
// 停止采集时调用 observer.disconnect()
导航条目描述一次文档加载,单页应用后续路由切换要另行标记。跨源资源的详细阶段可能受 Timing-Allow-Origin 限制,零值不能一律理解成没有成本。导航与资源计时指南说明了条目和旧接口的区别。
# 一、回顾页面加载过程
要学习这套
API的使用,先简单介绍下前端的基础知识
# 1.1 页面加载
一个页面的请求到响应再到显示出来,需要经过下面一些重要过程,当我们在浏览器输入一个
URL或者说点击一个URL开始,会出现如下流程
- 页面准备
- 重定向:在
header定义了重定向才会有这个过程,如果没有重定向,不会产生这个过程。 - 缓存与拦截:浏览器缓存或
Service Worker可能直接提供响应,是否走网络取决于实际策略。已淘汰的AppCache不属于现代页面的通用流程。 DNS解析:把域名解析成IP,如果直接用ip地址访问,不产生这个过程。- 连接:连接可能复用;
HTTP/1.1、HTTP/2常使用TCP,HTTP/3使用QUIC,不能假定每次请求都新建TCP连接。 request header:请求头信息。request body:请求体信息,比如get请求是没有请求体信息的,所以没有这个过程,这就是为什么把头跟体分开写的原因。response header:响应头信息。response body:响应体信息。- 解析
HTML结构 - 加载外部脚本和样式表文件:正常来说
JS、css都是外部加载的,当然有不正常的人啊,比如我。 - 解析并执行脚本代码
- 构建与解析
HTML DOM树:这个过程可以去了解下DOM树是怎样的就明白啦。 - 加载外部图片
- 页面加载完成,显示出来啦
# 1.2 重定向分析
重定向会增加一次响应判断及后续获取过程,但下一跳是否重新解析、建连要看地址与连接复用情况。跨源跳转还可能限制可见的详细计时,使用导航条目的重定向字段时要同时检查数据访问条件。
# 二、performance
# 2.1 performance.timing
performance.timing是已废弃的旧接口,保留这组字段便于阅读历史监控代码。新代码使用上面的导航条目;旧接口采用纪元时间,不能和相对时间戳直接相减。
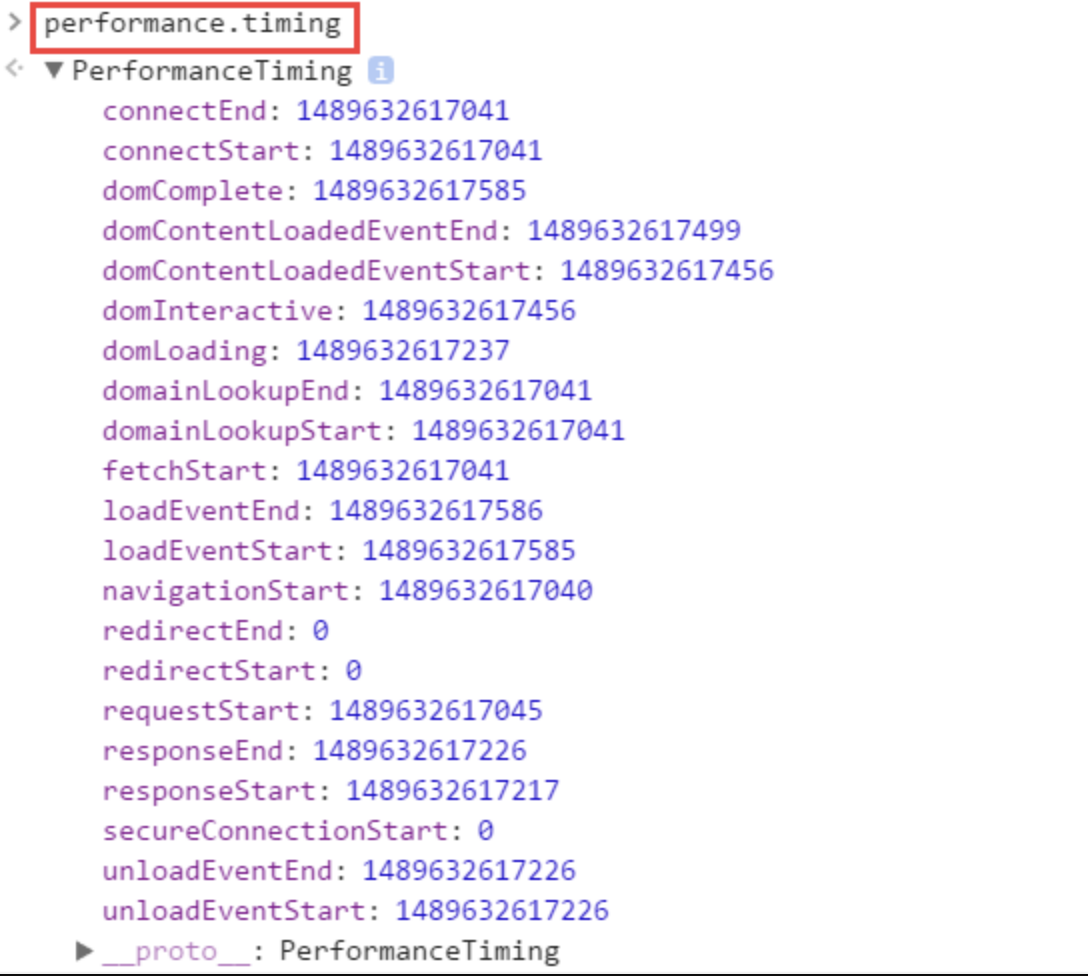
先解释下这些时间都是代表什么
timing 对象里边的数据比较多,梳理如下几个关键性的节点
fetchStart:发起获取当前文档的时间点,我的理解是浏览器收到发起页面请求的时间点;domainLookupStart:返回浏览器开始DNS查询的时间,如果此请求没有DNS查询过程,如长连接、资源cache、甚至是本地资源等,那么就返回fetchStart的值;domainLookupEnd:返回浏览器结束DNS查询的时间,如果没有DNS查询过程,同上;connectStart:浏览器向服务器请求文档,开始建立连接的时间,如果此连接是一个长连接,或者无需与服务器连接(命中缓存),则返回domainLookupEnd的值;connectEnd:浏览器向服务器请求文档,建立连接成功的时间;requestStart:开始请求文档的时间(注意没有requestEnd);responseStart:浏览器开始接收第一个字节数据的时间,数据可能来自于服务器、缓存、或本地资源;unloadEventStart:卸载上一个文档开始的时间;unloadEventEnd:卸载上一个文档结束的时间;domLoading:浏览器把document.readyState设置为“loading”的时间点,开始构建dom树的时间点;responseEnd:浏览器接收最后一个字节数据的时间,或连接被关闭的时间;domInteractive:浏览器把document.readyState设置为“interactive”的时间点,DOM树创建结束;domContentLoadedEventStart:文档发生DOMContentLoaded事件的时间;domContentLoadedEventEnd:文档的DOMContentLoaded事件结束的时间;domComplete:浏览器把document.readyState设置为“complete”的时间点;loadEventStart:文档触发load事件的时间;loadEventEnd:文档出发load事件结束后的时间
再来一张图,表示各阶段的开始与结束对应的时间
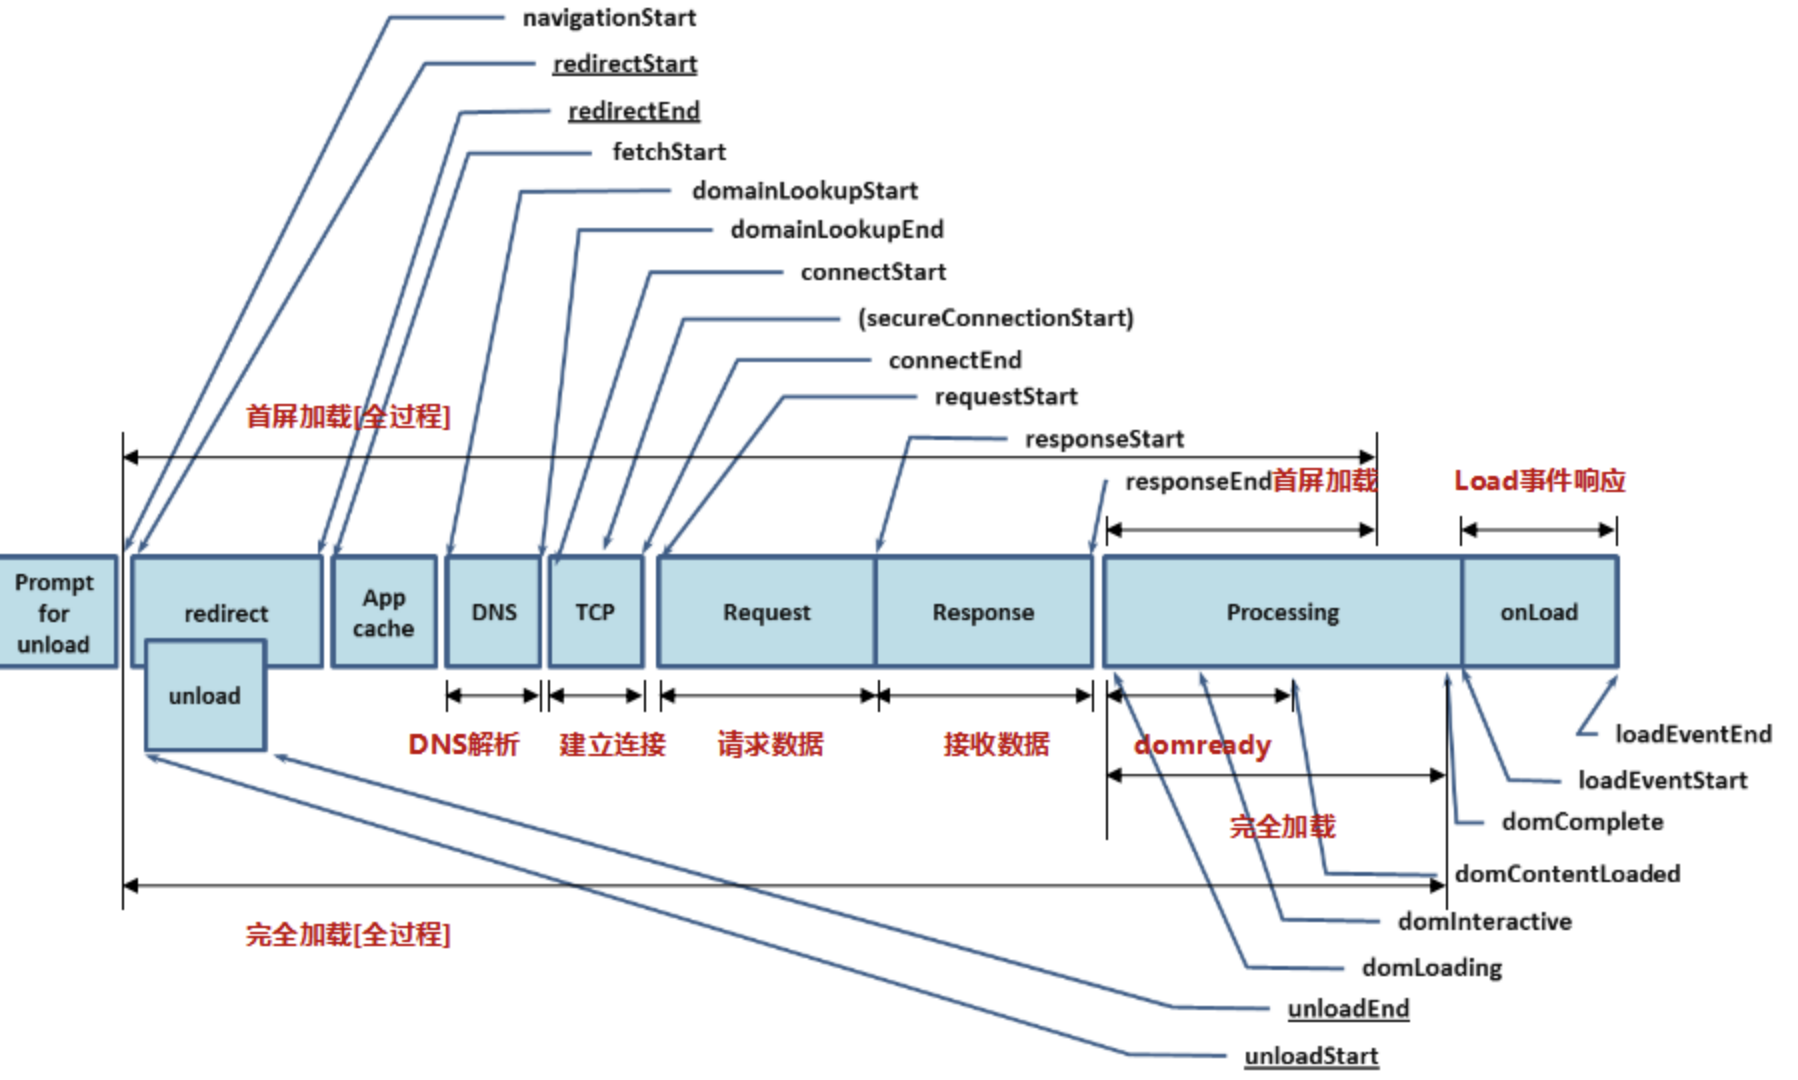
从以上的分析,我们就可以得到一些时间的计算
- 准备新页面耗时:
fetchStart - navigationStart - 重定向时间:
redirectEnd - redirectStart domainLookupStart - fetchStart不能简单归因于缓存查询,阶段差值需要结合实际请求路径解释。DNS解析时间:domainLookupEnd -domainLookupStartTCP连接时间:connectEnd - connectStartrequest时间:responseEnd - requestStart这个计算是代表请求响应加起来的时间- 请求完毕到
DOM树加载:domInteractive -responseEnd - 构建与解析
DOM树,加载资源时间:domComplete - domInteractive load时间:loadEventEnd - loadEventStart- 整个页面加载时间:
loadEventEnd -navigationStart - 首字节等待:
responseStart - navigationStart;它不等于白屏结束,首次绘制要结合绘制条目或业务标记衡量。
# 2.2 performance.getEntries()
performance.getEntries()返回多种性能条目;只采集资源时可使用performance.getEntriesByType("resource"),持续观察则使用PerformanceObserver。
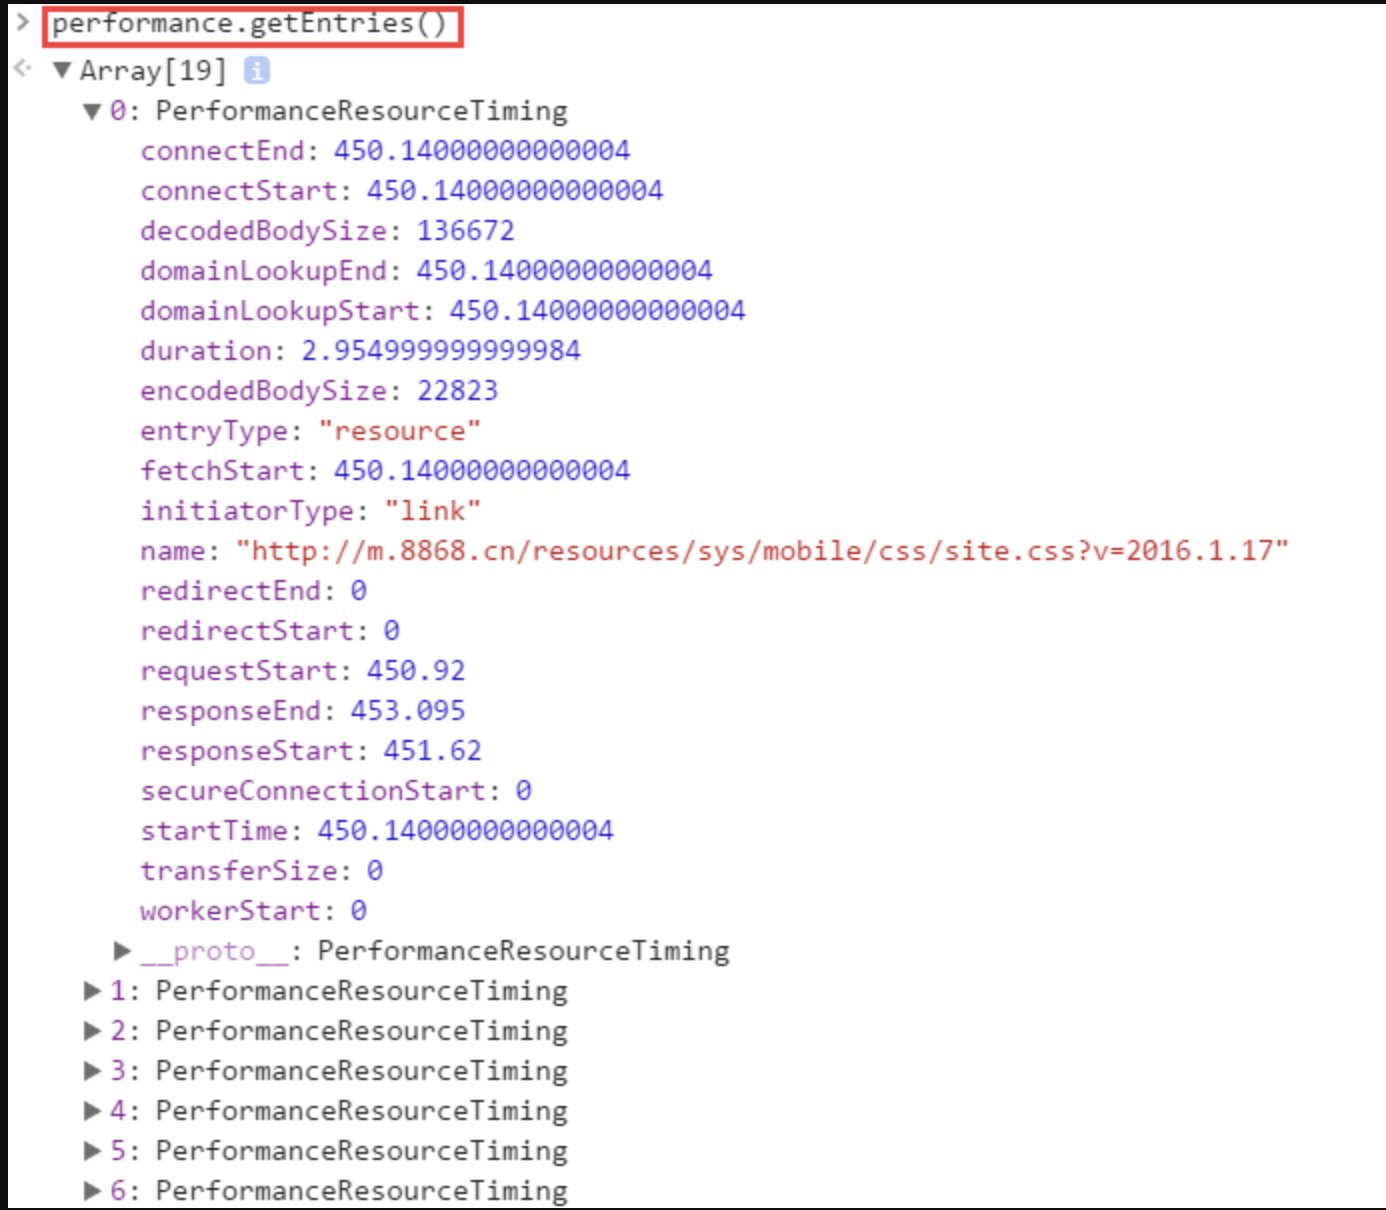
如上图可以看到这个API请求返回的是一个数组,这个数组包含仍在性能缓冲区中的条目,不保证覆盖无限数量的全部资源,上图打开了一个其中一个资源,可以看到如下信息
entryType:类型为resourcename:资源的urlinitiatorType:资源是link- 资源时间:
duration的值,是responseEnd - startTime得到的