

HTTP报文篇|博客系列
# 1. HTTP报文概念
概念:是HTTP通信中的基本单位,由8位组字节流组成。
# 2. HTTP报文整体结构
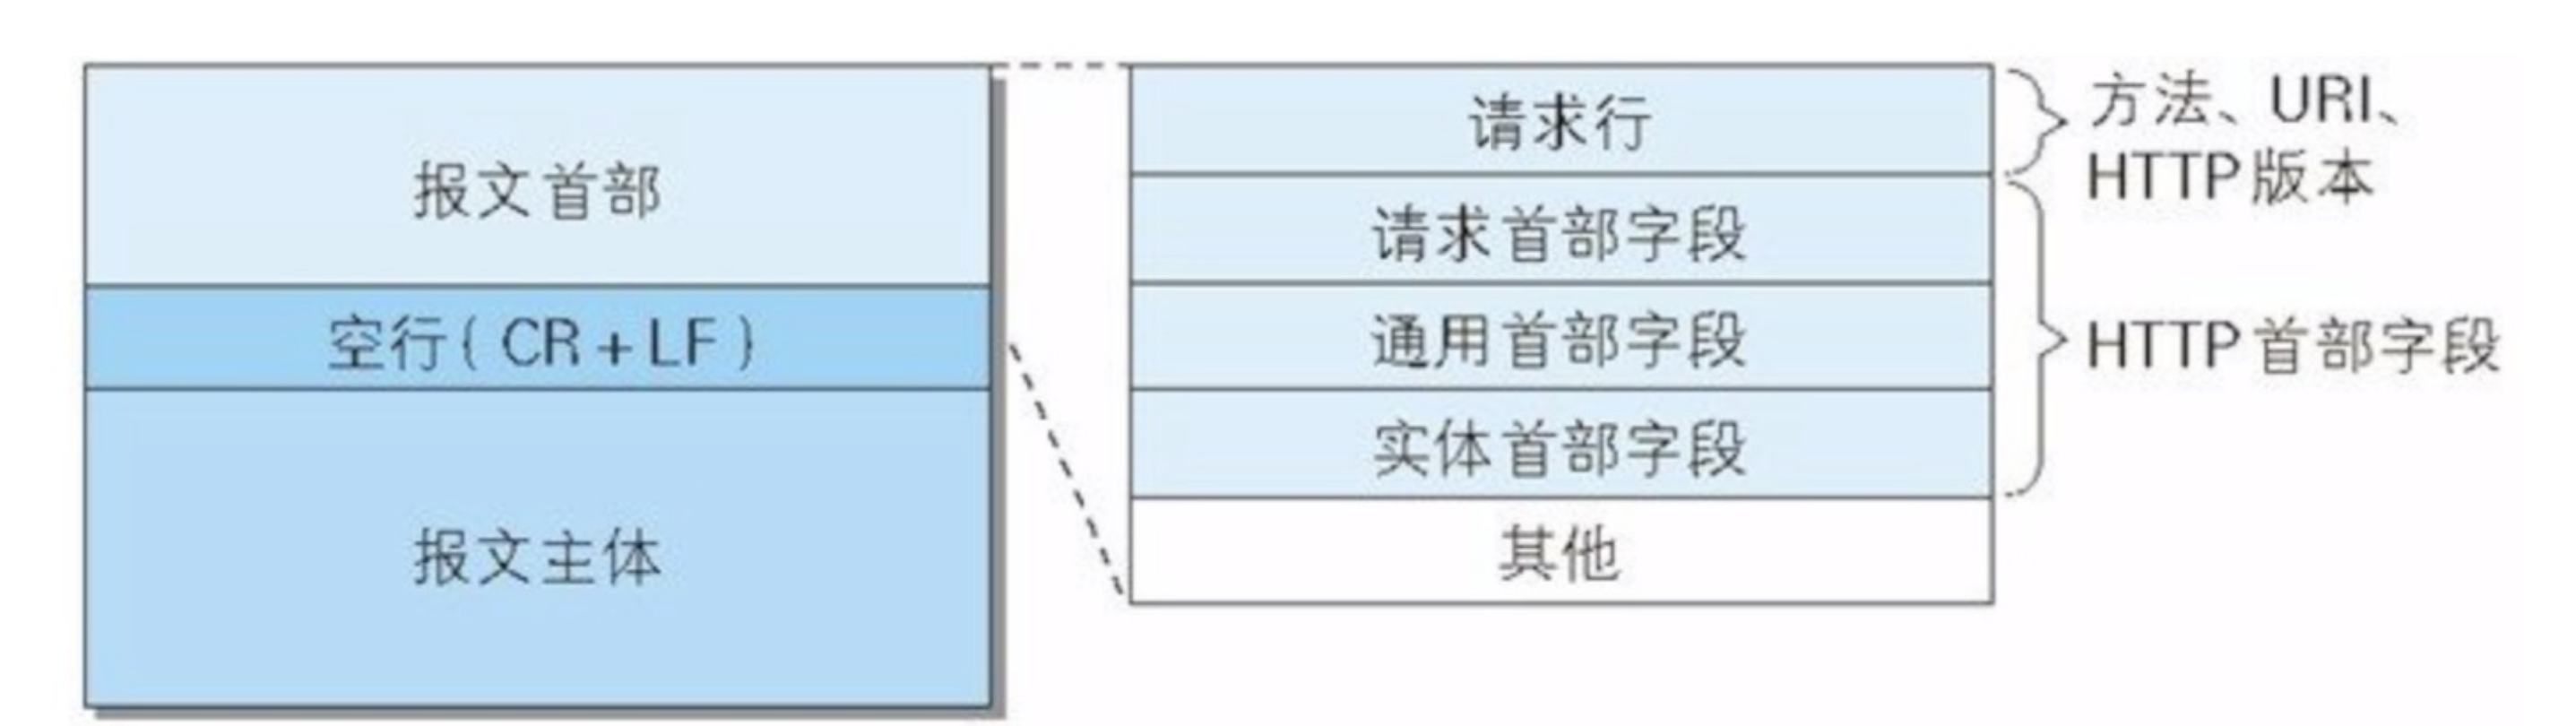
整体结构:报文首部 + 空行 + 报文实体
有些地方会写为(这样也可以):起始行 + 首部字段 + 空行 + 报文实体
(首部也就是头部)
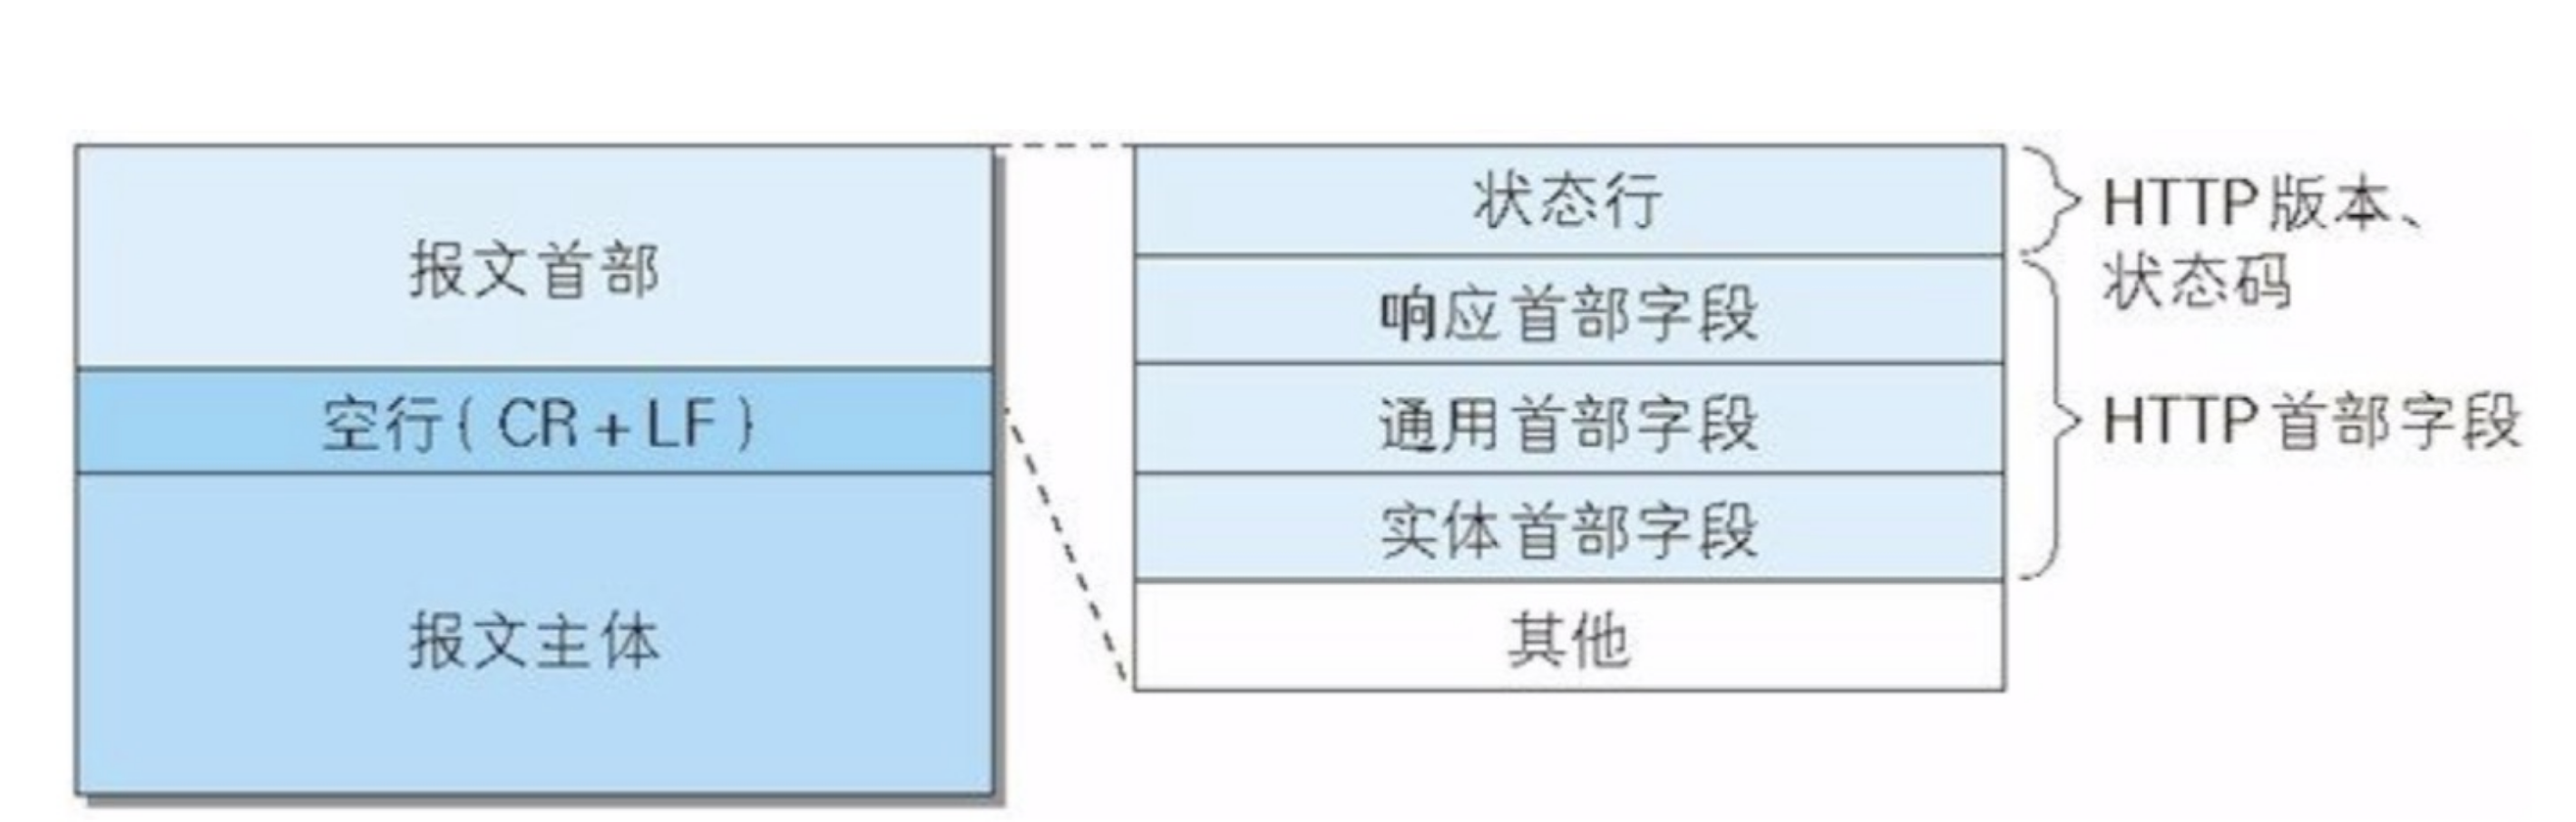
另外对于请求报文和响应报文,它们主要是报文首部不同:
请求报文:
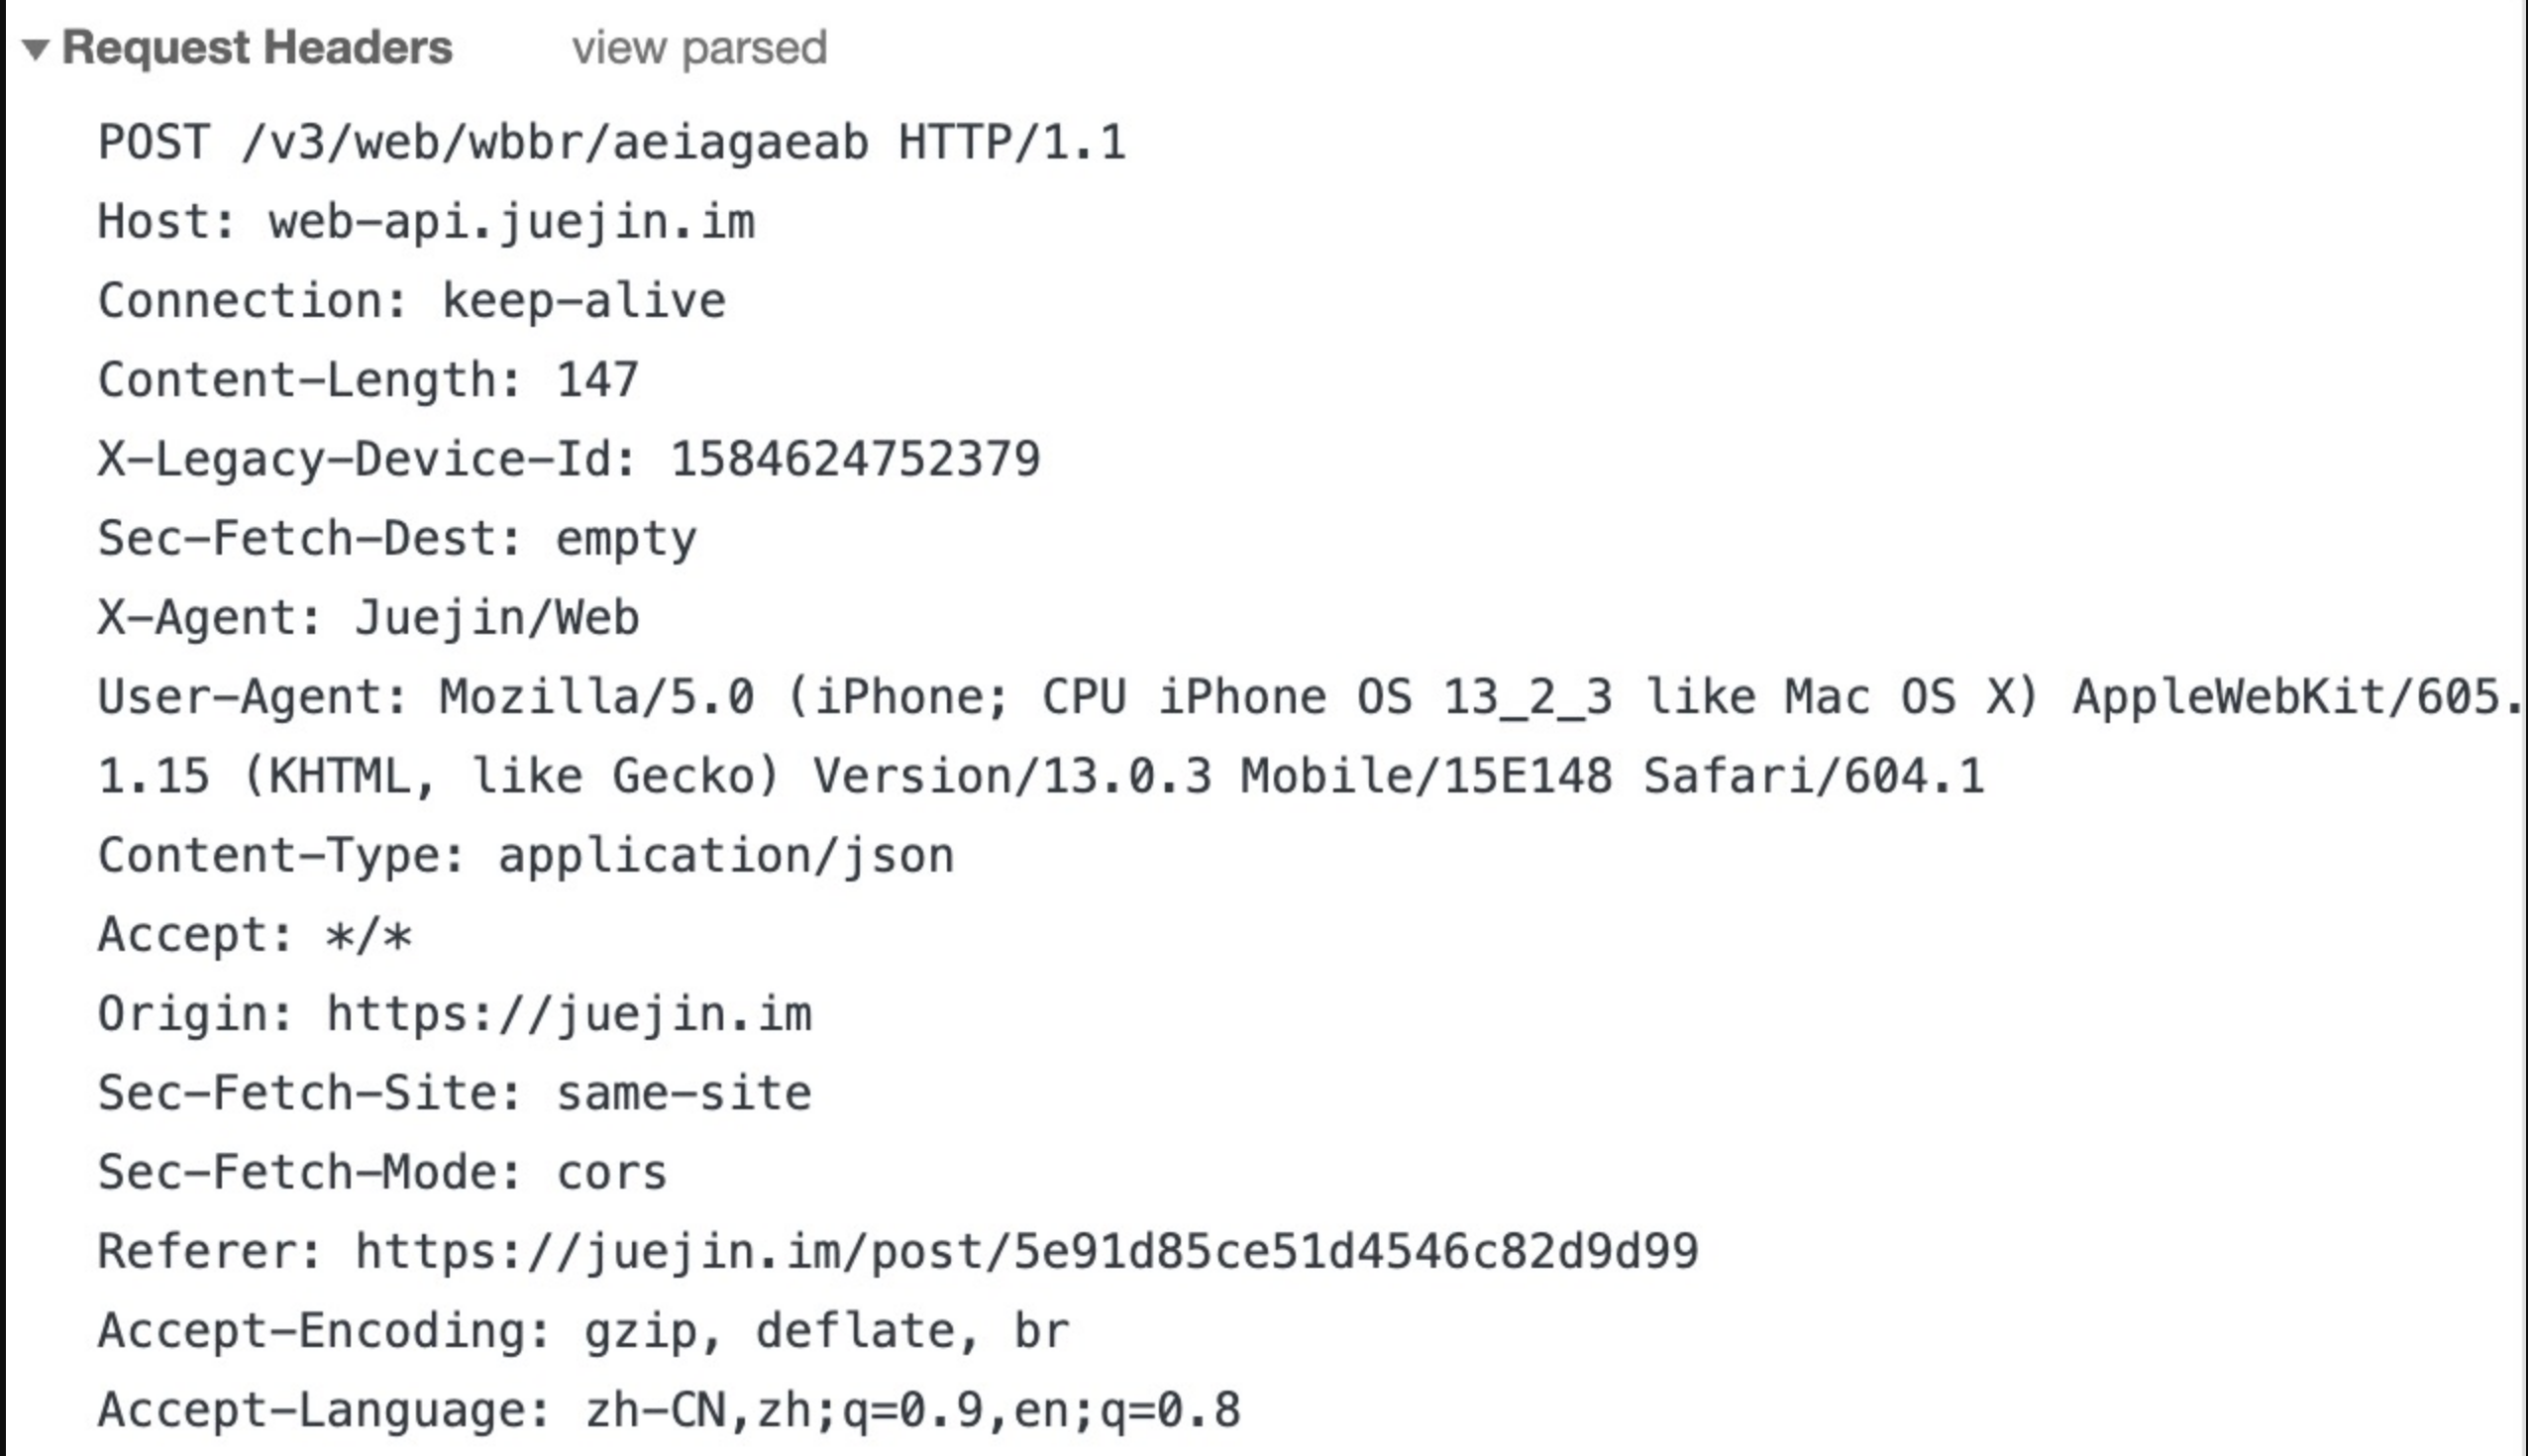
真实例子:
响应报文:
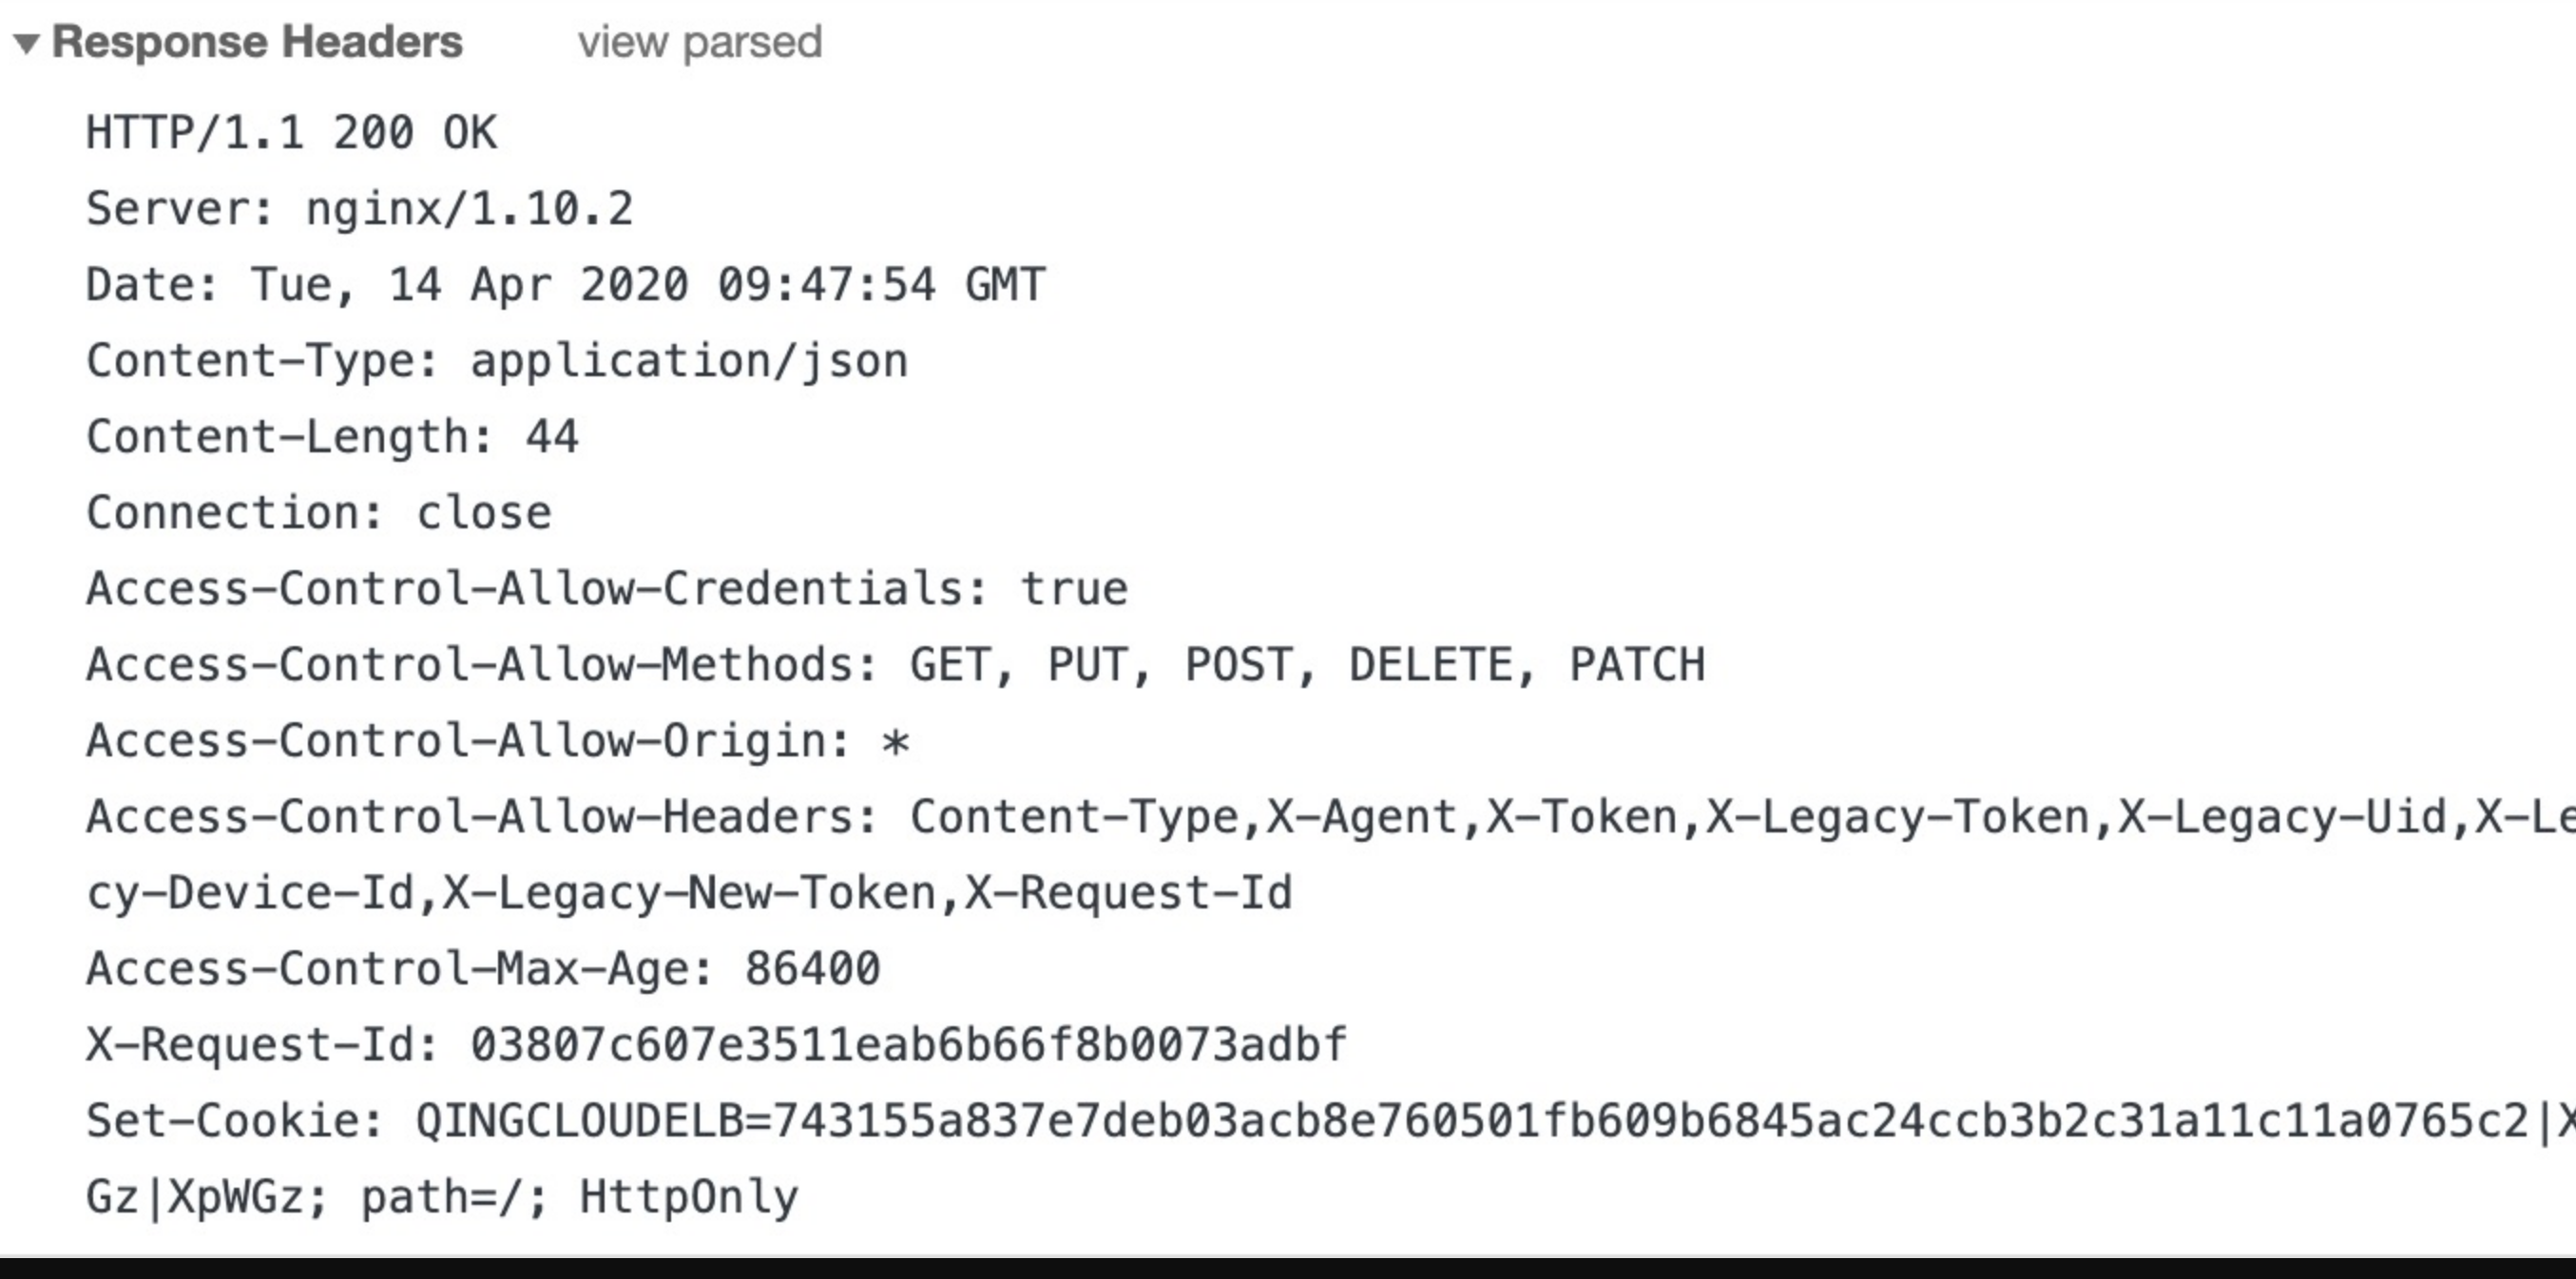
真实例子:
# 3. HTTP报文组成
上面👆介绍了一下HTTP报文的整体结构,这里主要是做一下细分。
HTTP报文的整体是:报文首部 + 空行 + 报文实体
不过因为:报文首部 = 起始行 + 首部字段,其实起始行也挺重要的,所以我就分为两部分说了。
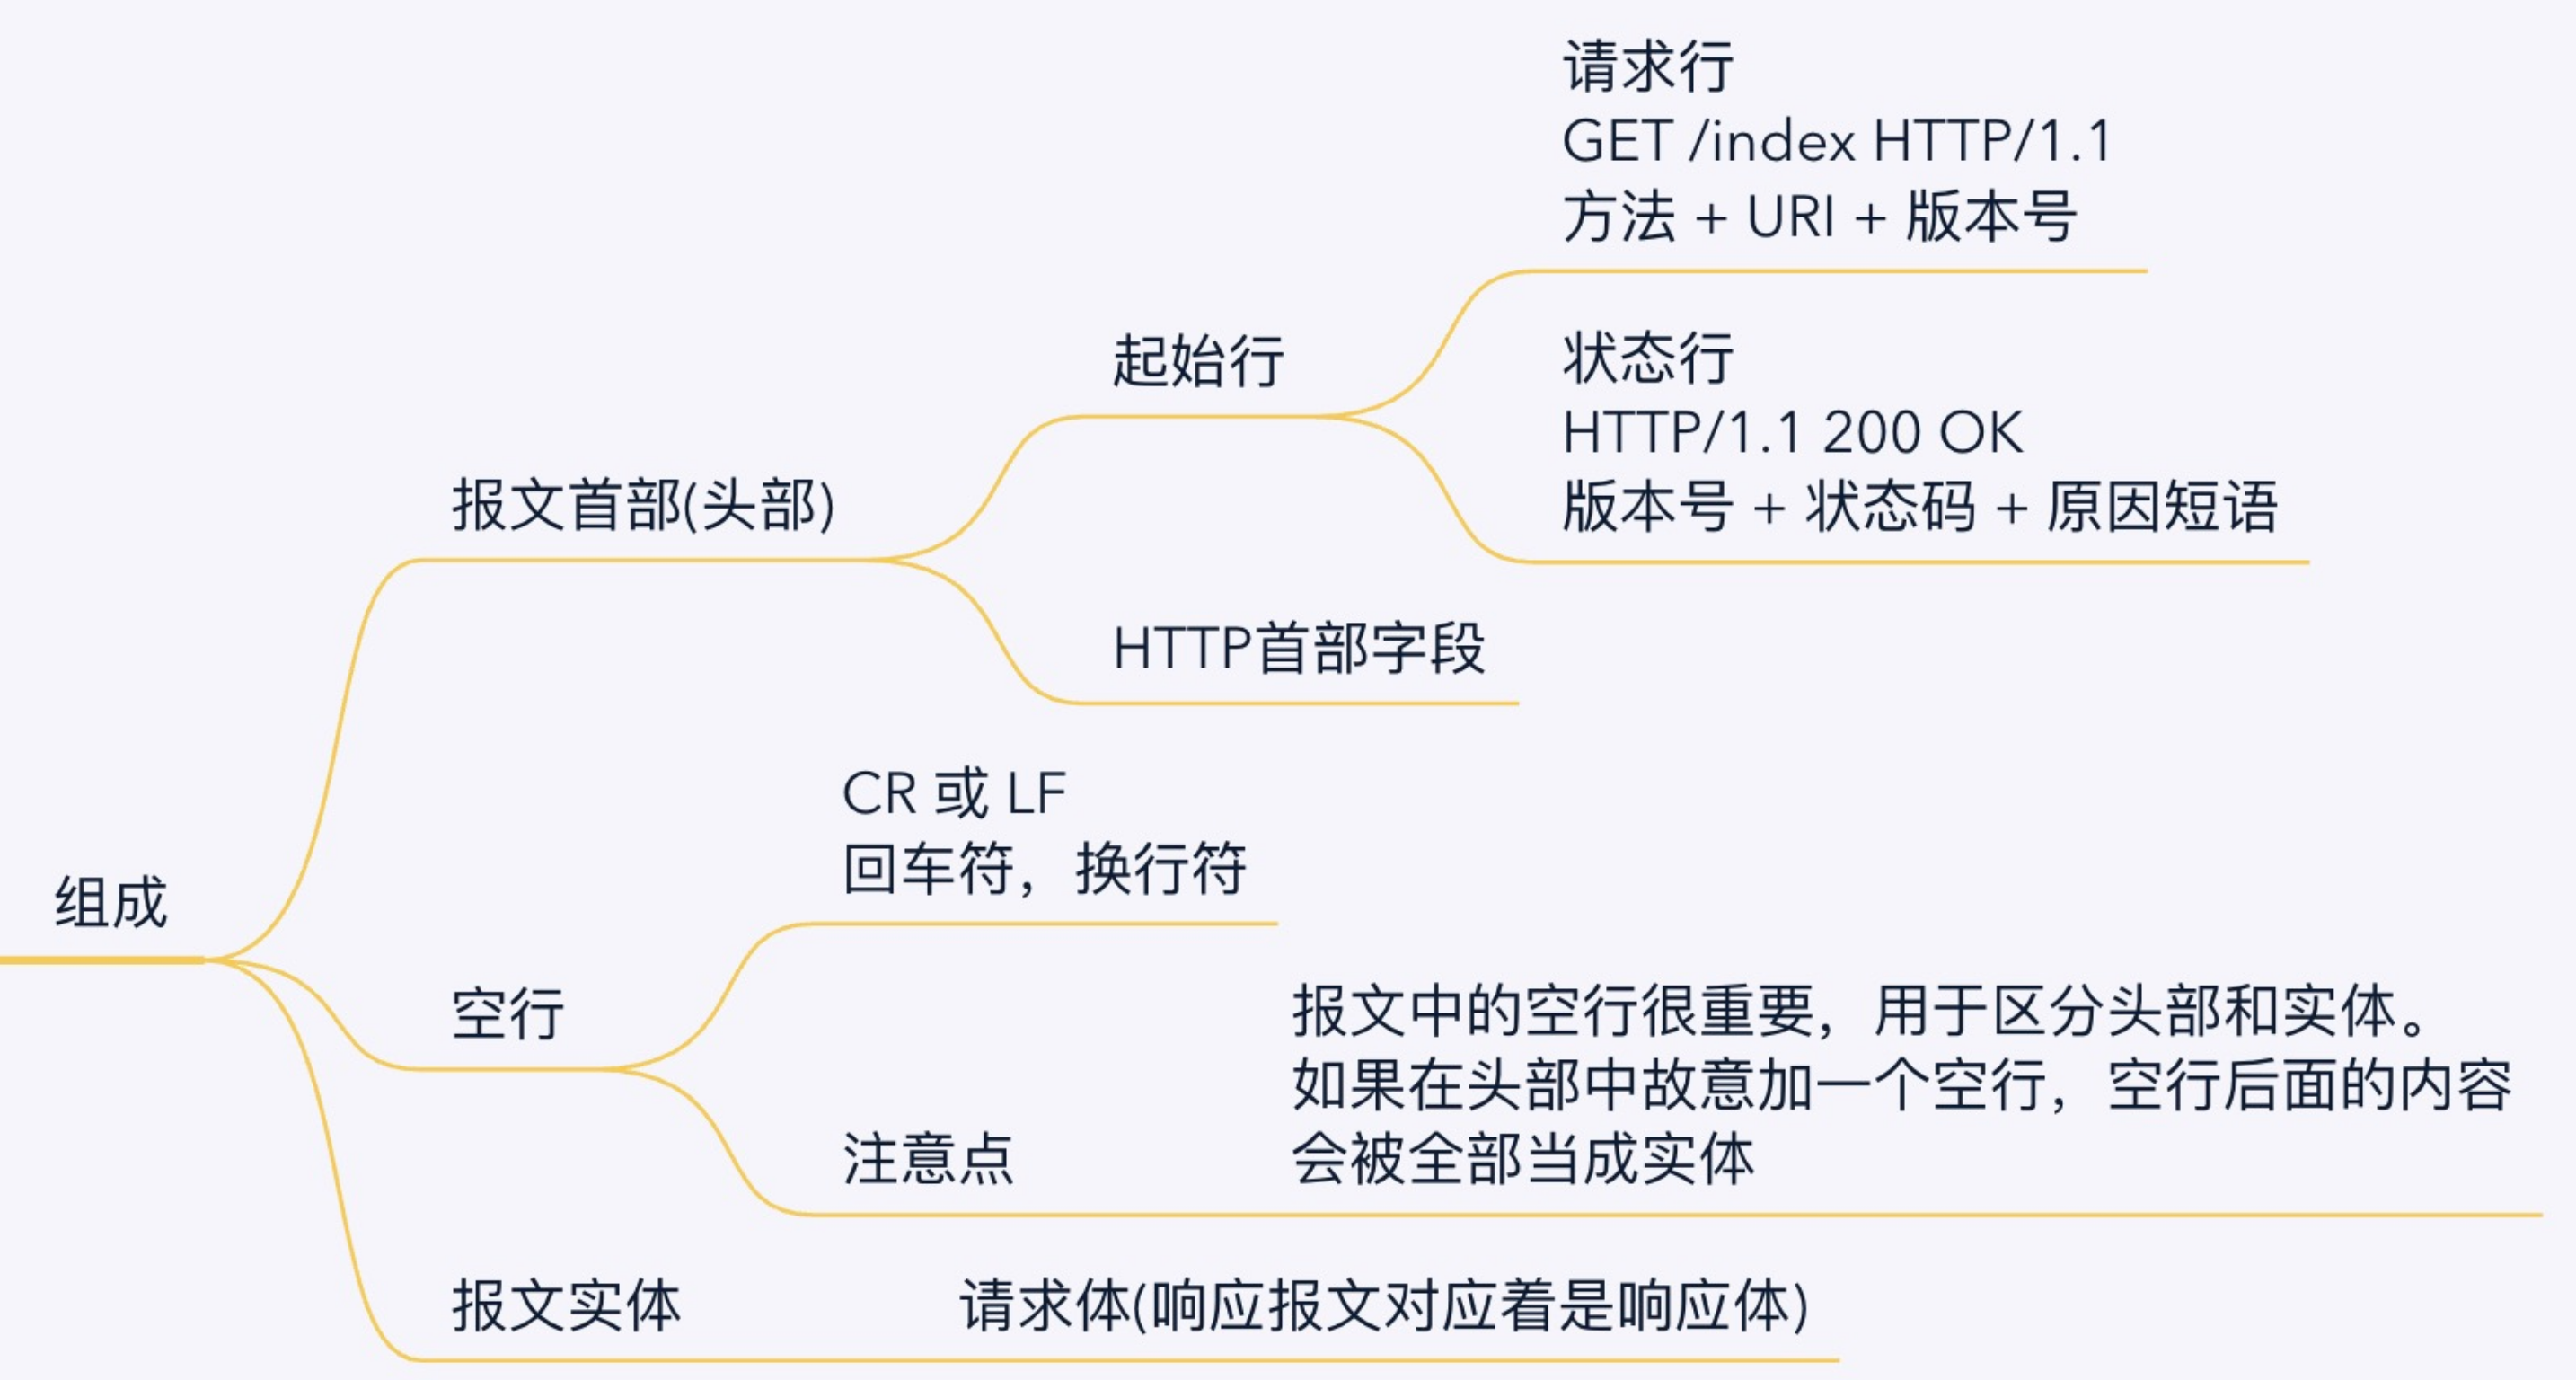
大家记住这张图就可以了:
# 3.1 起始行
请求报文中叫:请求行
由:方法 + URI + 版本号 组成
例:GET index.html HTTP/1.1
真实例子可以看上面👆HTTP整体报文那张图。
响应报文中叫:状态行
由:版本号 + 状态码 + 原因短语
例:HTTP/1.1 200 OK
(这个原因短语就是之前学习HTTP状态码每个状态码对应的英文单词,比如404 Not Found)
# 3.2 首部字段
在第四节中细讲。
# 3.3 空行
空行:也就是CR(回车符) 或 LF(换行符),它的作用就是用来区分头部和实体。
例如下面这个实例:
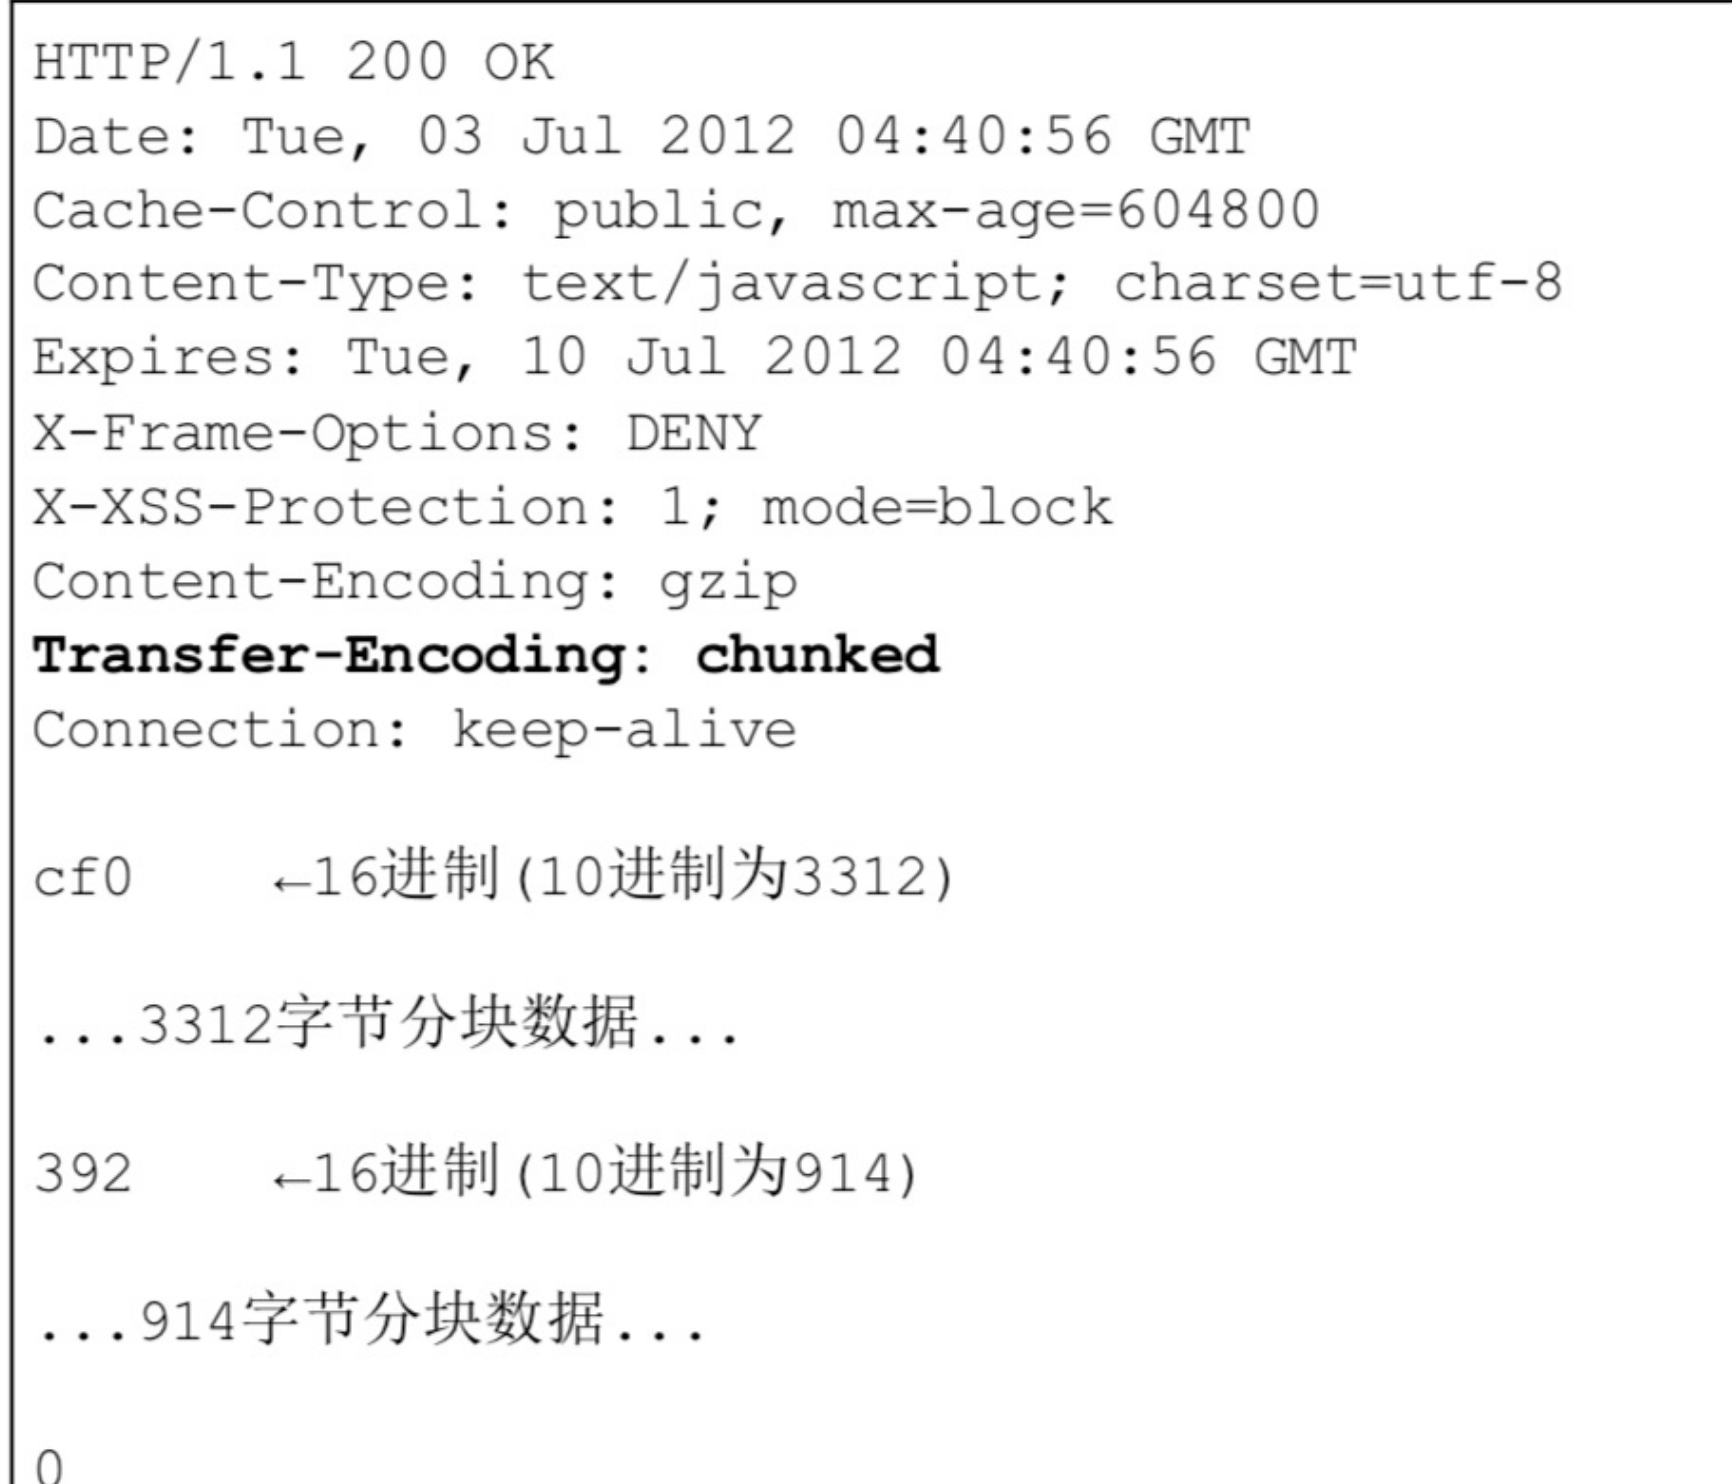
在Connection: keep-alive下面就有一个换行符。
注意点:
如果在头部中故意加一个空行,空行后面的内容会被全部当成实体
# 4. HTTP首部字段
(HTTP报文中最繁琐的就是首部字段了,也就是我们经常在network上看到的那么一大串的配置)
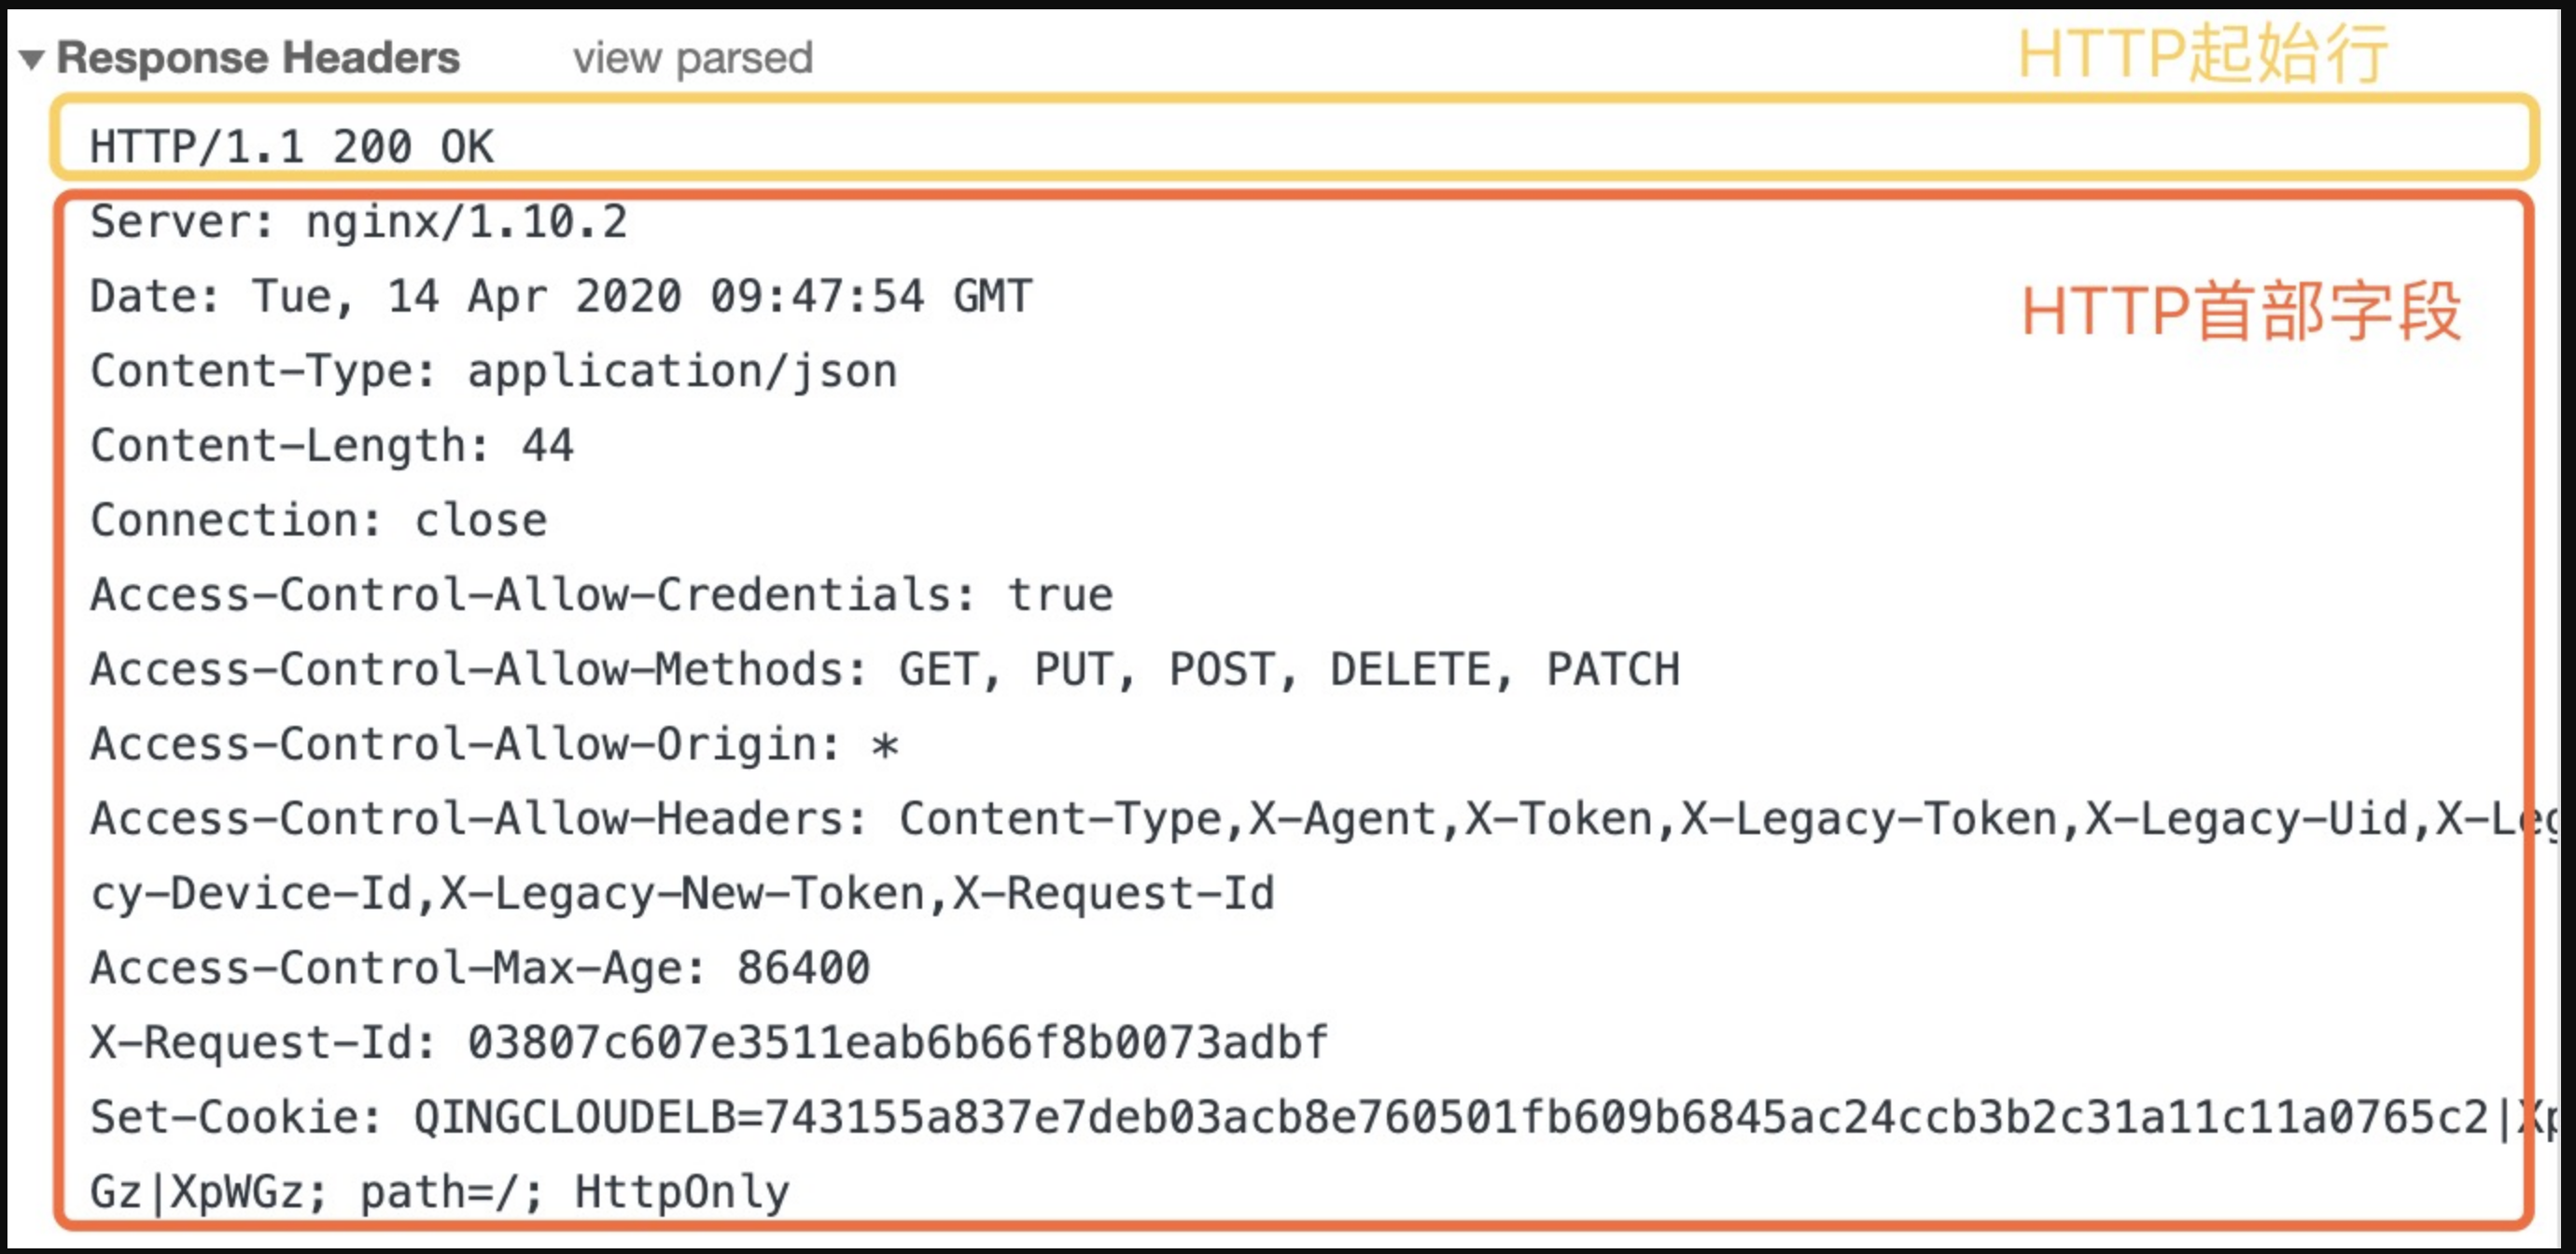
HTTP首部字段我会从这几个方面来讲解:
- HTTP首部字段结构
- 四种HTTP首部字段类型
- 非标准的首部字段
- Accept相关字段
# 4.1 HTTP首部字段结构
- 首先基本结构是:
由:key: value
例子:Content-Type: text/html
- 多个字段值用
,号连接:
由:key: value1, value2
例:Keep-Alive: timeout=15, max=100
- 若是字段值有可选参数且是多个则用
;号连接:
由:key: value1, q=1;value2, q=0.8
例:Accept: text/html, q=1; application/xml, q=0.8
- 若是首部字段重复不同的浏览器有不同的处理结果,有些浏览器会优先处理第一次出现的首部字段,而有些则先处理最后出现的首部字段
# 4.2 四种HTTP首部字段类型
首部字段从类型上来说,有四种:
- 通用首部字段(General Header Fields):请求和响应报文都会用的字段
- 请求首部字段(Request Header Fields):请求报文时用的字段
- 响应首部字段(Response Header Fields):响应报文时用的字段
- 实体首部字段(Entity Header Fields):请求和响应报文的实体部分用的字段
而每一种类型下面又有很多字段,可能一下要记这么多也比较难,所以面试时能尽量把自己知道的说出来就可以了,让面试官知道对于一些重要的字段你还是有了解的。
以下我列举了一些,不过标了星号的可是重点哦。
# 通用首部字段
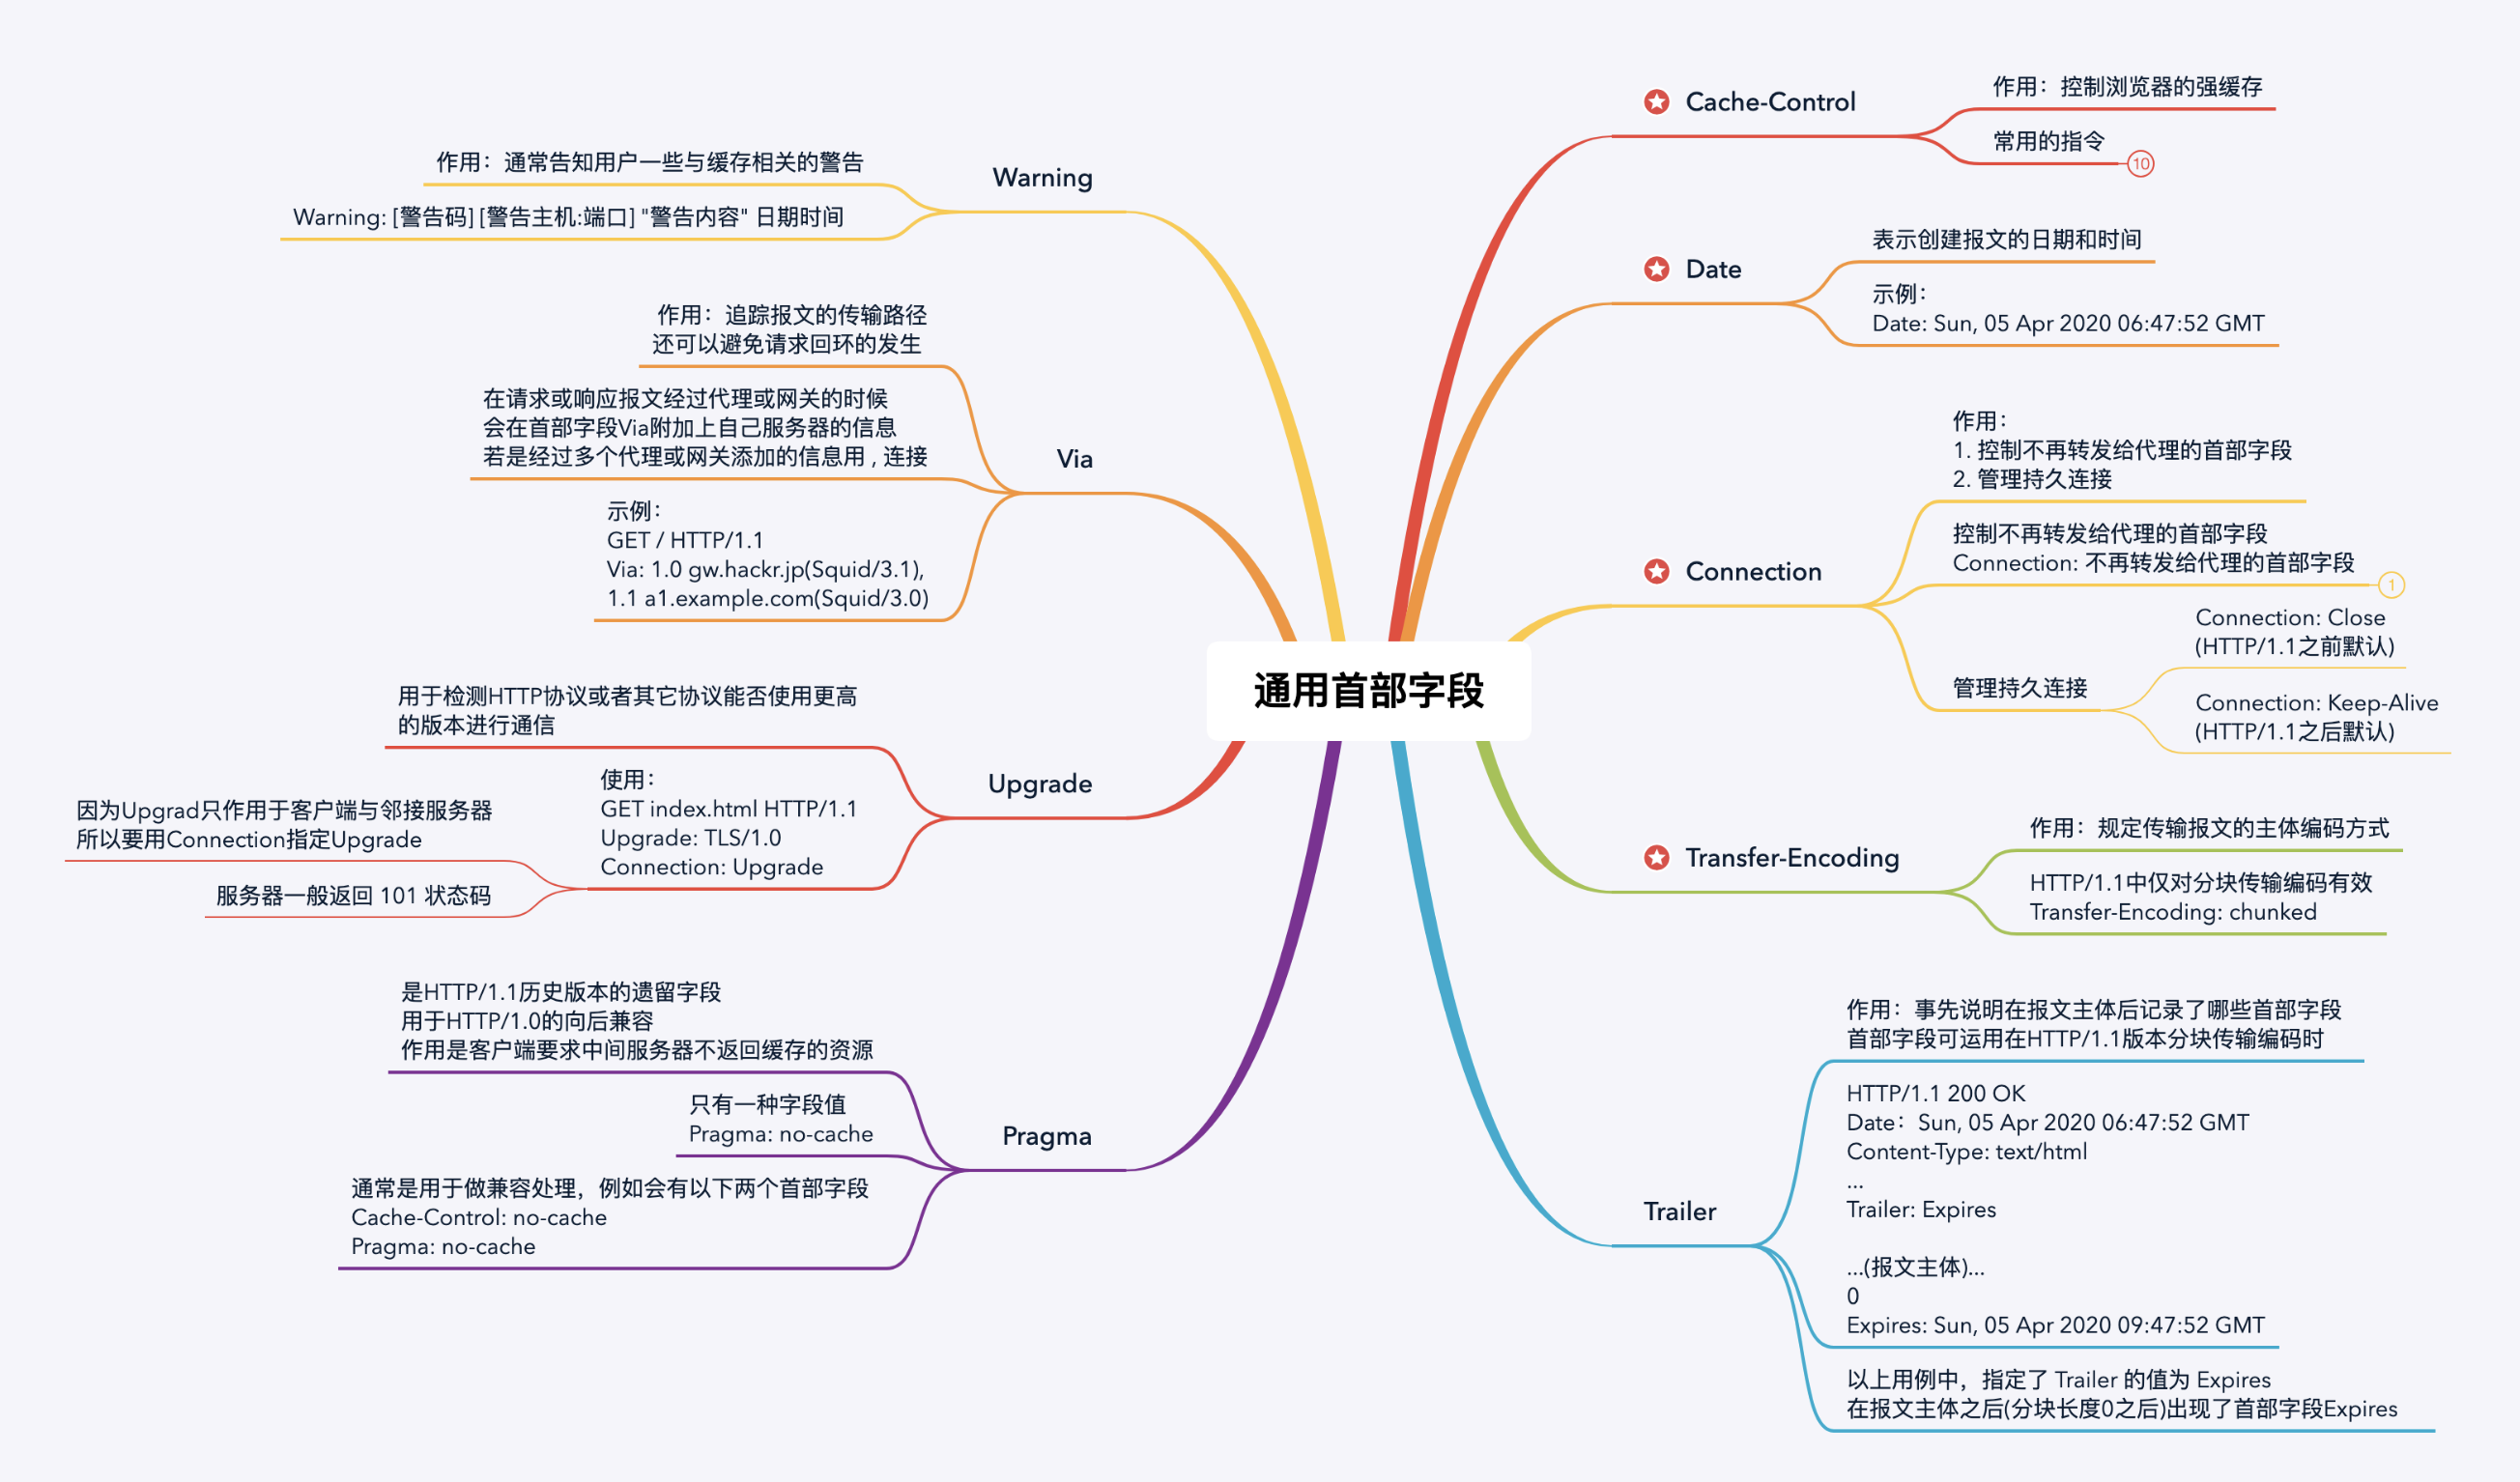
这边有一个需要注意的点:
Connection首部字段有一个值是keep-alive,表示开启持久连接。
而其实还有一个首部字段也叫Keep-Alive,允许消息发送者暗示连接的状态,还可以用来设置超时时长和最大请求数。
对于这个Keep-Alive首部字段,有两个参数:
timeout:指定了一个空闲连接需要保持打开状态的最小时长(以秒为单位)。需要注意的是,如果没有在传输层设置 keep-alive TCP message 的话,大于 TCP 层面的超时设置会被忽略。max:在连接关闭之前,在此连接可以发送的请求的最大值。在非管道连接中,除了 0 以外,这个值是被忽略的,因为需要在紧跟着的响应中发送新一次的请求。HTTP 管道连接则可以用它来限制管道的使用。
案例🌰:
HTTP/1.1 200 OK
Connection: Keep-Alive
Content-Encoding: gzip
Content-Type: text/html; charset=utf-8
Date: Thu, 11 Aug 2016 15:23:13 GMT
Keep-Alive: timeout=5, max=1000
Last-Modified: Mon, 25 Jul 2016 04:32:39 GMT
Server: Apache

(body)
需要将 The Connection 首部的值设置为 “keep-alive” 这个首部才有意义。同时需要注意的是,在HTTP/2 协议中, Connection 和 Keep-Alive 是被忽略的;在其中采用其他机制来进行连接管理。
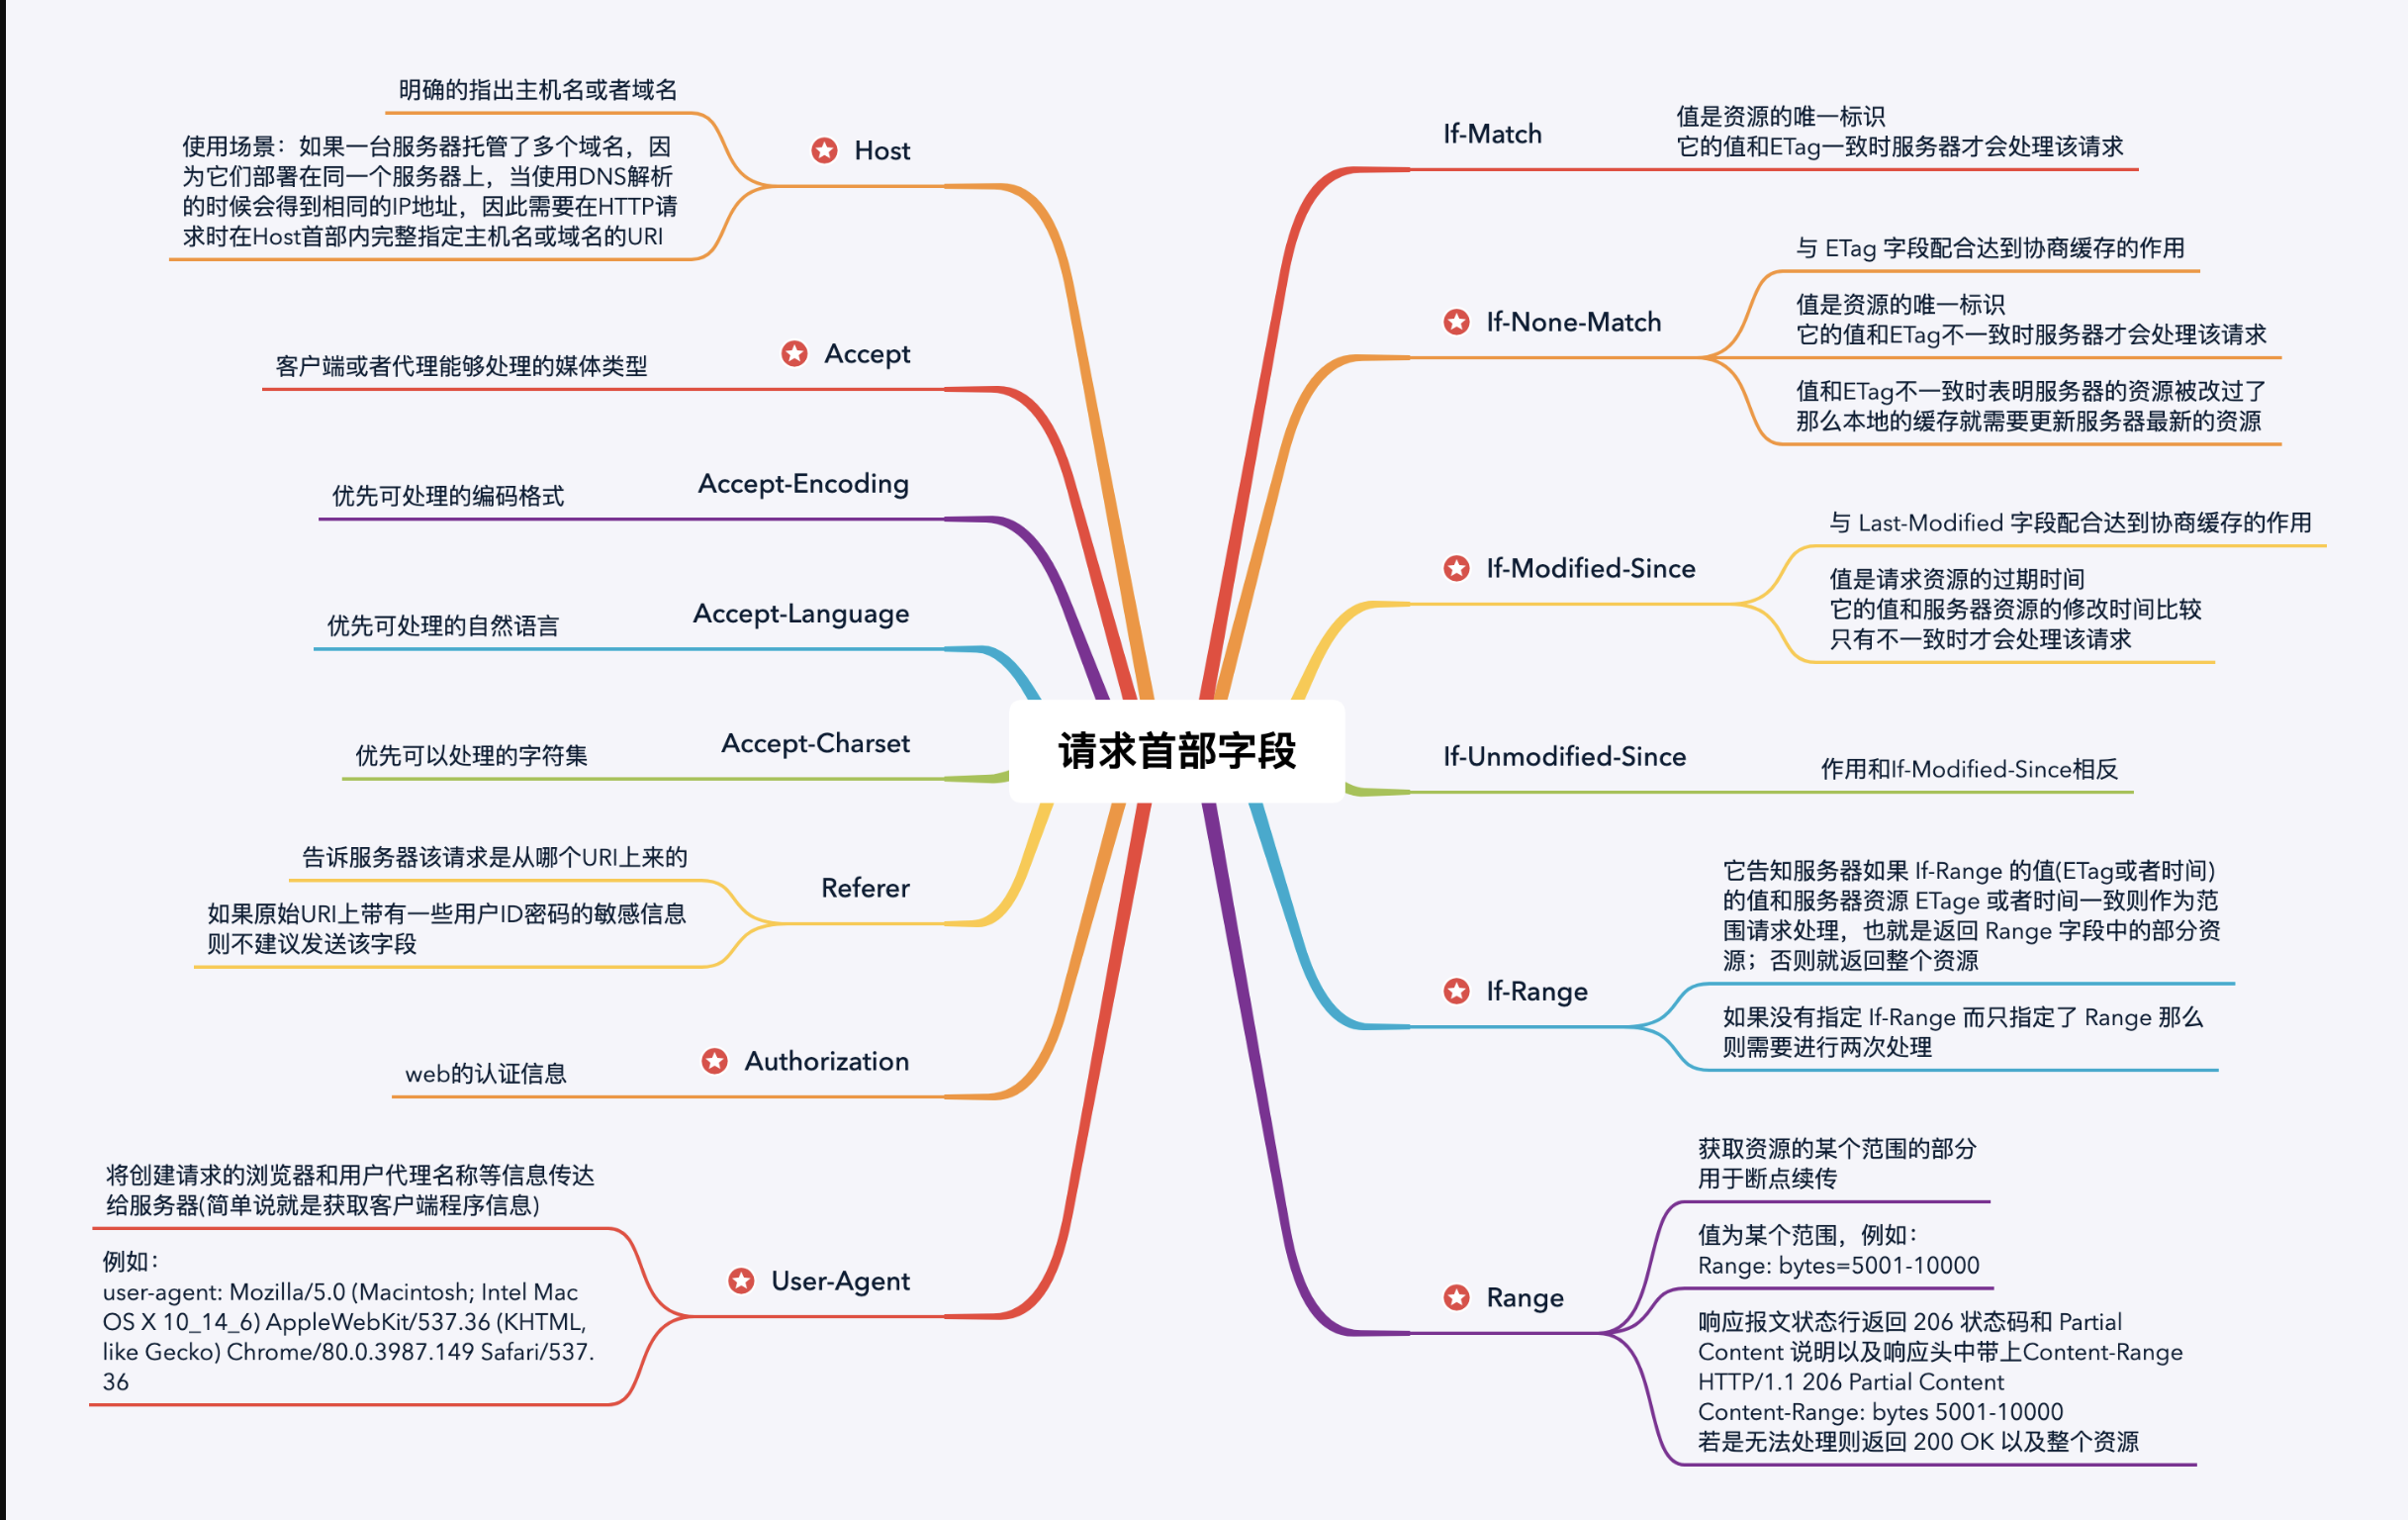
# 请求首部字段
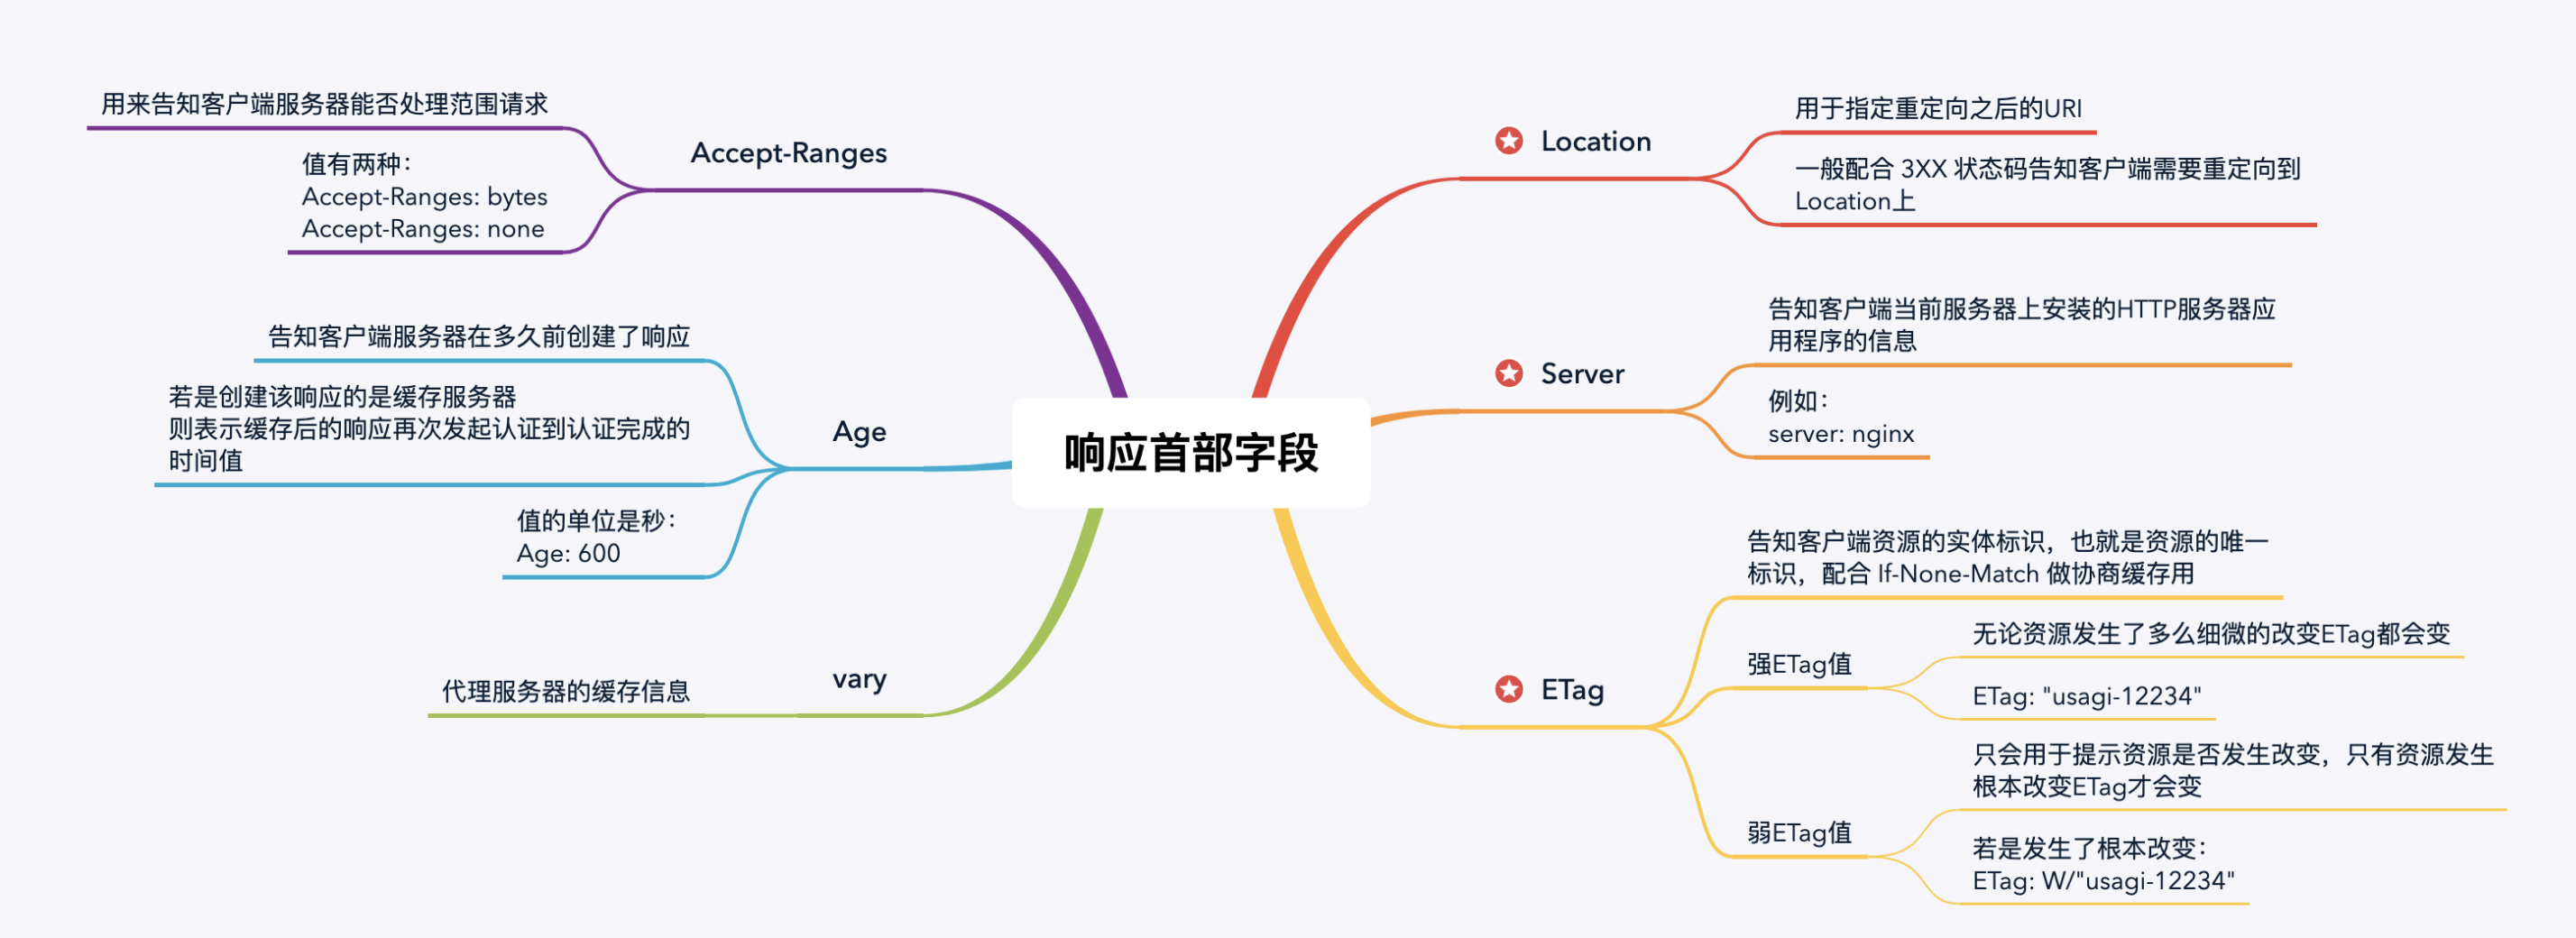
# 响应首部字段
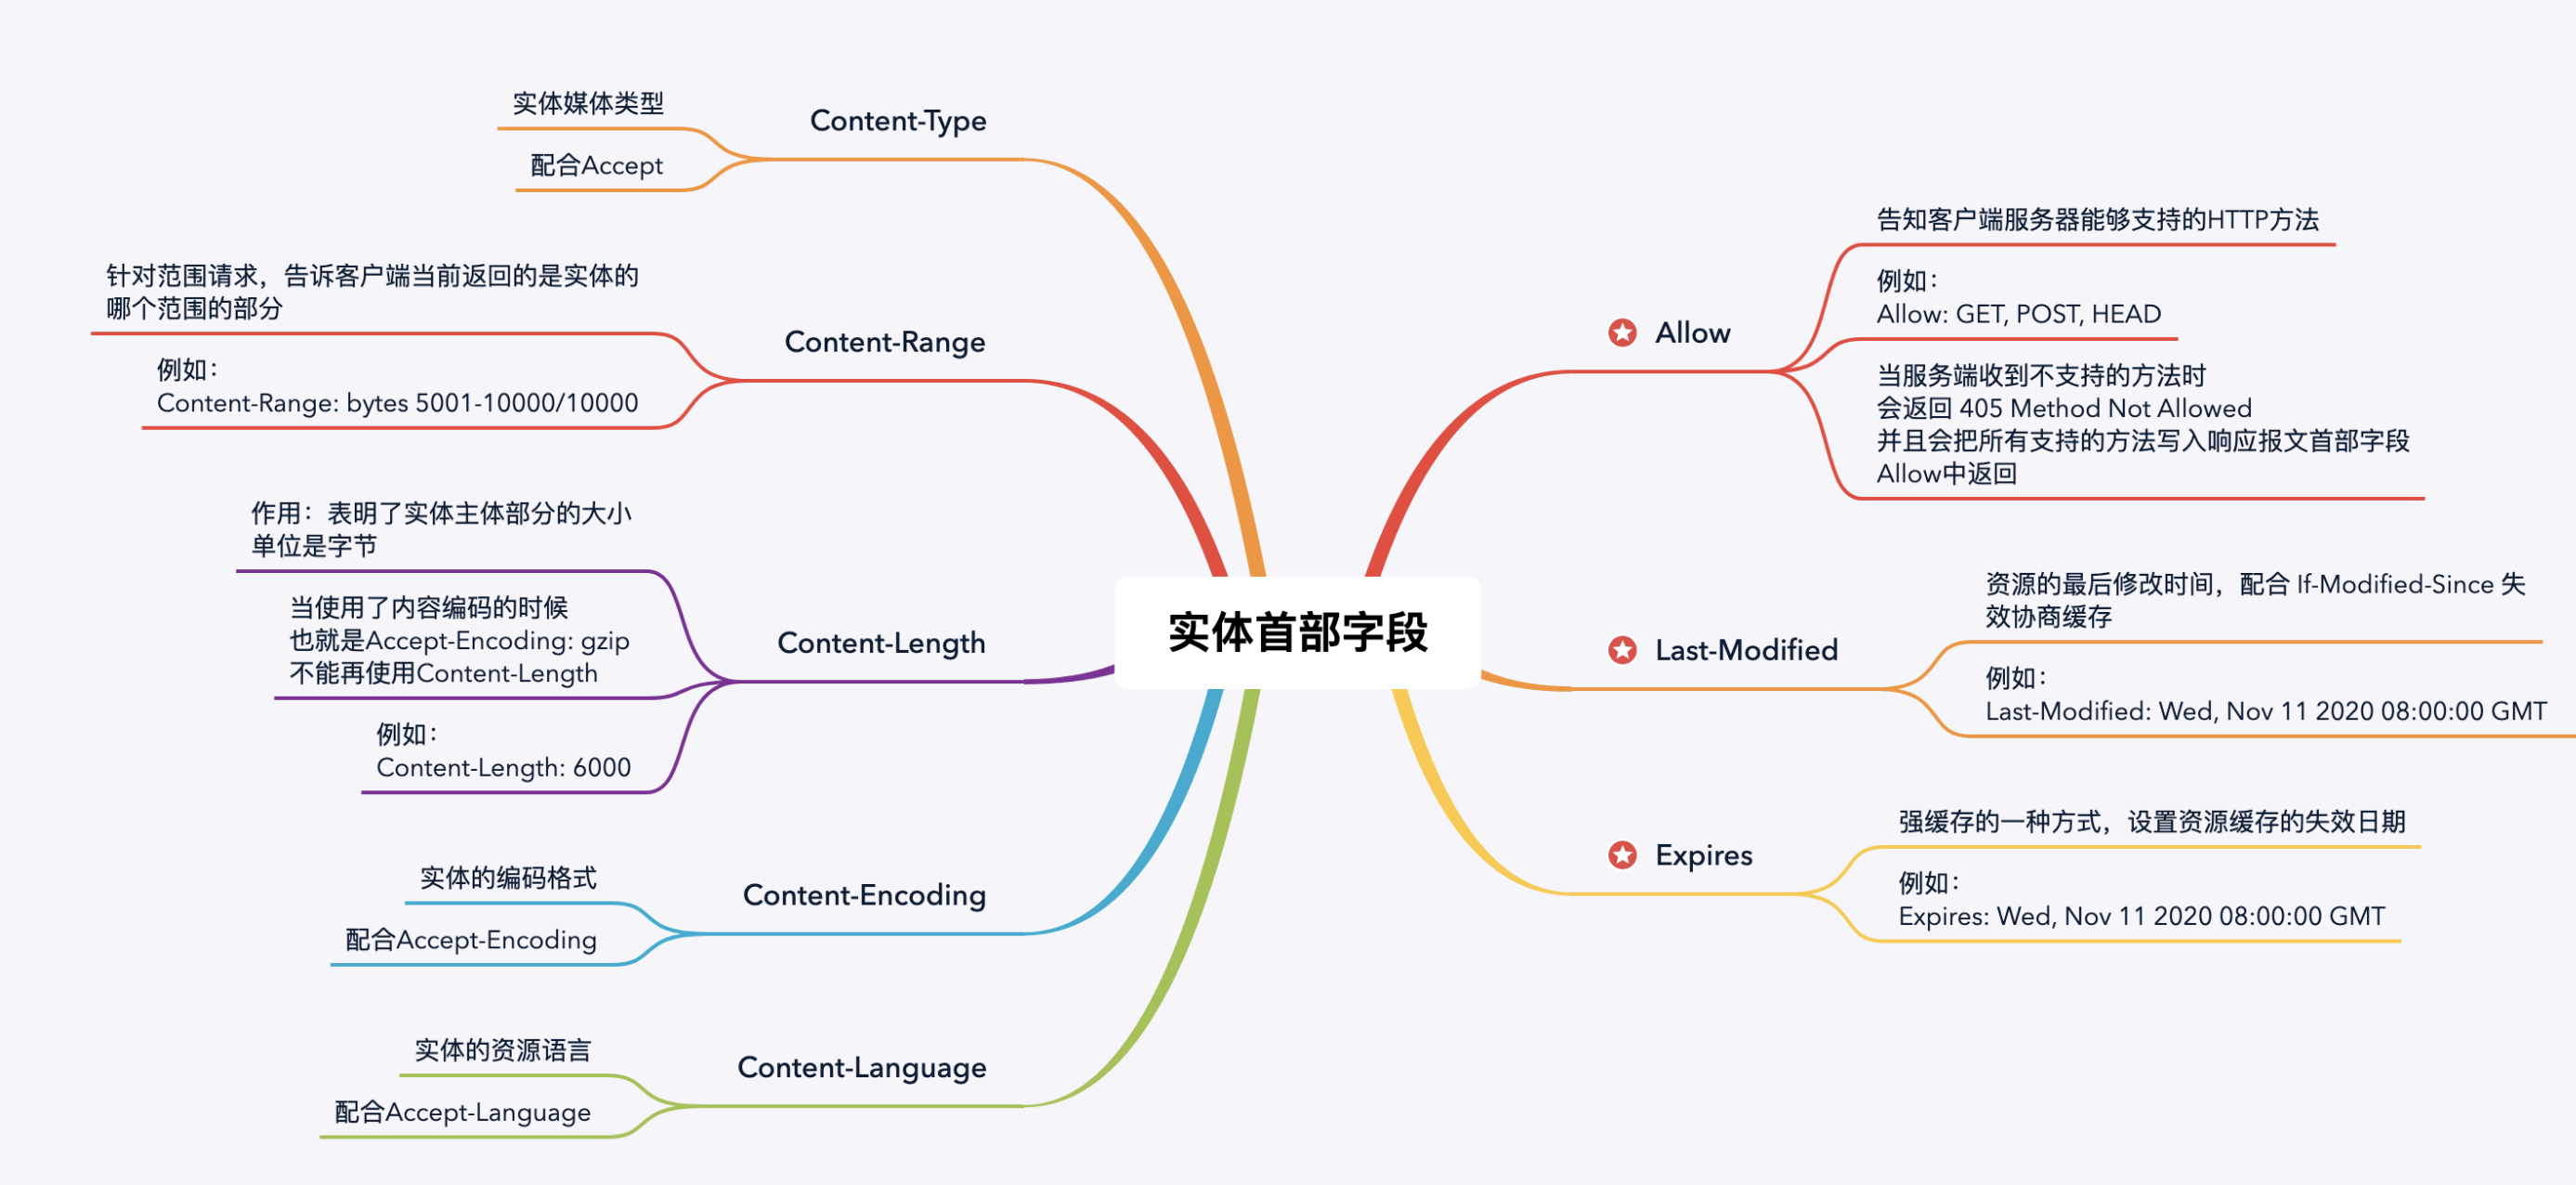
# 实体首部字段
# 4.3 非标准的首部字段
因为HTTP首部字段是可以自行扩展的,所以在Web服务器和浏览器的应用上,出现了一些非标准的首部字段。
有这么一些:
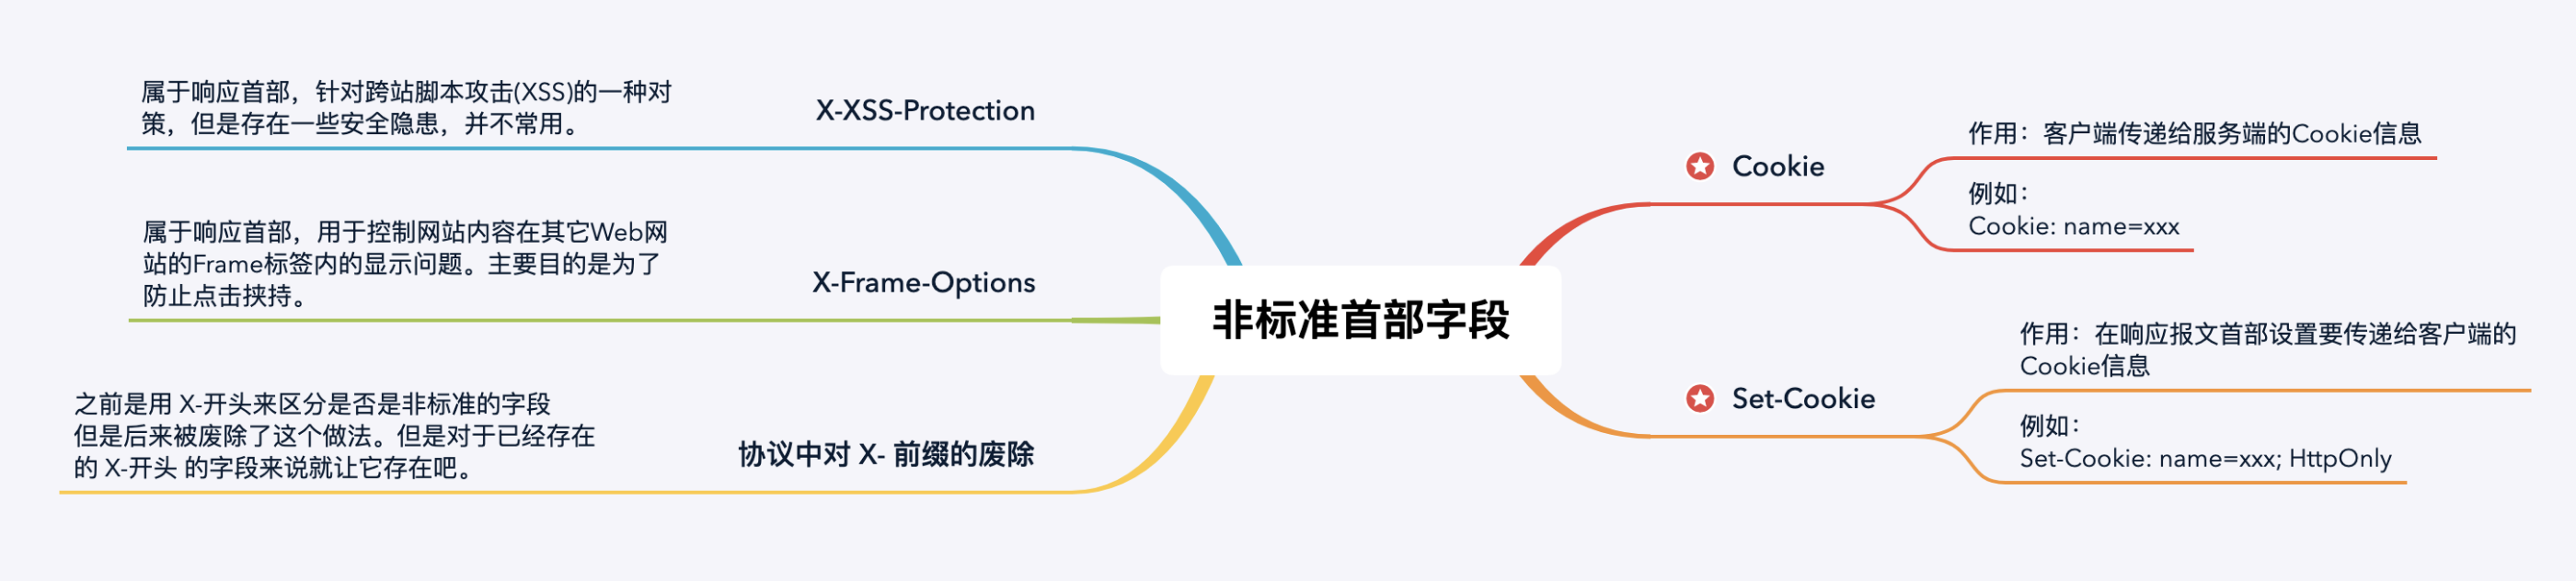
另外关于Cookie这块内容也还是挺多的,所以我也会单独放在第三章来进行讲解。
# 4.4 Accept相关字段
还有一个比较重要的点就是几种Accept相关的首部字段。
# 权重
当有多个字段值的时候,可以指定字段 q 来作为权重,权重范围 0~1。
例如:
Accept: text/html, q=1; application/xml, q=0.8
# 五种类别
(图中的序号并无优先级的意思,只是单纯的作为标记)
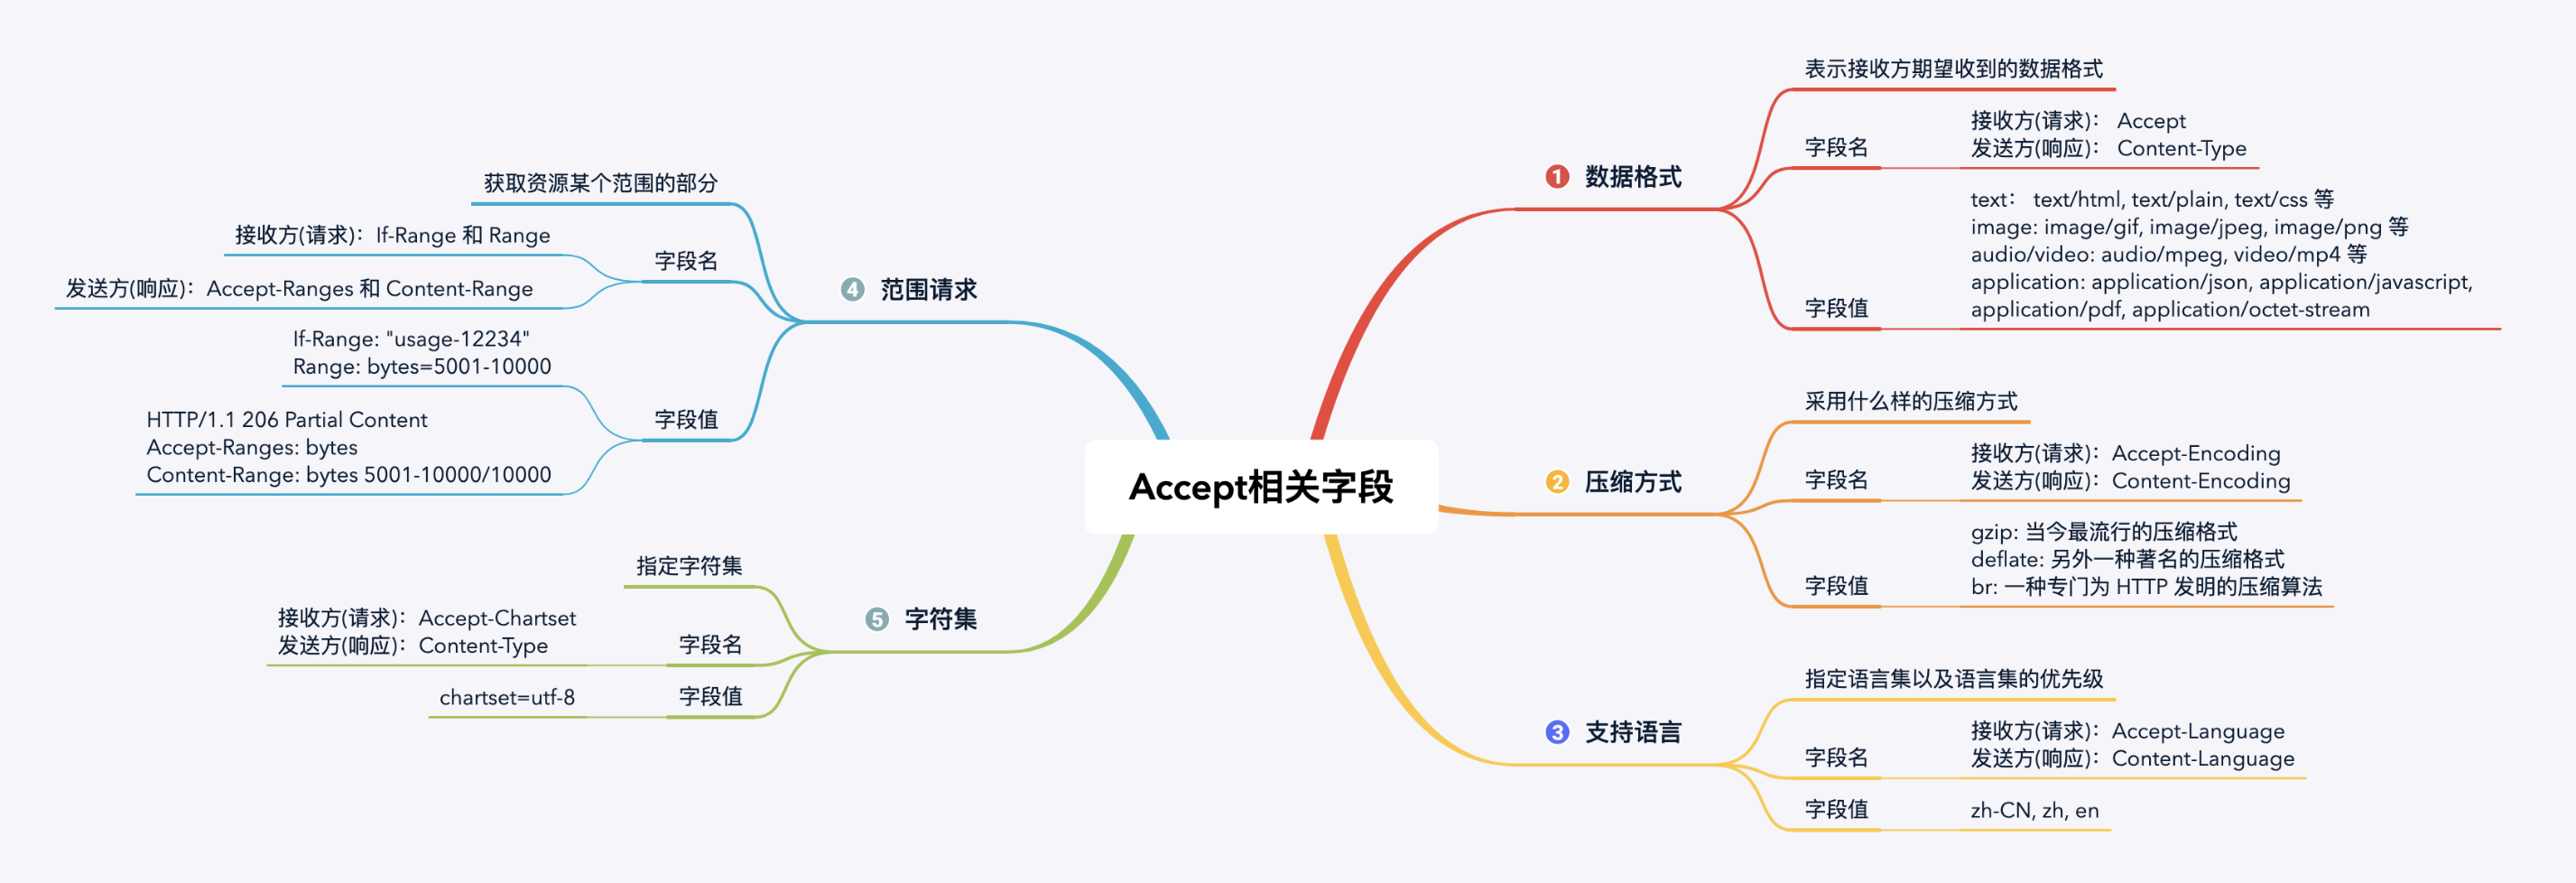
需要注意的是:
If-Range 和 Range以及 Accept-Ranges 和 Content-Range
这四个字段只有Accept-Ranges是有s的。
# 5. 编码提升传输速率
对于「编码提升传输速率」,我主要是将它分为了两部分讲解:
- 内容编码
- 传输编码
首先说下两者的区别吧:
内容编码通常用于对实体内容进行压缩编码,目的是优化传输,例如用 gzip 压缩文本文件,能大幅减小体积。且它通常是有选择性的,例如jpg、png这类文件一般不开启,因为图片格式已经是高度压缩过的,再压一遍没什么效果不说还浪费 CPU。传输编码则是用来改变报文格式,通常在头部加入Transfer-Encoding: chunked,实现分块编码。
相同点:
- 都是作用在实体主体上的可逆变换。这句话的意思是说:例如服务器使用了
gzip压缩了原始的响应体然后发送给浏览器,浏览器在得到之后可以对这个被压缩的响应体进行解码得到原始内容。
# 5.1 内容编码
# 内容编码介绍
内容编码表示HTTP应用程序有时在发送请求之前需要对内容进行编码,例如我们常听见的通过Content-Encoding来指定内容的压缩方式,通过Content-Length来指定文件大小。
内容编码的具体过程主要是:
- 服务器生成原始响应报文,其中有原始的
Content-Type和Content-Length首部字段 - 接着将原始的响应报文经过
内容编码服务器创建编码后的报文。这个编码后的报文同样有Content-Type和Content-Length两个字段,只不过Content-Length是有可能变的,例如主体经过了压缩,那么它的值肯定就变小了。 - 除了上述两个字段,还会在编码后的报文中增加
Content-Encoding首部,这样收到的应用程序就可以进行解码了。 - 接收程序收到编码后的报文再进行解码,获得原始报文。
(具体过程可以看后面的HTTP压缩的具体过程,与此情况大同小异)
# 内容编码类型
HTTP定义了一些标准的内容编码类型,主要是由Content-Encoding和Accept-Encoding首部字段来进行控制。
内容编码类型的不同,实际上是使用了不同的算法,例如gzip算法、deflate算法。而标示需要使用哪种算法来进行内容编码,则需要用到内容编码代号,也就是Content-Encoding的值,例如:
Content-Encoding: gzip
主要是有这么几种内容编码代号:
- gzip:实体采用GUN zip 编码
- compress:实体采用Unix的文件压缩程序
- deflate:实体使用zlib的格式压缩
- identity:不对实体进行编码。当没有
Content-Encoding首部的时候,就默认这种情况
补充:
- br:实体采用Brotli算法编码
注意⚠️:
-
Content-Encoding是在响应报文中定义的首部,用于告诉浏览器我采用了哪种编码方式,你得按这种编码方式来进行解析。 -
Accept-Encoding是在请求报文中定义的首部,用于告诉服务器我支持哪些编码方式,你可以按这些编码方式来进行编码然后传输给我。 -
另外,如果HTTP请求中没有
Accept-Encoding首部的话,服务器就会假设客户端能够接受任何编码方式,也就是等价于Accept-Encoding: *这种情况。 -
gzip压缩方式使用最为广泛,而brotli是一种比Gzip压缩率更高的算法,编码代号为br。在兼容性上br已经支持了大部分的浏览器,不过br压缩只能在HTTPS中生效,因为在HTTP请求中request header里的Accept-Encoding是没有br这个选项的。
# 内容编码与HTTP压缩
HTTP压缩,在HTTP协议中,其实是内容编码的一种。
因为内容编码的类型会有很多种,而使用一些特定编码类型,例如gzip,就能实现对内容(body)进行压缩,
这样可以有助于减少传输实体的时间。
也可以使用其他的编码把内容搅乱或加密,以此来防止未授权的第三方看到文档的内容。
所以我们说HTTP压缩,其实就是HTTP内容编码的一种。
# HTTP压缩的具体过程
HTTP压缩是指: Web服务器和浏览器之间压缩传输的文本内容的方法。
HTTP采用通用的压缩算法,比如gzip来压缩html,javascript, CSS文件。 能大大减少网络传输的数据量,提高了用户显示网页的速度。
既然HTTP压缩是内容编码的一种,那么它的压缩过程其实也就是遵循了内容编码的过程。
在此,我们以Accept-Encoding: gzip为例,也就是gzip压缩:
- 浏览器发送HTTP请求给服务器,并且请求报文中带有
Accept-Encoding: gzip首部字段(告诉服务器,浏览器支持gzip压缩) - 服务器在接受到请求之后,首先生成原始的响应,其中原始的响应中有:
Content-Type和Content-Length - 接着通过
gzip内容编码器进行编码,编码后请求的header中有Content-Type和Content-Length,还新增了Content-Encoding: gzip,并且把此请求发送给浏览器 - 浏览器在接受到请求后,根据
Content-Encoding: gzip来对请求进行解码,这里应该也有一个gzip内容解码器,然后得到原始的响应。
让我们来看张图:
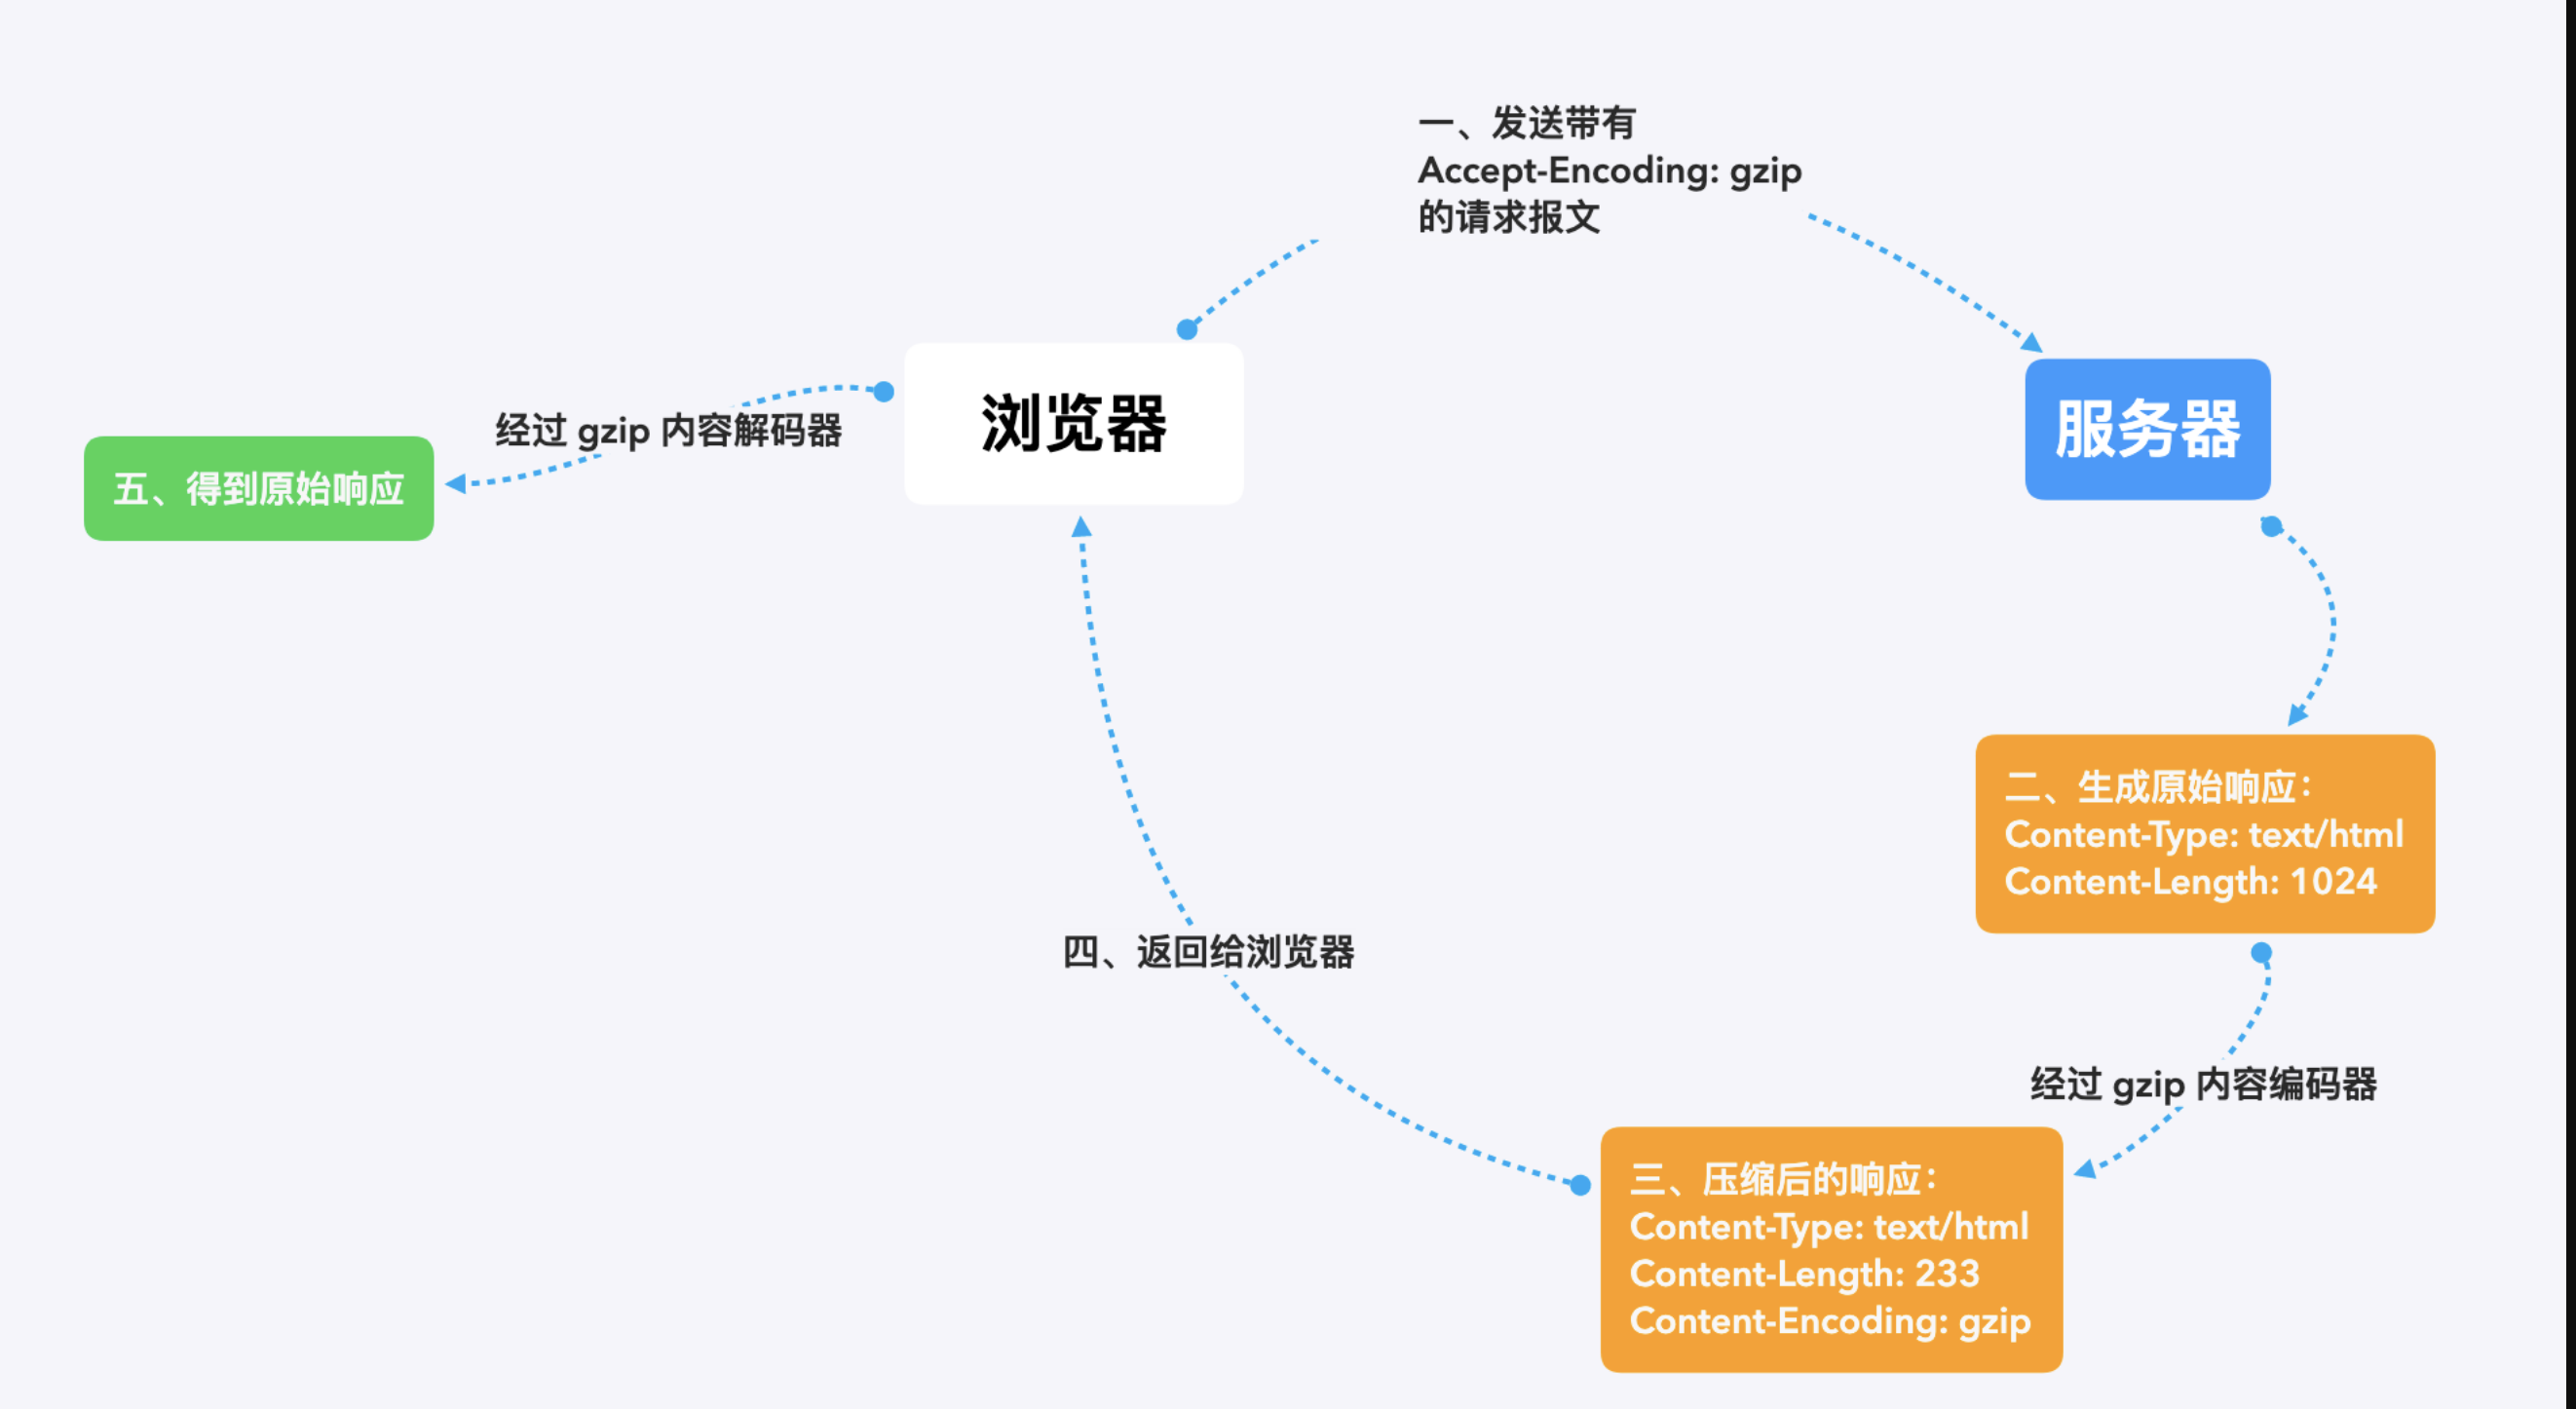
可以看到,在这里原始响应虽然被压缩过了,但是后面还是能经过解码器转为原始内容,所以这就是前面提到的可逆变换。
# gzip的相关知识点
gzip, compress, 以及deflate编码都是无损压缩算法,用于减少传输报文的大小,不会导致信息损失。 其中gzip通常效率最高, 使用最为广泛。
压缩的好处
HTTP压缩对纯文本可以压缩至原内容的40%, 从而节省了60%的数据传输。
gzip的缺点


