
# HTTP1:HTTP性能优化
30 秒速记
HTTP/1.1的性能瓶颈三件事:建连成本、队头阻塞、头部冗余(明文、不压缩)- 持久连接省掉反复握手,但同一连接上响应必须按顺序回来
- 浏览器的应对:同一域名最多开
6条连接并行(Chrome) - 前端老几样:合并文件 / 雪碧图、内联小资源、域名分片,再加压缩和缓存
- 这些招在
HTTP/2下要重新评估:多路复用之后,过度合并和域名分片反而可能拖后腿
HTTP/1.1 下的性能优化,基本都是在跟「建连接贵」和「一条连接一次只能等一个响应」这两件事较劲。 持久连接解决了反复握手,但同一条连接上的响应还是排队的,前面一个慢,后面全得等。浏览器的办法是对同一个域名开 6 条连接并行跑,前端的办法是减少请求数:合并 JS、做雪碧图、小图转 base64 内联,再用多个域名突破连接数限制。这些都是针对 HTTP/1.1 的补丁,站点上了 HTTP/2 之后,合并和域名分片就该重新评估了。
谈及浏览器中的网络,就避不开 HTTP。我们知道 HTTP 是浏览器中最重要且使用最多的协议,是浏览器和服务器之间的通信语言,也是互联网的基石。而随着浏览器的发展,HTTP 为了能适应新的形式也在持续进化,我认为学习 HTTP 的最佳途径就是了解其发展史,所以在接下来的三篇文章中,我会从浏览器发展的视角来和你聊聊 HTTP 演进。这三篇分别是即将完成使命的 HTTP/1、正在向我们走来的 HTTP/2,以及未来的 HTTP/3。
本文主要介绍的是 HTTP/1.1,我们先讲解 HTTP/1.1 的进化史,然后再介绍在进化过程中所遇到的各种瓶颈,以及对应的解决方法。
原理拆解: HTTP/1.1 用持久连接减少了反复建立 TCP 连接的成本,并通过缓存、分块传输等机制提升传输效率。但同一连接上的响应仍需按请求顺序处理;若前面的响应迟迟不能完成,后续响应也会被阻塞。浏览器因此常为同一站点建立多个连接,但连接数量受限,而且每条连接都要承担握手、拥塞控制和服务端资源占用。优化应沿因果链展开:减少请求数量、减少传输字节、避免重复传输,并缩短关键资源的等待路径。
最小验证: 输入为一次请求两个静态资源的原始报文,用来验证持久连接可以复用同一条连接,但响应顺序仍然固定。
GET /slow.css HTTP/1.1
Host: example.com
Connection: keep-alive

GET /app.js HTTP/1.1
Host: example.com
Connection: close

HTTP/1.1 200 OK
Content-Type: text/css
Content-Length: 16

body{color:red}
HTTP/1.1 200 OK
Content-Type: application/javascript
Content-Length: 18

console.log("ok")
两个请求可以连续写入连接,但服务器必须先完整返回 /slow.css,再返回 /app.js;若首个资源生成缓慢,第二个资源即使已经准备好也无法越过它。预期可观察到第二个响应的首字节时间被前一个响应拖后。
边界与排查: 合并文件能减少请求,却可能扩大变更后的缓存失效范围;内联资源能消除请求,却会增加 HTML 体积并阻碍独立缓存。压缩更适合文本资源,已经压缩过的图片、音视频通常收益有限。工程验证应以浏览器 Network 面板中的请求数、传输大小、排队时间、首字节时间和关键渲染路径为依据,同时确认协议列确实是 HTTP/1.1,避免把 HTTP/2 多路复用下的结果误归因于连接优化。
面试官追问
追问 1开了 keep-alive,同一连接上的 /slow.css 会拖慢后面的 /app.js 吗?
会。keep-alive 只省了重新握手,同一条连接上 /app.js 的响应必须等 /slow.css 发完才能开始。浏览器一般会把 /app.js 放到另一条空闲连接上,这才是绕过去的办法。
追问 2活动页几十个小图标在 Network 面板里大片排队,怎么优化?
先减请求:图标合成雪碧图或 SVG sprite,几 KB 以下的内联成 data URI。再看服务器能不能开 HTTP/2,开了以后排队基本就没了,比在 HTTP/1.1 上抠细节划算得多。
追问 3把所有 JS 合成一个大文件,请求越少就越快吗?
不一定。改一行代码,整个大文件缓存失效,用户要重新下载全部。一般把很少变的第三方库单独打一个包,业务代码按路由拆,文件名带内容 hash 做长缓存。
追问 4图片已经是 JPEG 了,再开 gzip 有意义吗?
基本没有,JPEG、PNG、视频本身就是压缩格式,再压一遍省不了几个字节,还白耗服务器 CPU。gzip 和 br 留给 HTML、CSS、JS、JSON 这些文本。
追问 5测试环境优化后排队明显少了,生产几乎没变化,可能是什么原因?
先看 Network 面板的 Protocol 列,测试环境可能是 HTTP/1.1,生产走的是 h2 甚至 h3。多路复用下请求排队本来就少,减少请求数的收益自然小,两边的结论不能直接比。
# 超文本传输协议 HTTP/0.9
30 秒速记
1991年提出,只为传小HTML文件- 流程:
TCP三次握手 → 发一行GET /index.html→ 服务器回ASCII字符流 → 断开连接 - 没有请求头、请求体,也没有响应头、状态码
- 响应结束靠「服务器关连接」来表示,所以一个连接只能用一次
- 只能传文本,没法告诉浏览器类型、成功与否、要不要缓存
HTTP/0.9 极简到只有一行请求:建好 TCP 连接,发 GET /index.html,服务器把文件内容原样吐回来,然后关连接。 当时只是学术圈传 HTML 文档,需求就这么简单,所以请求没头、响应也没头,连状态码都没有。这也决定了它的局限:服务器没法说「这是一张图片」,也没法说「文件不存在」,返回的错误提示对客户端来说只是另一段文本;连接关闭就是响应结束的标志,所以每个请求都要重新握手。后来 HTTP/1.0 加的那些头部,补的正是这些缺口。
首先我们来看看诞生最早的 HTTP/0.9。HTTP/0.9 是于 1991 年提出的,主要用于学术交流,需求很简单——用来在网络之间传递 HTML 超文本的内容,所以被称为超文本传输协议。整体来看,它的实现也很简单,采用了基于请求响应的模式,从客户端发出请求,服务器返回数据
下面我们就来看看 HTTP/0.9 的一个完整的请求流程(可参考下图)。
- 因为 HTTP 都是基于 TCP 协议的,所以客户端先要根据 IP 地址、端口和服务器建立 TCP 连接,而建立连接的过程就是 TCP 协议三次握手的过程。
- 建立好连接之后,会发送一个 GET 请求行的信息,如GET /index.html用来获取 index.html。
- 服务器接收请求信息之后,读取对应的 HTML 文件,并将数据以 ASCII 字符流返回给客户端。
- HTML 文档传输完成后,断开连接。
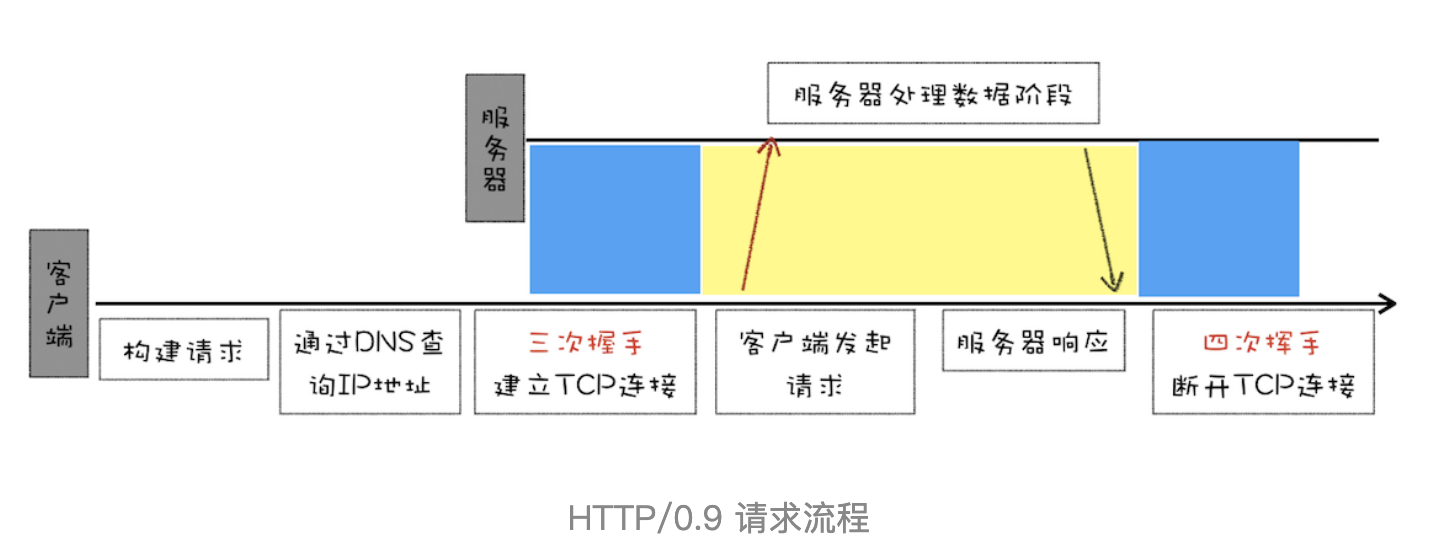
总的来说,当时的需求很简单,就是用来传输体积很小的 HTML 文件,所以 HTTP/0.9 的实现有以下三个特点。
- 第一个是只有一个请求行,并没有HTTP 请求头和请求体,因为只需要一个请求行就可以完整表达客户端的需求了。
- 第二个是服务器也没有返回头信息,这是因为服务器端并不需要告诉客户端太多信息,只需要返回数据就可以了。
- 第三个是返回的文件内容是以 ASCII 字符流来传输的,因为都是 HTML 格式的文件,所以使用 ASCII 字节码来传输是最合适的。
原理拆解: HTTP/0.9 把一次访问压缩为最小链路:客户端完成 TCP 握手后发送一行 GET,服务器直接写回文档字节,随后以关闭连接表示响应结束。因为没有状态码、响应头和长度字段,客户端无法从协议内获知资源类型、是否成功、是否可缓存,也不能依靠 Content-Length 判断边界。路径不存在时,服务器即使返回错误说明,对客户端而言也只是另一段普通内容。
最小验证: 输入为发往支持该旧协议的测试服务器的原始请求,用来验证请求仅含方法和路径,响应也没有状态行与响应头。
GET /index.html

<html>
  <body>Hello HTTP/0.9</body>
</html>
关键点是请求行后立即结束输入,响应首字节就是 HTML 内容,而不是 HTTP/1.1 200 OK。预期客户端持续读取字符流,直到服务端关闭连接;如果看到状态行或 Content-Type,服务端实际返回的就不是纯粹的 HTTP/0.9 响应。
边界与排查: 这种模型适合单个、小型 HTML 文档,却无法可靠承载图片等需要类型描述的资源,也不能表达重定向、缓存策略或认证挑战。现代浏览器和服务器可能禁用或限制 HTTP/0.9,因此不能用普通网页访问失败来否定报文结构。验证时应使用隔离的教学服务器或原始套接字抓包,并检查三个事实:线上只有单行 GET、响应前没有元数据、连接关闭承担消息结束标记。若服务端保持连接不关闭,客户端将无法确定响应是否传输完毕。
面试官追问
追问 1HTTP/0.9 的服务器怎么告诉客户端「文件找不到」?
告诉不了,协议里没有状态码。服务器顶多返回一段写着错误信息的 HTML,在客户端看来和正常页面没区别,监控程序也没法区分成功和失败。


