
虚拟DOM(二)diff算法与patch的实现细节
上一篇把虚拟 DOM 是什么、核心 API 有哪两个讲完了,但最关键的那块还没动:新旧两棵树到底怎么比,比出来的结果长什么样,又是怎么落到真实 DOM 上的。这篇就补这一块。会先从浏览器加载一个 HTML 要跑哪几步说起,说清楚「操作 DOM 贵」到底贵在哪一步,然后手写一个最小的 Element 实现,把 diff 的四种变化类型逐个拆开,最后把补丁应用回真实 DOM。看完你能自己解释「为什么 React 一定要你写 key」。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- 浏览器渲染一个页面要跑哪五步,DOM 操作的代价具体产生在哪
- 手写一个
Element构造函数,虚拟节点上除了标签属性子节点还要存什么 render()怎么把虚拟节点映射成真实 DOM- 树 diff 的复杂度为什么必须从
O(n^3)降到O(n) - REPLACE、PROPS、TEXT、REORDER 这四种变化各自怎么处理
- 没有 key 的时候插入一个节点会退化成什么样
- diff 的产物长什么样,怎么用深度遍历把它应用到 DOM 上
# 一、为什么需要虚拟DOM
先介绍浏览器加载一个 HTML 文件需要做哪些事,帮助我们理解为什么我们需要虚拟 DOM。所有浏览器的引擎工作流程都差不多,以 webkit 引擎为例,大致分 5 步:创建 DOM tree 、创建 Style Rules 、构建 Render tree 、布局 Layout 、绘制 Painting。
- 第一步,用
HTML分析器,分析HTML元素,构建一颗DOM树。 - 第二步:用
CSS分析器,分析CSS文件和元素上的inline样式,生成页面的样式表。 - 第三步:将上面的
DOM树和样式表,关联起来,构建一颗Render树。这一过程又称为Attachment。每个DOM节点都有attach方法,接受样式信息,返回一个render对象(又名renderer)。这些render对象最终会被构建成一颗Render树。 - 第四步:有了
Render树后,浏览器开始布局,会为每个Render树上的节点确定一个在显示屏上出现的精确坐标值。 - 第五步:
Render树有了,节点显示的位置坐标也有了,最后就是调用每个节点的paint方法,让它们显示出来。
真正吃性能的是第四步和第五步。前三步在页面首次加载时跑一遍就够了,但布局和绘制会被反复触发,你每改一次几何属性,这一段就得重来。
当你用传统的原生 api 或 jQuery 去操作 DOM 时,浏览器会从构建 DOM 树开始从头到尾执行一遍流程。比如当你在一次操作时,需要更新 10 个 DOM 节点,理想状态是一次性构建完 DOM 树,再执行后续操作。但浏览器没这么智能,收到第一个更新 DOM 请求后,并不知道后续还有 9 次更新操作,因此会马上执行流程,最终执行 10 次流程。显然例如计算 DOM 节点的坐标值等都是白白浪费性能,可能这次计算完,紧接着的下一个 DOM 更新请求,这个节点的坐标值就变了,前面的一次计算是无用功。
这里得补一句现在的情况。现代浏览器其实做了写操作合并,多次样式修改会被攒进一个队列,等到帧末尾统一刷新,并不是真的老老实实跑十遍。但只要你在两次写之间读了一个布局属性,比如 offsetHeight、getBoundingClientRect,浏览器为了给你一个准确的值就必须立刻把队列刷掉,重新算布局。这个叫强制同步布局,也就是俗称的布局抖动。所以「10 次更新触发 10 次流程」这个说法在极端的读写交替代码里是成立的,只是触发条件比原文写的更具体一点。
即使计算机硬件一直在更新迭代,操作 DOM 的代价仍旧是昂贵的,频繁操作还是会出现页面卡顿,影响用户的体验。真实的 DOM 节点,哪怕一个最简单的 div 也包含着很多属性,可以打印出来直观感受一下:
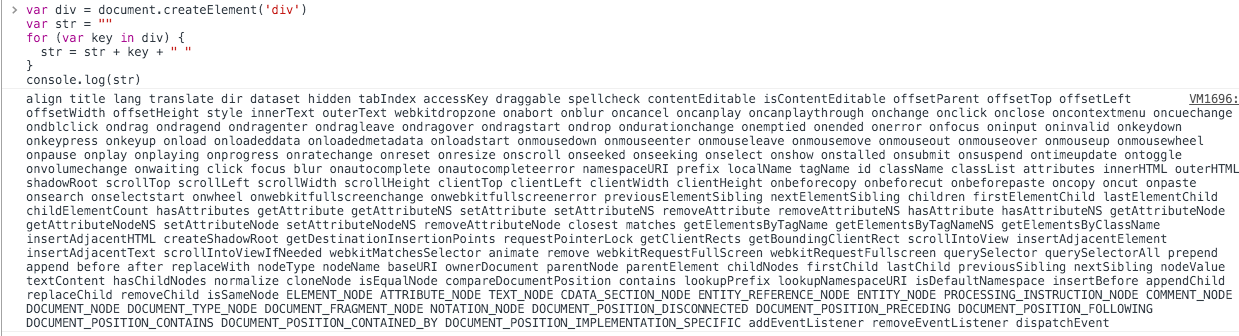
这张图值得多看两眼。上面那一大坨里绝大多数字段你一辈子都用不到,但它们确实挂在每个节点上。你要在这样的对象上做新旧对比,光是决定「比哪些字段」就无从下手。而一个虚拟节点只有三四个字段,比起来毫无压力。
虚拟 DOM 就是为了解决这个浏览器性能问题而被设计出来的。例如前面的例子,假如一次操作中有 10 次更新 DOM 的动作,虚拟 DOM 不会立即操作 DOM,而是将这 10 次更新的 diff 内容保存到本地的一个 js 对象中,最终将这个 js 对象一次性 attach 到 DOM 树上,通知浏览器去执行绘制工作,这样可以避免大量的无谓的计算量。
# 二、实现虚拟DOM
光看定义没感觉,动手写一个最小的实现最快。假设我们要描述的真实结构是这样:
<div id="real-container">
    <p>Real DOM</p>
    <div>cannot update</div>
    <ul>
        <li class="item">Item 1</li>
        <li class="item">Item 2</li>
        <li class="item">Item 3</li>
    </ul>
</div>
用 js 对象来模拟 DOM 节点如下。三层嵌套,和上面那段 HTML 一一对应:
const tree = Element('div', { id: 'virtual-container' }, [
    Element('p', {}, ['Virtual DOM']),
    Element('div', {}, ['before update']),
    Element('ul', {}, [
        Element('li', { class: 'item' }, ['Item 1']),
        Element('li', { class: 'item' }, ['Item 2']),
        Element('li', { class: 'item' }, ['Item 3']),
    ]),
]);

const root = tree.render();
document.getElementById('virtualDom').appendChild(root);
用 js 对象模拟 DOM 节点的好处是,页面的更新可以先全部反映在 js 对象上,操作内存中的 js 对象的速度显然要快多了。等更新完后,再将最终的 js 对象映射成真实的 DOM,交由浏览器去绘制。
Element 本身很朴素,就是一个把参数挂到 this 上的构造函数:
function Element(tagName, props, children) {
    if (!(this instanceof Element)) {
        return new Element(tagName, props, children);
    }

    this.tagName = tagName;
    this.props = props || {};
    this.children = children || [];
    this.key = props ? props.key : undefined;

    let count = 0;
    this.children.forEach((child) => {
        if (child instanceof Element) {
            count += child.count;
        }
        count++;
    });
    this.count = count;
}
第一个参数是节点名(如 div),第二个参数是节点的属性(如 class),第三个参数是子节点(如 ul 的 li)。除了这三个参数会被保存在对象上外,还保存了 key 和 count。
开头那个 if (!(this instanceof Element)) 是个小技巧,让你不写 new 也能调用,所以上面才能直接写 Element('div', ...)。key 后面 diff 列表时要用,先存着。count 记的是这棵子树一共有多少个节点,它的用处在应用补丁那一步,深度遍历时需要知道每个节点对应的全局序号,有了 count 就能直接跳过整棵子树。
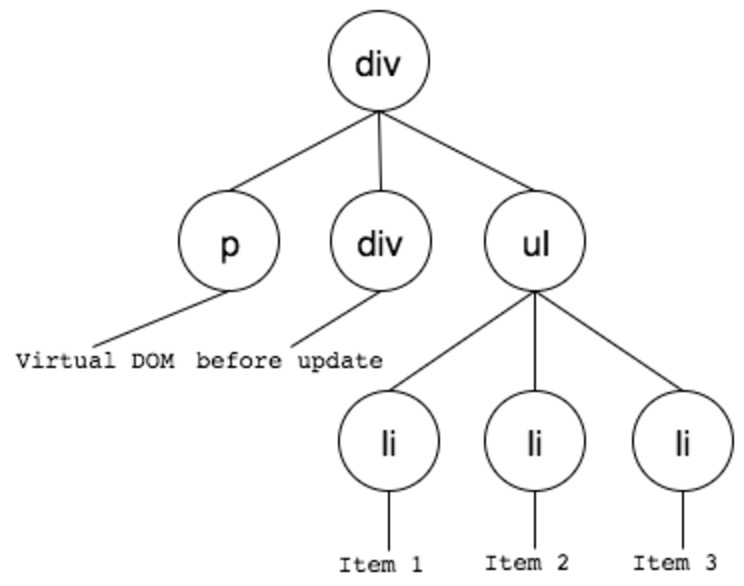
对着这张图理解 count 的累加逻辑:子节点如果本身也是 Element,先把它的 count 加进来,再给它自己算一个,所以最终数出来的是整棵子树的节点总数,不是直接子节点的个数。
有了 js 对象后,最终还需要将其映射成真实的 DOM:
Element.prototype.render = function() {
    const el = document.createElement(this.tagName);
    const props = this.props;

    for (const propName in props) {
        setAttr(el, propName, props[propName]);
    }

    this.children.forEach((child) => {
        const childEl = (child instanceof Element) ? child.render() : document.createTextNode(child);
        el.appendChild(childEl);
    });

    return el;
};
根据 DOM 名调用原生的 createElement 创建真实 DOM,将 DOM 的属性全都加到这个 DOM 元素上,如果有子元素继续递归调用创建子元素,并 appendChild 挂到该 DOM 元素上。这样就完成了从创建虚拟 DOM 到将其映射成真实 DOM 的全部工作。
这里有个细节容易忽略:整个递归过程中,el 一直是游离的,没有挂进文档。只有最外层那个 root 被 appendChild 到页面上时,浏览器才会触发一次布局和绘制。这就是前面说的「攒起来一次性提交」,在这个几十行的实现里已经体现出来了。
# 三、Diff算法
我们已经完成了创建虚拟 DOM 并将其映射成真实 DOM 的工作,这样所有的更新都可以先反映到虚拟 DOM 上。怎么反映呢?需要明确一下 Diff 算法。
- 两棵树如果完全比较时间复杂度是
O(n^3) React的Diff算法的时间复杂度是O(n)。要实现这么低的时间复杂度,意味着只能平层地比较两棵树的节点,放弃了深度遍历- 这样做,似乎牺牲了一定的精确性来换取速度,但考虑到现实中前端页面通常也不会跨层级移动
DOM元素,所以这样做是最优的。
这笔账值得算一下。O(n^3) 里的三次方来自哪里?通用树 diff 要在两棵树之间求最小编辑距离,需要拿第一棵树的每个节点去和第二棵树的每个节点比,还要考虑各种插入删除的组合。一千个节点就是十亿量级的操作,浏览器主线程直接卡死。
放弃跨层匹配之后就简单了,同一层的节点按顺序对一遍,然后各自往下递归。每个节点只被访问一次,复杂度落到 O(n)。
我们新创建一棵树,用于和之前的树进行比较:
const newTree = Element('div', { id: 'virtual-container' }, [
    Element('h3', {}, ['Virtual DOM']),                     // REPLACE
    Element('div', {}, ['after update']),                   // TEXT
    Element('ul', { class: 'marginLeft10' }, [              // PROPS
        Element('li', { class: 'item' }, ['Item 1']),
        // Element('li', { class: 'item' }, ['Item 2']),    // REORDER remove
        Element('li', { class: 'item' }, ['Item 3']),
    ]),
]);


