
第一次看 Koa 的中间件,我卡在了一个很基础的问题上:为什么 await next() 后面的代码,会在所有后续中间件都跑完之后才执行?Express 里 next() 后面的代码明明是立刻就跑的。当时我以为这是 Koa 加了什么魔法,后来把 koa-compose 的源码翻出来看了一遍,发现它总共就十几行,没有任何魔法,就是一个 Promise 链的递归拼接。
这篇是我重新梳理 Koa2 的笔记。上半部分是原理,把洋葱模型的 compose 实现和 ctx 的委托机制讲透;下半部分是配套的路由、模板引擎、Cookie、Session 这些日常要用的模块。原理搞清楚之后,那些模块的行为就都能推出来了。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- Koa 为什么会出现,它到底解决了 callback 时代的什么痛点
- 洋葱模型的执行顺序,以及
koa-compose那十几行代码怎么实现的 ctx上那一堆属性是从哪来的,delegates 委托是怎么回事- Koa 中间件和 Express 中间件的本质差异,为什么错误处理差那么多
- koa-router 的路由、get 传值、动态路由
- 应用级、路由级、错误处理、第三方四类中间件的写法
- ejs 和 art-template 两个模板引擎的接入
- Cookie、Session 的使用与两者的取舍
- 路由模块化拆分的做法
# 一、Koa 出现是为了解决什么
Node.js 是一个异步的世界,早期官方 API 支持的都是 callback 形式的异步编程模型,这会带来几个很实际的问题。
一个是 callback 嵌套。查数据库拿到用户,再查订单,再查商品,三层下来代码就往右缩进出屏幕了,错误处理还得在每一层各写一遍 if (err)。
另一个更隐蔽,异步函数中有可能同步调用 callback 返回数据,带来执行时机的不一致性。同一个函数,有缓存时同步回调,没缓存时异步回调,调用方写出来的代码在两种路径下行为不同,这种 bug 特别难查。
为了解决这些问题,Koa 出现了。
Koa 是由 Express 原班人马打造的,定位是一个更小、更富有表现力、更健壮的 Web 框架。使用 Koa 编写 Web 应用,可以免除重复繁琐的回调函数嵌套,并极大地提升错误处理的效率。Koa 不在内核方法中绑定任何中间件,它仅仅提供了一个轻量优雅的函数库,使得编写 Web 应用变得得心应手。开发思路和 Express 差不多,最大的特点就是可以避免异步嵌套。
我自己的感受是,Koa 的核心库小到可以一个下午读完,这在框架里是很少见的。它把路由、body 解析、静态文件这些全都扔给社区,自己只留下中间件机制和 ctx 这两样东西。要吐槽的话就是什么都得自己装,但用久了会觉得这个取舍是对的。
# 二、环境搭建
# 2.1 Node 版本要求
开发 Koa2 之前,Node.js 是有要求的,它要求 Node.js 版本高于 v7.6。因为 Node.js 7.6 版本开始完整支持 async/await,Koa2 的中间件写法整个建立在 async 函数之上,版本低了直接跑不起来。
这条限制在 2019 年还是要提一句的,现在基本可以忽略了,主流的 Node 18、Node 20、Node 22 都早已原生支持。另外 Koa 后来也发布了新的大版本,最低 Node 版本要求和一部分细节有调整,具体以官方文档为准。
# 2.2 安装 Koa
安装 Koa 框架和安装其他模块是一样的。
npm install --save koa / cnpm install --save koa
--save 参数表示自动修改 package.json 文件,自动添加依赖项。这个参数在 npm 5 之后已经是默认行为了,写不写都会写进依赖,老教程里带着它是历史原因。
装完之后一个最小的 Koa 应用长这样。
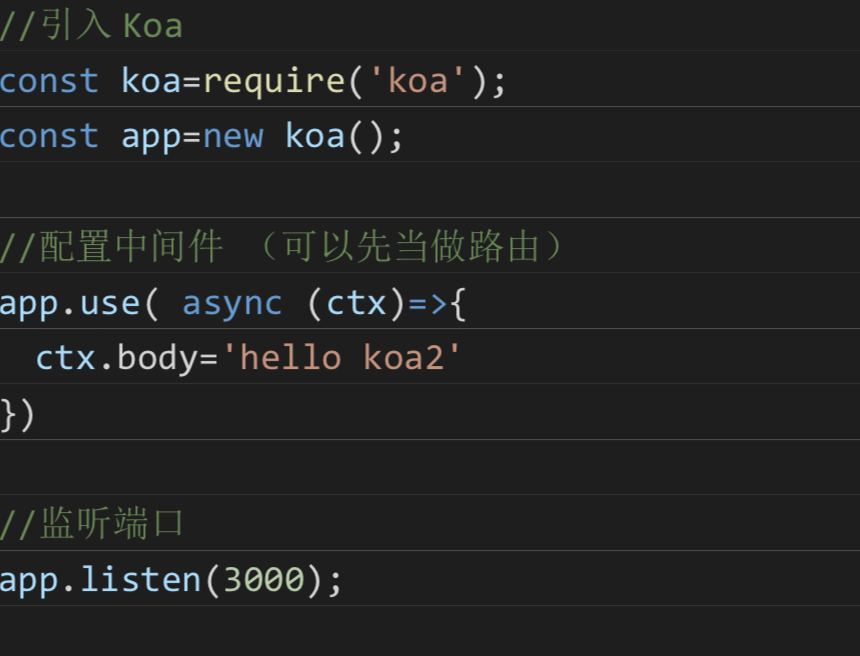
new Koa() 拿到 app 实例,app.use() 注册中间件,app.listen() 起服务。整个框架对外暴露的核心 API 基本就这三个,剩下的都是围绕 ctx 展开的。
# 三、洋葱模型到底是怎么跑起来的
这一节是全文的重点,前面都是铺垫。
# 3.1 先看现象
Koa 的中间件执行顺序被称为洋葱圈模型,先由外向内一层层进去,到最里面之后再由内向外一层层出来。
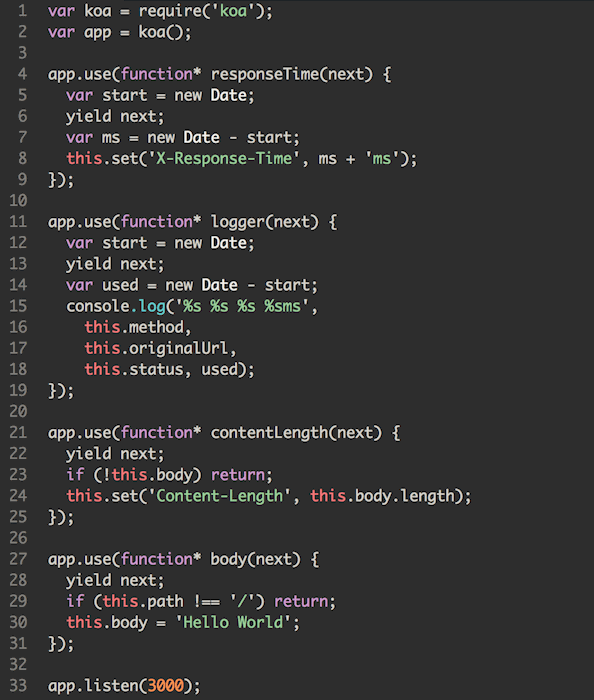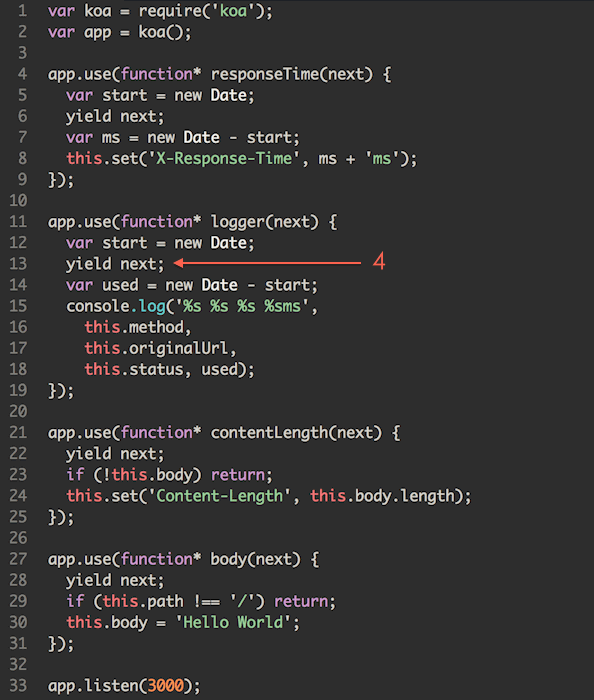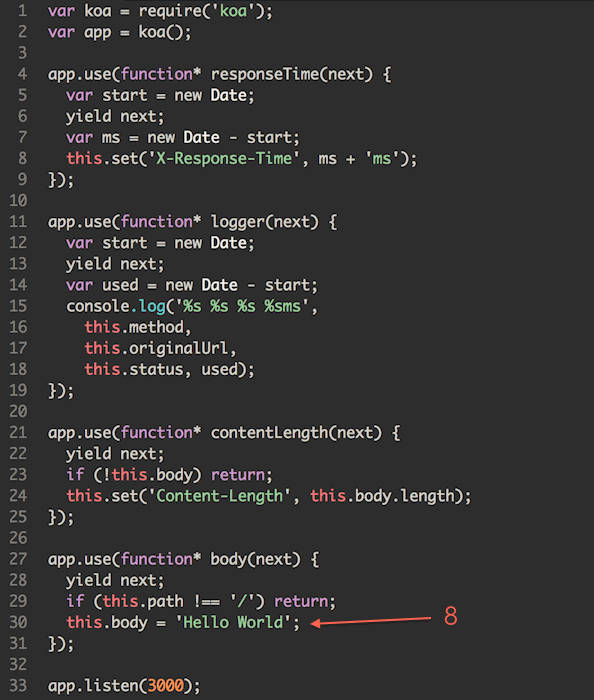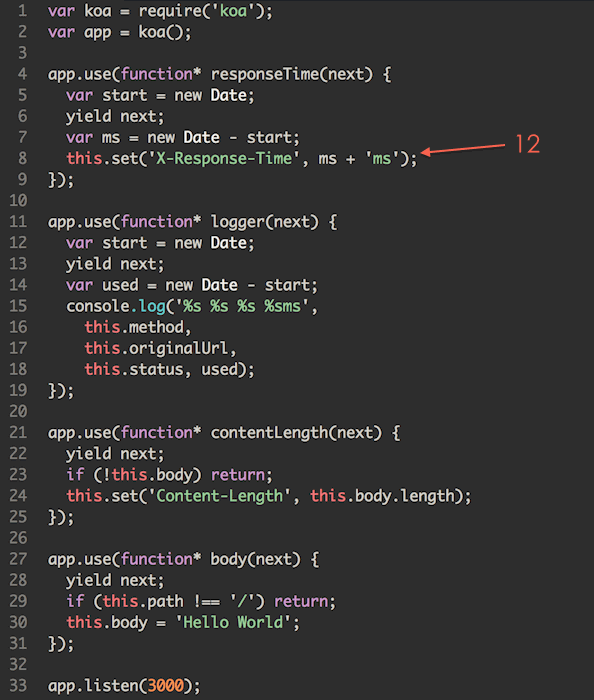
用代码表达就是这样。
app.use(async (ctx, next) => {
  console.log('1 进入')
  await next()
  console.log('1 出来')
})

app.use(async (ctx, next) => {
  console.log('2 进入')
  await next()
  console.log('2 出来')
})

app.use(async (ctx, next) => {
  console.log('3 处理')
  ctx.body = 'hello'
})
打印顺序是 1 进入 → 2 进入 → 3 处理 → 2 出来 → 1 出来。
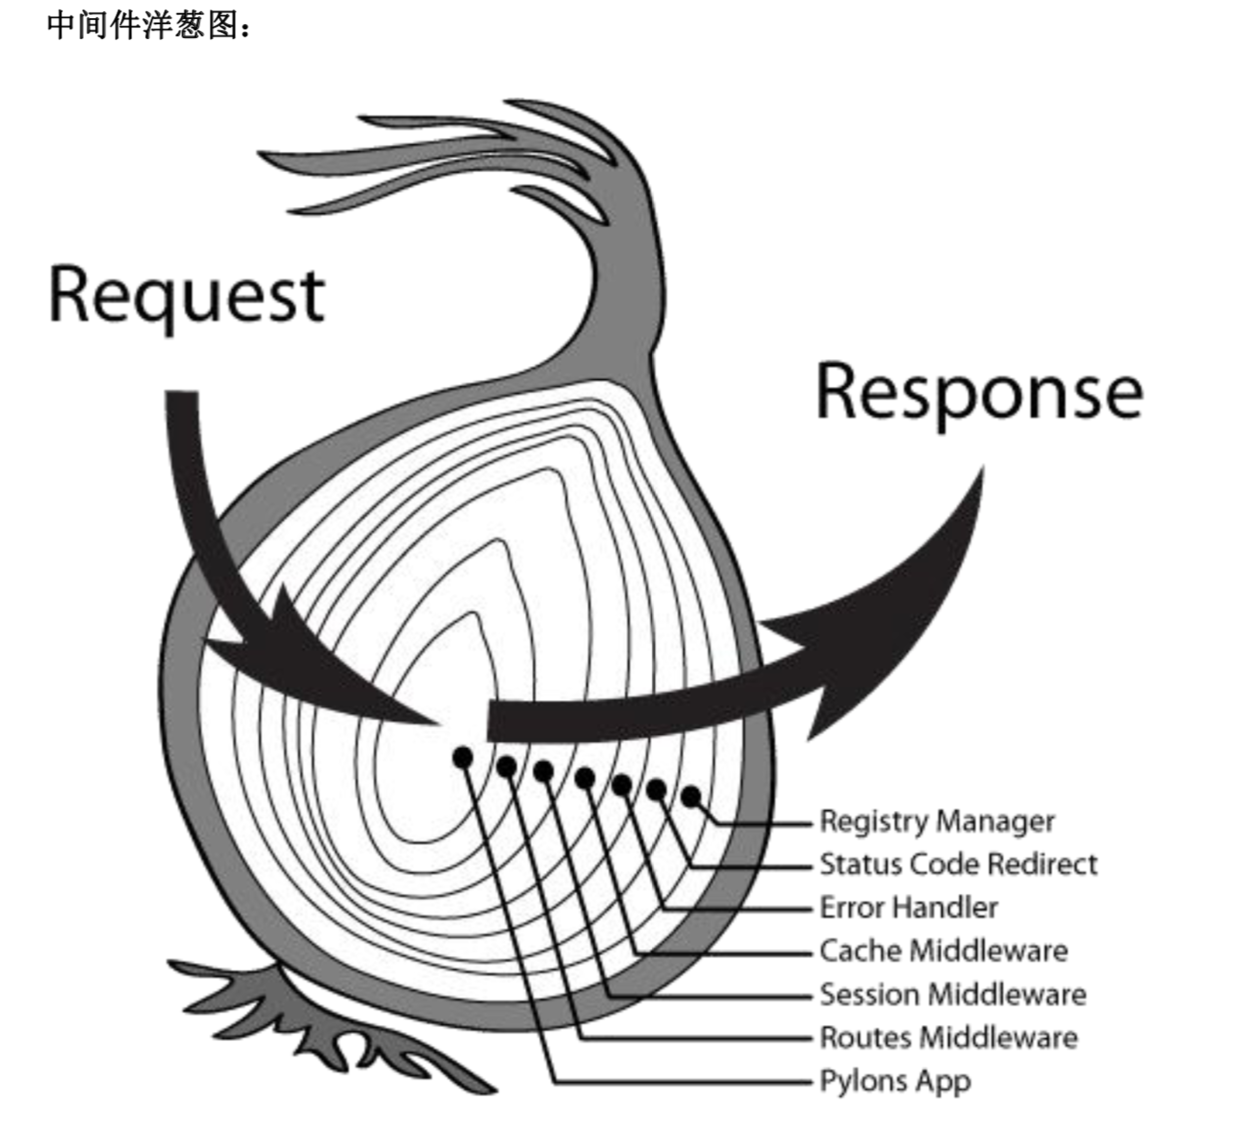
这个顺序的价值在哪?做耗时统计的时候,你在最外层中间件的 await next() 前后各打一个时间戳,中间的差值就是后面所有中间件加起来的总耗时,一行不用改业务代码。响应头统一处理、错误统一捕获、日志统一记录,全都靠这个「出来」的阶段。
# 3.2 我一开始的错误理解
我最早以为 Koa 是把中间件收集起来,先正着跑一遍再倒着跑一遍,跑了两轮。
这个理解是错的。中间件函数一共只被调用一次,「进去」和「出来」是同一次函数调用的前半段和后半段,中间被 await next() 切开了。await 会让当前函数在这一行挂起,把执行权交给下游,等下游返回的 Promise 完成后再从这一行继续往下走。
所以洋葱模型不是框架设计出来的什么特殊调度,它就是 async 函数天然的行为。Koa 做的事情只有一件:把这些函数按正确的方式串起来。
# 3.3 koa-compose 的实现
串起来这件事由 koa-compose 完成,核心是这么一段。
function compose (middleware) {
  return function (context, next) {
    let index = -1
    return dispatch(0)

    function dispatch (i) {
      if (i <= index) return Promise.reject(new Error('next() called multiple times'))
      index = i
      let fn = middleware[i]
      if (i === middleware.length) fn = next
      if (!fn) return Promise.resolve()
      try {
        return Promise.resolve(fn(context, dispatch.bind(null, i + 1)))
      } catch (err) {
        return Promise.reject(err)
      }
    }
  }
}
一行行拆开看。
dispatch(i) 负责执行第 i 个中间件。关键在倒数第三行,传给中间件的第二个参数是 dispatch.bind(null, i + 1),也就是说你在中间件里调用的那个 next,其实就是「执行下一个中间件」这个动作本身。你不调它,链条就断在这里,后面的中间件一个都不会执行。
Promise.resolve(fn(...)) 这一层包装是为了兼容。中间件可以是 async 函数(返回 Promise),也可以是普通函数(返回 undefined 或别的值),包一层之后统一都是 Promise,await next() 才能一直成立。
index 那两行是防重复调用的守卫。同一个中间件里写两次 await next(),第二次进来时 i <= index 成立,直接 reject 一个明确的错误。没有这个守卫的话,重复调用会导致下游中间件被执行两遍,响应写两次,问题现场特别混乱。
try/catch 包住同步执行阶段,把同步抛出的异常也转成 rejected Promise。这样不管中间件是同步抛错还是异步 reject,对上游来说都是一个 rejected Promise,可以用同一个 try/catch 接住。
回到最开始那个问题:为什么 await next() 后面的代码会在下游全部跑完之后才执行?因为 next() 返回的是 dispatch(i + 1) 的返回值,而 dispatch(i + 1) 返回的是下游中间件那个 async 函数的 Promise,这个 Promise 要等到下游函数体整个执行完(包括它内部的 await next())才 resolve。一层套一层,最终形成一条完整的 Promise 链。
没有魔法,就是 Promise 的递归组合。
# 3.4 错误处理为什么变简单了
理解了上面这条 Promise 链,就能明白 Koa 的错误处理为什么好用。
只要在最外层放一个中间件,用 try/catch 包住 await next(),整条链上任何一层抛出的错误都会被它接到。
app.use(async (ctx, next) => {
  try {
    await next()
  } catch (err) {
    ctx.status = err.status || 500
    ctx.body = { message: err.message }
    ctx.app.emit('error', err, ctx)
  }
})
这在 callback 时代是做不到的。回调里抛出的异常不在调用方的调用栈上,外层 try/catch 根本抓不住,只能每层各写一遍 if (err) return next(err)。
# 四、ctx 上那一堆属性是从哪来的
用 Koa 的时候你会写 ctx.body、ctx.query、ctx.status、ctx.path,但 Koa 的源码里 context.js 这个文件其实没定义这些属性。它们是委托来的。
Koa 把请求和响应分别封装成 ctx.request 和 ctx.response 两个对象,真正的属性定义在 request.js 和 response.js 里。然后用 delegates 这个小模块,把这两个对象上的属性和方法「代理」到 ctx 上。
大致是这个意思。
const delegate = require('delegates')
const proto = module.exports = { /* ... */ }

delegate(proto, 'response')
  .method('redirect')
  .access('status')
  .access('body')
  .getter('headerSent')

delegate(proto, 'request')
  .access('query')
  .access('path')
  .getter('href')
  .getter('ip')
access 生成一对 getter 和 setter,getter 只生成读,method 代理方法调用。所以你写 ctx.body = 'hello',实际执行的是 ctx.response.body = 'hello';你读 ctx.query,实际读的是 ctx.request.query。
这个设计有两个好处。一是用起来短,不用每次都写 ctx.request.query。二是职责还是分开的,请求和响应的实现代码各在各的文件里,没有揉成一坨。


