
项目里第一次出现「点两下登录按钮发了两个请求」这种问题的时候,我用 redux-thunk 的写法是在 action 里加一个 loading 标记位挡住。挡是挡住了,但接着又来了「切页面时要取消上一个未完成的请求」「登录成功后自动拉一次列表,拉列表失败不影响登录状态」这类需求,标记位越加越多,一个 action 文件里塞满了 if (loading) return。
那时候才意识到 thunk 解决的只是「redux 能不能接受异步」,没解决「异步流程怎么编排」。redux-saga 补的正是后面这块。这篇从 redux 为什么需要中间件讲起,拆 thunk 那十几行源码,再把 saga 的几个核心 Effect 逐个过一遍,最后配两个完整案例。文章写于 2018 年,末尾我另外补了一节现在的选型判断。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- redux 的数据流为什么装不下副作用,中间件插在哪个位置
- redux-thunk 的完整源码,以及它为什么只有十几行
- thunk 的局限:action 形式不统一、异步逻辑分散
- redux-saga 的 watch / worker 工作模式和它的四个优点
take、call、put、select、fork、takeEvery、takeLatest逐个拆- 阻塞调用和非阻塞调用的差别,以及它导致的真实体验问题
- 一个登录登出加列表加载的完整案例,和一套工程化目录结构
- thunk 和 saga 到今天该怎么选
# 一、redux-thunk
# 1.1 redux 的副作用处理
先看 redux 原本的数据流长什么样:
UI—————>action(plain)—————>reducer——————>state——————>UI

redux 是遵循函数式编程规则的。上述数据流中,action 是一个原始 js 对象(plain object),reducer 是一个纯函数。对于同步且没有副作用的操作,这条流水线足以管理数据、控制视图层更新。
问题出在「纯函数」这三个字上。发请求、读 localStorage、setTimeout 这些都是副作用,塞进 reducer 就破坏了纯度,reducer 一旦不纯,时间旅行调试和可预测性就全废了。
所以如果存在副作用函数,我们需要先处理副作用,然后生成原始的 js 对象。redux 的选择是在发出 action 到 reducer 处理函数之间插一层中间件来处理。
增加中间件之后的数据流大致如下:
UI——>action(side function)—>middleware—>action(plain)—>reducer—>state—>UI
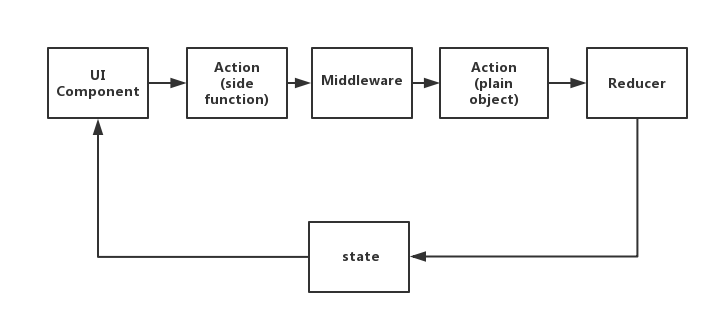
在有副作用的 action 和原始的 action 之间增加中间件处理,从图里能看出中间件的职责只有一个:把异步操作转换掉,生成原始的 action。这样 reducer 函数就能处理相应的 action,从而改变 state、更新 UI。
这个设计我觉得挺聪明的。它没有去改 reducer 的规则,而是在 action 到达 reducer 之前加了一道「提纯」工序,脏活全在中间件里干完,reducer 那边看到的永远是干净的普通对象。中间件机制本身是怎么用 compose 串起来的,我在 手写一个迷你版 Redux 里逐行实现过。
# 1.2 redux-thunk 源码
在 redux 中,thunk 是 redux 作者给出的中间件,实现极为简单,十几行代码:
function createThunkMiddleware(extraArgument) {
  return ({ dispatch, getState }) => next => action => {
    if (typeof action === 'function') {
      return action(dispatch, getState, extraArgument);
    }

    return next(action);
  };
}

const thunk = createThunkMiddleware();
thunk.withExtraArgument = createThunkMiddleware;

export default thunk;
这几行代码做的事情很简单:判别 action 的类型,如果 action 是函数,就调用这个函数,调用的形式为
action(dispatch, getState, extraArgument);
传进去的实参是 dispatch 和 getState,所以我们定义 thunk 形式的 action 时,形参一般就写这两个。如果 action 不是函数,就 next(action) 原样往下传给下一个中间件,跟没装过一样。
值得多看一眼的是这行嵌套箭头函数:({ dispatch, getState }) => next => action => {}。这就是 redux 中间件的标准签名,三层柯里化,第一层拿 store 的能力,第二层拿链条上的下一环,第三层才是真正处理 action 的地方。所有 redux 中间件都长这个样子,看懂这一个就都看懂了。
withExtraArgument 是给依赖注入用的。比如你想在所有 thunk 里都能直接拿到 axios 实例,就 applyMiddleware(thunk.withExtraArgument(api)),之后每个 thunk 的第三个参数就是它,省得到处 import。
# 1.3 redux-thunk 的缺点
thunk 的缺点也很明显。它仅仅做了「执行这个函数」这一件事,并不在乎函数主体内是什么。thunk 使得 redux 可以接受函数作为 action,但函数内部可以写成什么样完全没有约束。
比如下面是一个获取商品列表的异步操作所对应的 action:
export default ()=>(dispatch)=>{
    fetch('/api/goodList',{ //fecth返回的是一个promise
      method: 'get',
      dataType: 'json',
    }).then(function(json){
      var json=JSON.parse(json);
      if(json.msg==200){
        dispatch({type:'init',data:json.data});
      }
    },function(error){
      console.log(error);
    });
};
从这个具有副作用的 action 里能看出,函数内部相当复杂:fetch 的配置、状态码判断、JSON 解析、错误处理全挤在一起。如果每一个异步操作都要这么定义一个 action,维护成本会飞快上涨。
具体不易维护的地方有两处。一是 action 的形式不统一,同步的是对象,异步的是函数,处理它们的心智模型完全不同。二是异步操作太分散,散落在各个 action 文件里,你想知道这个项目一共发了多少种请求,只能靠全局搜索。
这里还有个更细的问题:这段代码基本没法做单元测试。要测它就得 mock 掉 fetch,而 fetch 是在函数内部直接调用的,你没有插手的余地。
# 二、redux-saga 简介
redux-saga 是一个 redux 中间件,它有四个特性:集中处理 redux 副作用问题;被实现为 generator;属于类 redux-thunk 的中间件;采用 watch / worker(监听到执行)的工作形式。
最后那条是它和 thunk 结构上最大的差别。thunk 是「你 dispatch 一个函数,我帮你执行」,saga 是「你正常 dispatch 普通对象,我在旁边一直盯着,看到感兴趣的就自己动手」。UI 那边根本不知道 saga 存在。
redux-saga 的优点
- 集中处理了所有的异步操作,异步接口部分一目了然
action是普通对象,这跟 redux 同步的 action 一模一样- 通过
Effect,方便异步接口的测试 - 通过 worker 和 watcher 可以实现非阻塞异步调用,同时还能实现非阻塞调用下的事件监听
- 异步操作的流程是可以控制的,可以随时取消相应的异步操作
第三条我想多说两句,因为它是 saga 最被低估的价值。saga 里所有副作用都不是直接执行的,而是先 yield 一个描述对象出来,由中间件负责真正执行。测试的时候你只要检查「它 yield 出来的描述对象对不对」,完全不用 mock 网络层。这个设计是真的舒服。
基本用法
使用 createSagaMiddleware 方法创建 saga 的 Middleware,然后在创建 redux 的 store 时,用 applyMiddleware 函数把 saga Middleware 实例绑定到 store 上,最后调用 saga Middleware 的 run 函数来执行某个或者某些 saga。
在 saga 里,可以使用 takeEvery 或者 takeLatest 等 API 监听某个 action。当某个 action 触发后,saga 用 call 发起异步操作,操作完成后使用 put 函数触发新的 action,同步更新 state,从而完成整个 State 的更新。
# 三、redux-saga 使用案例
redux-saga 是受控执行的 generator。在 redux-saga 中 action 是原始的 js 对象,所有异步副作用操作都放在 saga 函数里面。这样既统一了 action 的形式,又让异步操作能被集中处理。
redux-saga 是通过 generator 实现的,如果运行环境不支持 generator,需要通过 babel-polyfill 转义。这一条在 2018 年还挺重要,那会儿要兼容的浏览器版本比现在低不少。
先从一个输出 hello saga 的最小例子开始。
创建一个 helloSaga.js 文件
export function * helloSaga() {
  console.log('Hello Sagas!');
}
这个 generator 现在什么都没做,只是打印一句话,用来验证 saga 确实被中间件跑起来了。
在 redux 中使用 redux-saga 中间件
接下来在 main.js 里把中间件装上:
import { createStore, applyMiddleware } from 'redux'
import createSagaMiddleware from 'redux-saga'
import { helloSaga } from './sagas'
const sagaMiddleware=createSagaMiddleware();
const store = createStore(
 reducer,
 applyMiddleware(sagaMiddleware)
);
sagaMiddleware.run(helloSaga);
//会输出Hello, Sagas!
和调用 redux 的其他中间件一样,想使用 redux-saga 中间件,只要在 applyMiddleware 中传入一个 createSagaMiddleware 的实例。唯一不同的是需要额外调用 run 方法,generator 才会开始执行。
这个 run 是必须的,忘了它就是新手最常见的「saga 一点反应都没有」。原因是 saga 不像别的中间件那样被动等 action,它需要主动启动一个根 generator 来铺开所有监听。


