
写 React 的人多半有过这种经历:给子组件传了一个对象,在 shouldComponentUpdate 里做浅比较,结果页面死活不更新。查半天发现是自己在父组件里直接 this.state.list.push(item) 改了原数组,引用没变,浅比较自然判定「没变化」。这类 bug 不报错、不崩溃,只是页面不动,最难查。Immutable.js 就是冲着这个问题来的。这篇不重复罗列 API,而是回头看它的设计思路:为什么要让数据不可变,每次返回新对象为什么不会把内存撑爆,底层那棵 Trie 树是怎么回事,以及什么项目真的值得引入它。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- 共享引用会带来哪些具体的 bug,深拷贝为什么不是好的解法
- 持久化数据结构是什么意思,「持久化」这个词容易被误解成什么
- 结构共享怎么做到「返回新对象但只复制一条路径」
- 底层的 Trie 树长什么样,为什么分支因子是 32
- Immutable 提供的几种数据结构各自对应什么场景
fromJS/toJS/is这三个出入口的设计意图和使用边界- 读取、修改、合并这几类操作背后统一的规则
- 什么项目该用它,什么项目用了反而是负担
# 一、问题的起点,共享引用
JavaScript 里对象和数组是引用类型,这件事人人都知道,但它在状态管理里造成的麻烦被低估了。
const state = { list: [1, 2, 3] };
const prev = state.list;

state.list.push(4);

console.log(prev === state.list); // true
console.log(prev);                // [1, 2, 3, 4]
你以为 prev 存的是「变化之前的样子」,其实它和 state.list 是同一个数组。想拿它做对比,一点用都没有。
React 的 PureComponent 和 React.memo 做的是浅比较,Redux 判断 state 有没有变也是比引用。你在原地改了对象,引用没动,这些优化机制全部失效。反过来,如果你每次都造一个全新的对象,浅比较又会因为引用总是变而永远返回「变了」,优化同样失效。
夹在中间的解法是深拷贝。改之前先把整棵状态树拷一份,然后在副本上改。逻辑是对的,代价太高:状态树有一万个节点,你只改了其中一个,却复制了一万个。深拷贝本身还有一堆边界要处理,循环引用、Date、RegExp、Symbol 键,这些我在 JS深拷贝的几种实现 里单独写过。
所以真正想要的是这样一种东西:改一个字段返回一个新对象,但没改的那部分不复制,直接复用。
这就是 Immutable.js 的全部出发点。
# 二、持久化数据结构
「持久化」这个词第一次看到很容易误会成存到磁盘或者 localStorage,其实完全没关系。它在数据结构里的意思是:修改操作不会破坏旧版本,旧版本在修改之后依然可用。
普通数组是「短暂的」,push 之后原来那个版本就没了。持久化数组是每次操作都产出一个新版本,所有历史版本同时存在,谁都能继续访问。
const list1 = Immutable.List([1, 2, 3]);
const list2 = list1.push(4);

console.log(list1.toJS()); // [1, 2, 3]  旧版本还在
console.log(list2.toJS()); // [1, 2, 3, 4]
这个特性顺带解决了很多别的问题。撤销重做不用自己维护历史栈了,把每一步的引用存下来就行;时间旅行调试能实现,也是因为每一次 state 变化都留下了一个完整可访问的快照。
代价当然存在,就是每次操作都要造新节点。所以关键问题变成了:造多少个新节点。
# 三、结构共享
答案是只造被修改路径上的那几个。
设想一棵状态树,根节点下面挂着 user、list、config 三个子树。现在你要改 user.name。结构共享的做法是:新建一个 name 已经改好的 user 对象,新建一个根对象让它指向新的 user,而 list 和 config 这两个子树的引用原样搬过去。
const oldState = Immutable.fromJS({
  user: { name: 'a', age: 18 },
  list: [1, 2, 3],
  config: { theme: 'dark' }
});

const newState = oldState.setIn(['user', 'name'], 'b');

console.log(oldState.get('list') === newState.get('list'));     // true  没动,共享
console.log(oldState.get('user') === newState.get('user'));     // false 路径上,新建
一棵一万个节点的树,改一个叶子,新建的节点数量是从根到那个叶子的路径长度,也就是树的高度。剩下的九千多个节点一个都没碰。
这一行是整个库最值得记住的一句话:新建的只有路径,其余全部复用。
它同时解释了为什么用了 Immutable 之后 === 又变得可靠了。没改过的子树引用不变,props.list === prevProps.list 直接为 true,浅比较可以放心用;改过的子树引用必然变,也不会漏更新。
# 四、底层是一棵 Trie 树
要让「树的高度」这个代价足够小,树就不能太深。Immutable.js 用的是分支因子为 32 的 Trie(前缀树)。
List 用的是位分区的向量 Trie:把下标的二进制位每 5 位切一段(2 的 5 次方等于 32),每一段决定在这一层走哪个分支。一万个元素的 List,深度是以 32 为底的对数,大概三层。所以改一个元素,新建的节点是个位数。
Map 用的是 HAMT(哈希数组映射 Trie):先算 key 的哈希,同样按位切分来定位。查找和写入的复杂度在实践中接近常数时间。
分支因子选 32 是一个权衡。分支越多树越矮,路径越短,复制的节点越少;但每个节点内部的数组越大,新建一个节点时要复制的数组元素也越多。32 是这两者之间比较舒服的位置,Clojure 的持久化数据结构最早用的也是这个值,Immutable.js 沿用了这套设计。
这块我只在几千条数据的 demo 上量过,深度和理论值对得上,更大规模的实际表现没实测过,具体数字以官方 benchmark 为准。
# 五、Immutable几种数据结构
理解了底层,再看它提供的这几种结构就顺了。
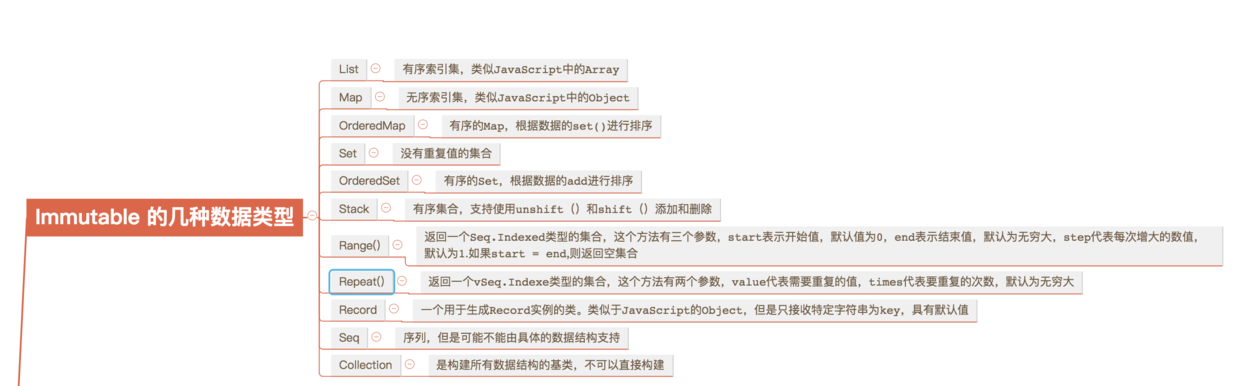
这张图里最常用的是 List 和 Map,对应原生的数组和对象。剩下的几个是补充:需要去重用 Set,需要保证遍历顺序用 OrderedMap 和 OrderedSet,字段固定的对象用 Record 能拿到默认值和更好的类型提示。
有个易错点要提一句:Map 不保证遍历顺序。很多人拿它当 Object 用,然后在渲染列表时发现顺序会变。业务上依赖顺序的地方,要么用 OrderedMap,要么干脆用 List 存有序集合。
另外 Seq 这一类是惰性的,链式调用 map().filter().take(3) 不会遍历整个集合,只在真正取值时按需计算。处理大集合又只要前几项的时候用它能省不少。
# 六、fromJS
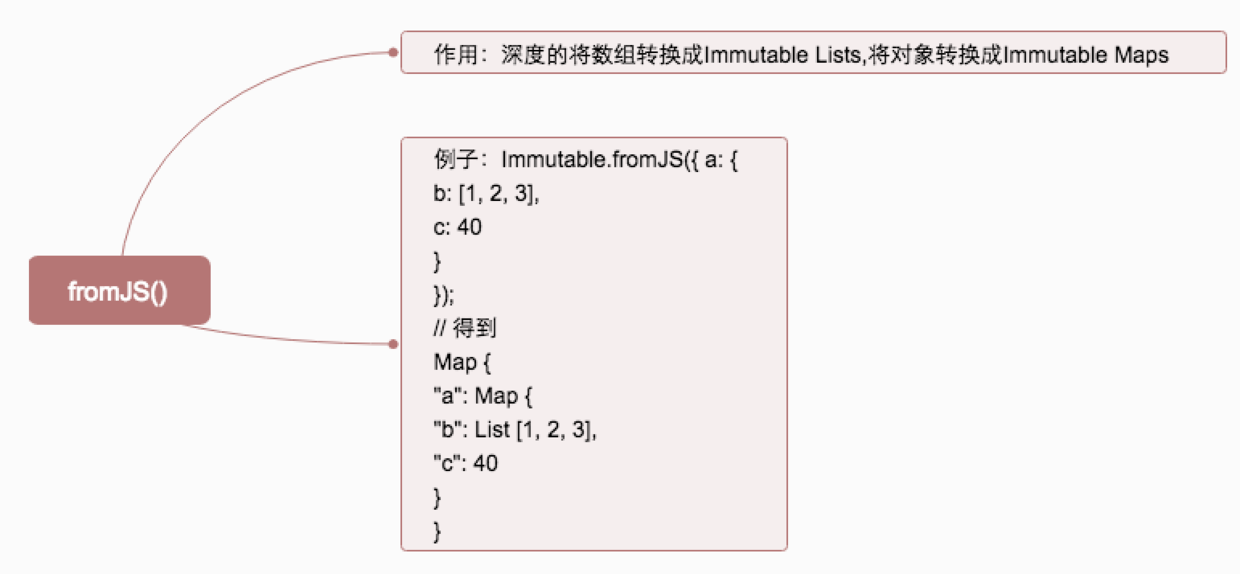
fromJS 是从原生世界进入 Immutable 世界的入口,默认把 Array 转成 List,Object 转成 Map,而且是深转换,嵌套多少层转多少层。
这里的重点是它的代价:整棵结构都要遍历一遍并重建。所以它该出现在数据入口处,比如接口响应刚拿到的时候转一次,而不是在渲染函数或者 reducer 里反复调用。
易错点是「转不彻底」。直接写 Map({ a: { b: 1 } }) 只转了最外层,里面那个 { b: 1 } 还是原生对象,你对它调 get 会报错。要整棵转就老老实实用 fromJS。
# 七、toJS
toJS 是反方向的出口,同样是深转换。它的设计意图很明确,交给不认识 Immutable 的第三方库时用。
这个方法是被滥用最严重的一个。在 React 里写 this.props.data.toJS() 取值,每次调用都会新建一整棵原生结构,引用必然是新的,PureComponent 的浅比较直接失效,你花力气引入 Immutable 换来的优化全被这一行抵消掉。
正确的做法是一路用 get / getIn 取值,只在数据要离开你的组件树时才 toJS。只想转一层的话有 toObject() 和 toArray(),它们不递归,便宜得多。
# 八、Is
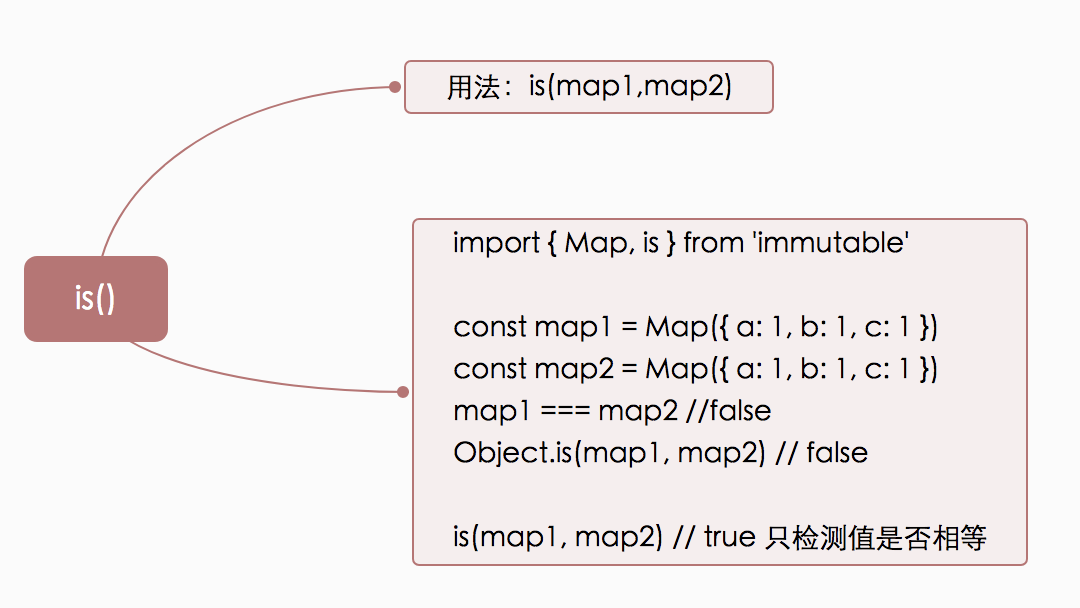
is(a, b) 做的是值相等判断。它内部先试引用相等,不等再调用两边的 equals 方法递归比较内容。
那既然有结构共享,=== 已经够用了,为什么还需要 is?因为有些对象来源不同。两份从不同接口拿回来的数据,内容可能完全一样,但它们是分别 fromJS 出来的,引用不可能相同。这时候要判断「内容是不是一样」,只能用 is。
易错点是别拿它跟原生对象比。is(Map({a:1}), {a:1}) 是 false,两边类型都不一样。同理 list.includes({a: 1}) 也永远是 false,因为 includes 内部用的就是 is。
# 九、数据读取
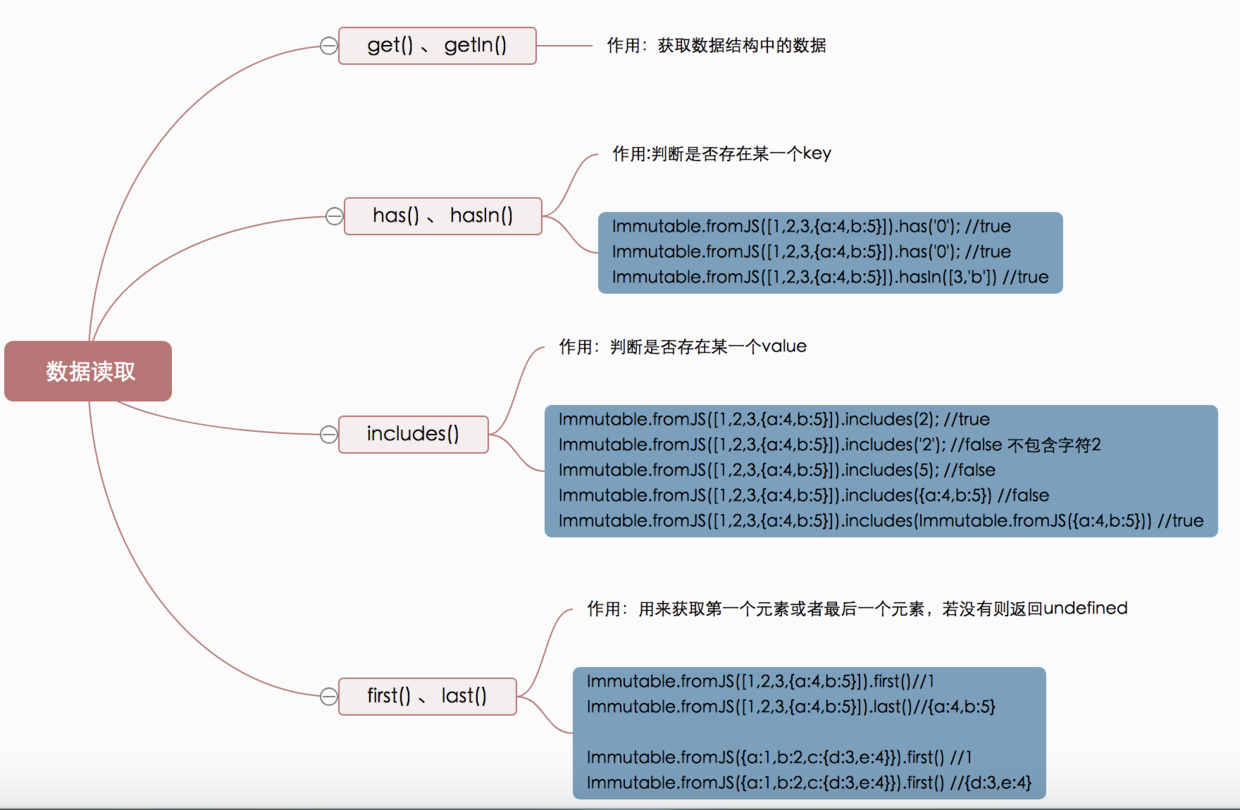
读取这一族的设计有个统一规律:不带 In 的取一层,带 In 的接一个路径数组走深层。get / getIn、has / hasIn 都是这个套路。
这套设计有个原生对象比不了的好处,路径中间断了不会抛错。原生写 state.a.b.c 只要 a 是 undefined 就直接报 Cannot read property,而 getIn(['a','b','c']) 老老实实返回 undefined,还能传第二个参数当兜底值。可选链出现之前,这一点省了不少防御性代码。
重点是要习惯「取值必须调方法」这件事。这也是 Immutable 侵入性最强的地方,一旦用了,整个项目所有取值点的写法都得改,TypeScript 的类型推导也跟着变弱。
# 十、数据修改
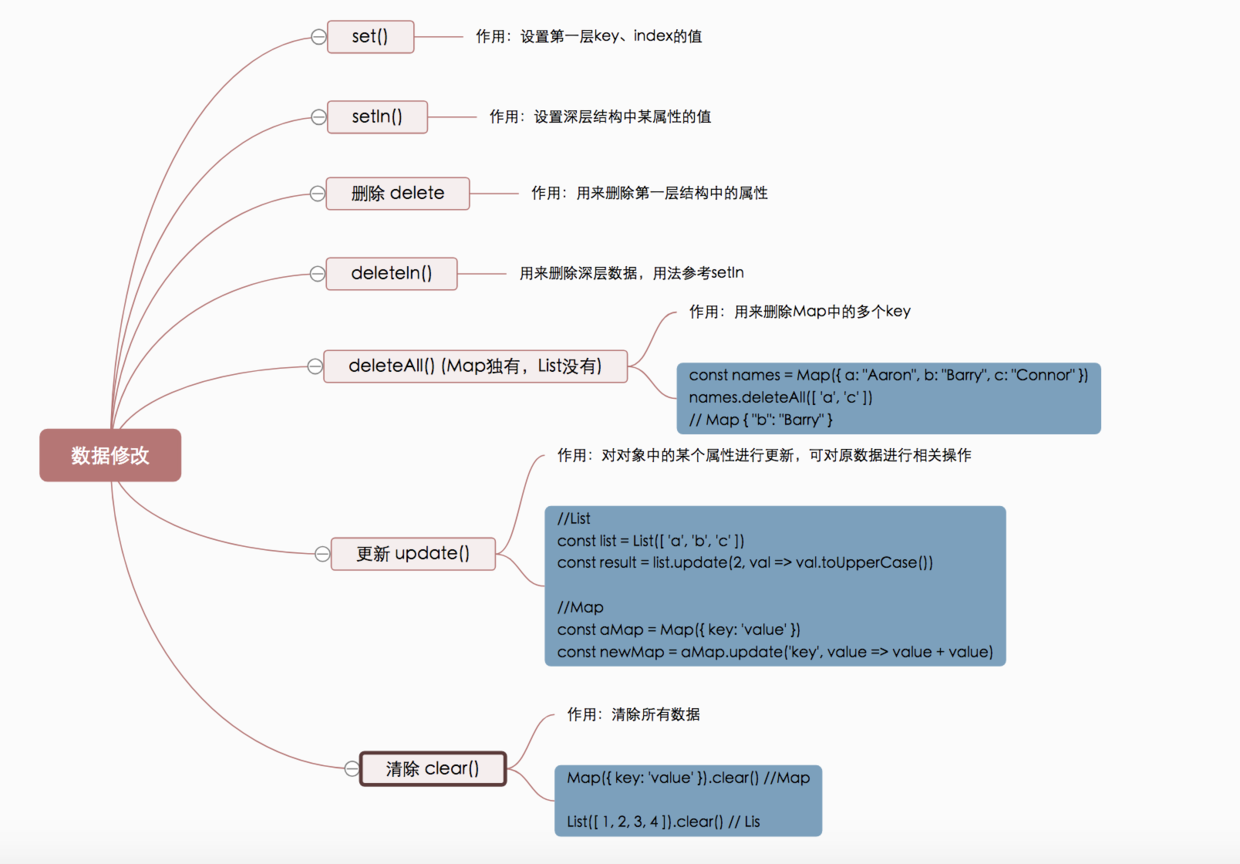
修改这一族的规则只有一条:全都返回新对象,原对象一个字节都不动。
所以最常见的低级错误就是漏掉赋值。list.push(4) 这一行单独写等于什么都没干,必须写成 list = list.push(4) 或者接到新变量上。刚上手的时候这个错误我犯过不止一次,而且它不报错,只表现为「数据没更新」,得靠打印才发现。
set 和 update 的区别值得说一下。set 直接给新值,update 接一个函数并能拿到旧值。要写「计数加一」这类依赖旧值的更新,update 比先 get 再 set 干净。
还有一个坑在 List 上:set 越界不会报错,会用 undefined 把中间的位置补齐,长度直接涨上去。List([1,2,3]).set(5, 9) 得到的是一个 size 为 6 的 List。
# 十一、List中的各种删除与插入
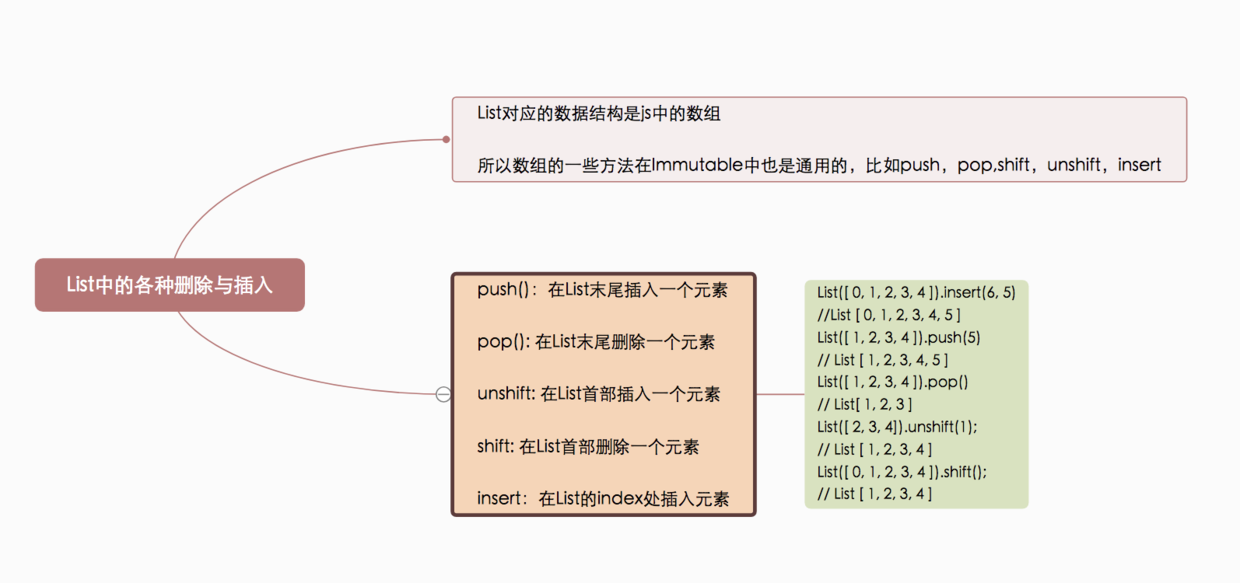
这些方法名字和原生数组一样,行为却不一样,是最容易想当然的一块。
原生的 pop() 返回被弹出的那个元素,Immutable 的 pop() 返回的是删掉末位之后的新 List。想同时拿到被删的元素,得先 last() 再 pop()。shift() 同理。
从底层结构上还能推出一件事:往尾部 push 很便宜,只需要新建从根到尾部的那一条路径;往头部 unshift 要贵一些,因为后面所有元素的索引都得跟着挪。数据量大又频繁在头部插入的话,考虑倒着存再倒着渲染。
# 十二、关于merge
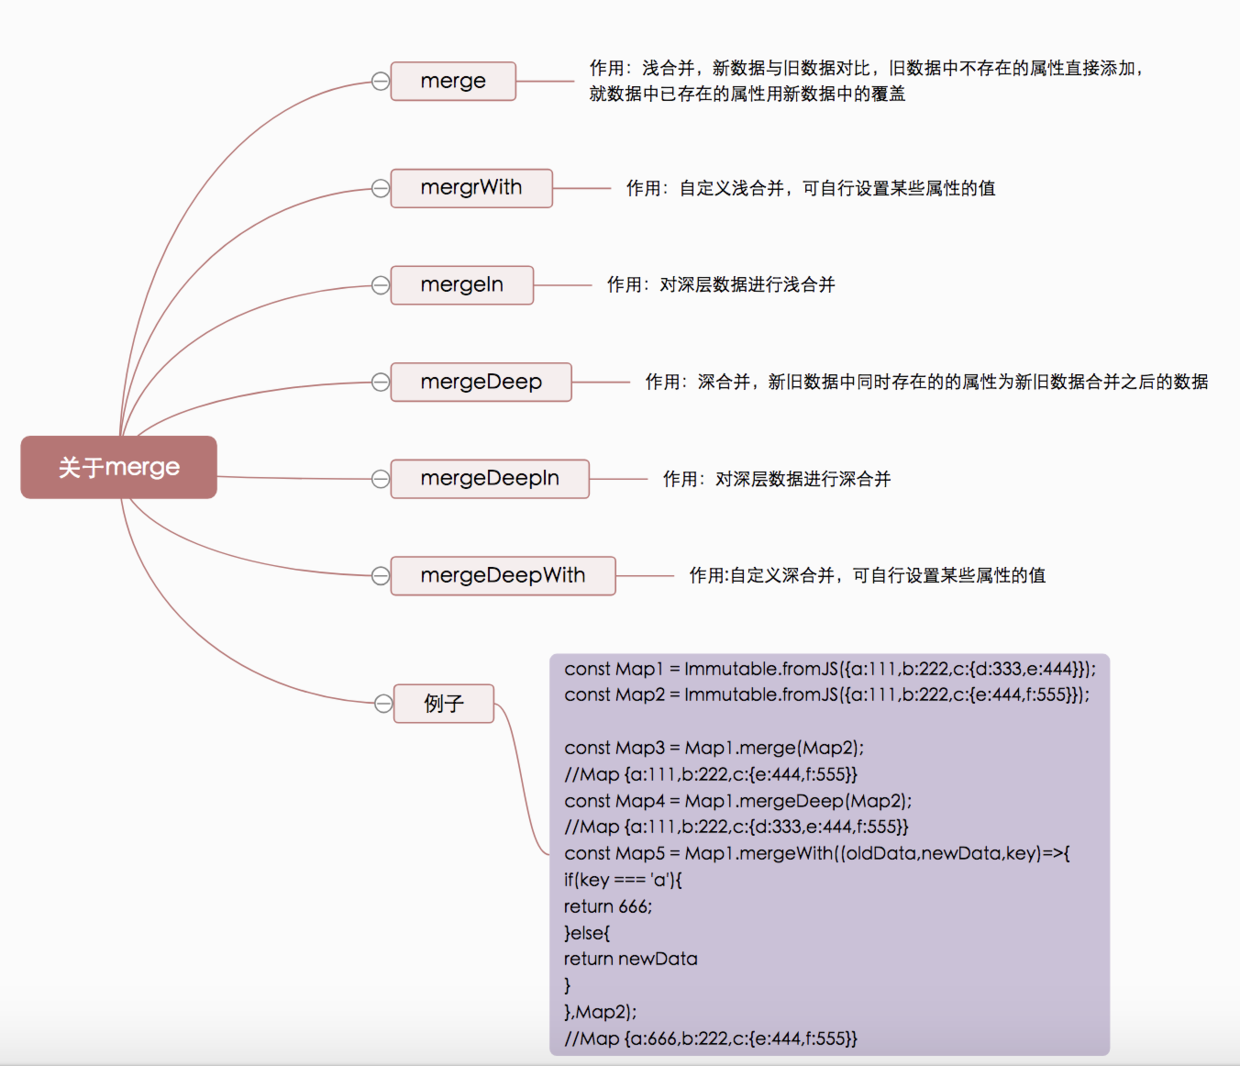
merge 这一族有六个方法,看着多,规则其实只有两个维度:深还是浅、在第一层还是沿路径走。


