检索优化实测:分块与修错更见效
作者用 LongMemEval 测试本地编程智能体记忆库,发现更换嵌入模型带来的差异很小,按实际存储方式分块更有效。排名改进主要来自修复匹配规则和文本丢失问题,还观察到 int8 向量随批次组成变化的现象。
AI 深度解读
RAG 检索不准,先换 embedding 模型,可能花了算力却没解决问题。作者给编码 Agent 的本地记忆库 Palace 跑了一周评测,发现更大的收益来自按对话结构切分内容,以及修复排序、文本丢失等普通 bug。五种模型之间的召回差异,只有 1 到 4 道题。
这份记录值得读的地方,是它把「分数变高」拆成了可检查的原因:评测有没有走生产代码、一个提升究竟多找回几题、量化是否改变向量。对正在做知识库或 Agent 记忆的团队,这比一张模型榜单更有用。
先确认你测的是检索,还是回答
Palace 是一个 Rust 单文件程序,使用 SQLite、BM25 和小型 ONNX embedding 模型。写入与召回路径都没有 LLM,也没有入库信息抽取、查询改写或答案生成。
作者使用 LongMemEval 的 s_cleaned 划分:每道题对应约 50 个会话、约 115k tokens 的聊天历史。排除 30 道拒答题后,实际计分 470 道。
指标是会话粒度的 recall_any@K:前 K 个结果里,是否出现包含答案的正确会话。它不检查模型最终能否答对,因此不能直接和端到端 QA 准确率比较。找到证据只是回答问题的前提,阅读模型仍可能理解错误。
实验环境统一为 Windows、16 线程、纯 CPU;默认模型是 MiniLM-L6-v2,384 维,输入上限 512 tokens。检索融合 BM25 与余弦相似度,再叠加产品已有的排序加分。
在这份评测里,一道题约等于 0.0021,所谓提升 0.4 个百分点,也就多找回两道题。
这也是作者先查旧成绩的原因。README 在 5 月写着 R@5 为 0.981,10 月同配置复跑却只有 0.977。检索没有采样,反复运行结果一致,不能归因于随机波动。
问题出在意图识别:查询里的 latest 包含 test,被误判成运行测试的问题,错误结果因此进入前五。改成只在单词开头匹配意图词后,R@5 回升到 0.979,独立的编码 Agent 评测没有变化。
旧分数失效,先查代码,不要急着怪模型。
切块的价值,是让证据有自己的向量
作者用同一套整会话配置比较五种 embedding 模型,召回差异都只有 1 到 4 道题。BGE 的 R@1 略好,主要来自单会话用户问题,但多会话问题的 R@5、R@10 更差。12 层模型每次 embedding 的成本约为 6 层的两倍,没有换来作者愿意认定的稳定收益。
真正明显的变化来自切块。标准评测把一个会话当成一份文档,Palace 产品却按「一轮用户输入加对应回复」存储。原来的测试没有覆盖用户实际使用的路径。
作者为评测器增加 --chunking 参数:
session把整个会话存成一条记录。text使用项目文件的通用段落切分器。exchange复用palace mine-convos的实际规范化与对话切分流程。
切块后,一个会话按其得分最高的块参与排名。
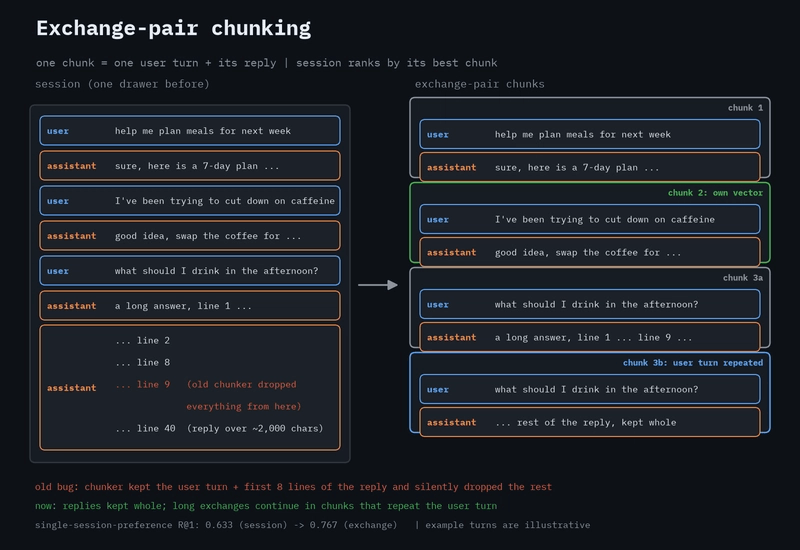
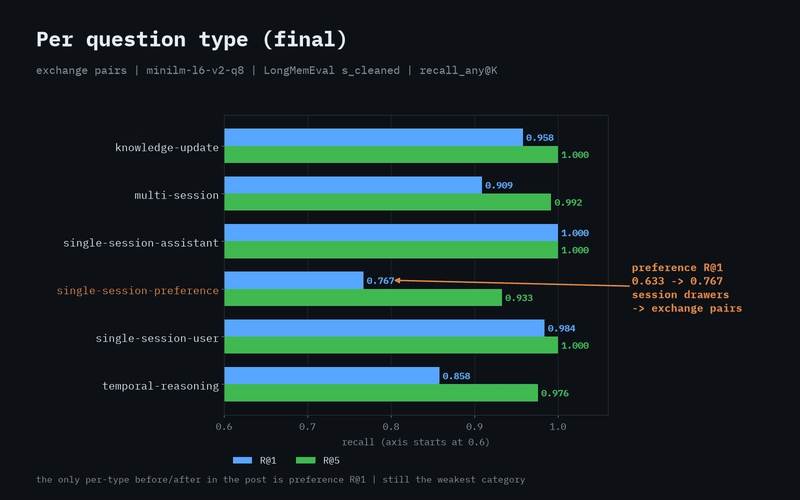
exchange 的收益在偏好问题上尤其明显:single-session-preference 的 R@1 从 0.633 升到 0.767。「我最近想少喝咖啡」可能只占长会话的一句话。整段一起生成向量时,其他话题会盖过它;独立成轮后,这句话才有机会直接匹配相关问题。
text 产生的记录数是 exchange 的两倍,效果反而更差。不是块越小越好,而是边界是否保住了完整意思。
接入生产切分器还发现一个更严重的问题:它只保留用户输入和回复前 8 行,后面的内容被静默丢弃。修复后,回复完整保留;一轮超过约 2,000 字符时,续块重复用户输入,让答案片段带着问题上下文。少于 3 轮用户输入的短会话,则回退到段落切分。
先确认内容没有丢,再讨论向量能不能理解内容。
量化和排序,都需要检查具体行为
int8 MiniLM 最初以相同召回、约 1.4 倍入库速度引起作者兴趣。但速度测试很快暴露了批处理问题:单条处理有 94 条/秒,batch 16、32、64 却分别降到 69、53、42 条/秒。
原因是 padding。一个批次按最长文本补齐,短文本也要承担长文本的计算量。按长度排序并把批次限制为 8 后,旧批处理路径从 29 条/秒提高到约 110 条/秒。这些是不同处理路径的实测,不能拼成一条统一加速曲线。
随后,一项一致性测试又失败了:同一文本单独编码与放进批次编码,fp32 最差余弦相似度是 0.999999,int8 却只有 0.976。作者将原因定位到动态量化 ONNX 模型按整个输入张量计算激活缩放尺度,批次里的其他文本会影响结果。
最终方案是 int8 每次只编码一条文本。真实 Palace 数据上,q8 仍达到 150 条/秒,fp32 为 132 条/秒;较长合成文本约有 1.7 倍速度优势。这个发现适用于作者测试的动态量化配置,不能扩展成所有 int8 模型的共同结论。
排序调整同样有得有失:
作者收窄了 should I 触发项目约定意图的规则,修复偏好题误判,独立编码评测的 R@1 也有提升。时间排序则按 question_date 解析相对日期,记录使用会话日期,窗口内加权 0.12;「two weeks」按完整时间段处理,容易误判的「on Tuesday」模式被跳过。
但时间类 R@5 没有提高。剩余 3 道错题输在主题相关性,日期正确也救不回来。
另一项调整是同源证据加分:同一会话有多个块匹配时,参考同源另一个最佳匹配块,加权 0.1。权重在其他划分和真实 Palace 探针上选择后冻结,0.3 已经伤害效果。
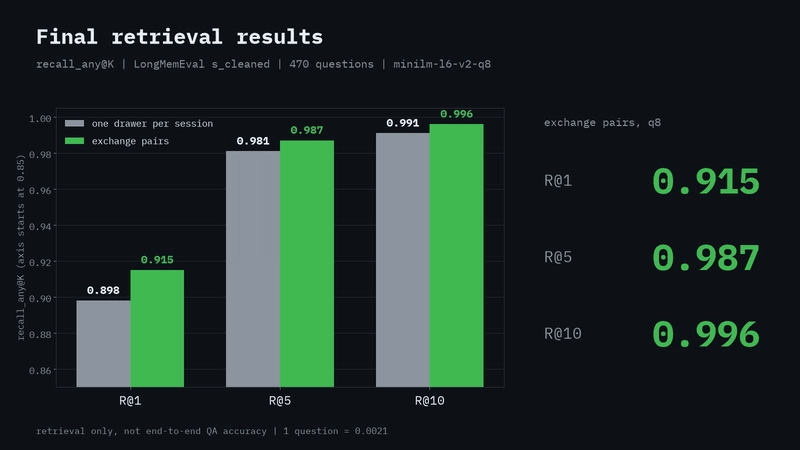
一周下来,exchange 配置的 R@1/R@5/R@10 从 0.906/0.985/0.994 变成 0.915/0.987/0.996,即 R@1 多找回 4 题、R@5 多找回 1 题。整会话配置的 R@5 则恢复到 5 月的 0.981。
我的判断
我认同作者的排查顺序:先检查数据完整性和真实代码路径,再判断模型是否不足。切块改变了证据的表达单位,修 bug 则恢复了系统应有的行为,这两件事都比盲目加大模型更值得优先验证。
但标题不能当成普遍结论。实验有明确前提:英文长对话、BM25 混合检索、小型模型,以及接近满分的 s_cleaned。中文技术文档、代码仓库是否同样受益,原文没有给对照数据;对话轮切分也不能直接替代代码或文档自己的结构边界。
排序机制还存在评测拟合风险。作者承认,独立编码 Agent 评测里保留了从题目复制的短语规则:int8 的 R@1 有规则为 0.922,无规则为 0.902。它们对 LongMemEval 和真实探针没有影响,但这仍是局部调优,披露不能消除其局限。
s_cleaned 最终 R@5 达到 0.987,剩下的题太少,很容易不小心针对错题写规则。作者正在跑更大的 m_cleaned,但没有公布结果。因此,「这里换模型没有明显收益」有实验依据;「其他系统也该这样选」仍需各自验证。
能拿来做什么
- 给 Agent 记忆做评测时,复用实际入库、规范化和切块代码,并抽查原文与存储结果是否完整对应,尤其检查长回复。
- 调整 embedding 模型前,保留逐题召回结果,同时报告多找回几题。把检索召回与最终回答正确率分开记录,避免指标混用。
- 接入动态量化 ONNX embedding 时,验证同一文本单独编码和混合批次编码是否一致,并用真实长短文本测试吞吐。
- 为排序增加规则或权重时,用独立数据选参数,冻结后再跑正式评测;将直接来自评测题目的特殊规则单独披露。