Agent低置信度兜底,不能只写进提示词
文章指出,“不确定就转人工”缺少可测量标准和实际路由,难以形成可靠兜底。文中以Gemini Decisions API的校准置信度为例,讨论将判断独立于生成模型,并据此触发回退或人工审核。
AI 深度解读
Agent 的提示词里写着「不确定就转人工」,并不代表系统真的知道什么时候该停。原文的核心主张是:把生成回复与判断能否执行拆开,用独立评分、明确规则、人工队列和日志控制行动。
作者借 Google 的 Gemini Decisions API 展开这个方案。对程序员最有价值的并非多接一个模型,而是把一句模糊的提示词变成可执行、可回溯的流程。同时,独立评分是否可靠,仍要拿自己团队的数据验证。
为什么模型说「有把握」还不能直接执行
原文用退款客服举例:商品损坏且退款低于 $50,可以自动处理;情况含糊的交给主管;超过 $200 或疑似欺诈的,必须由人判断。
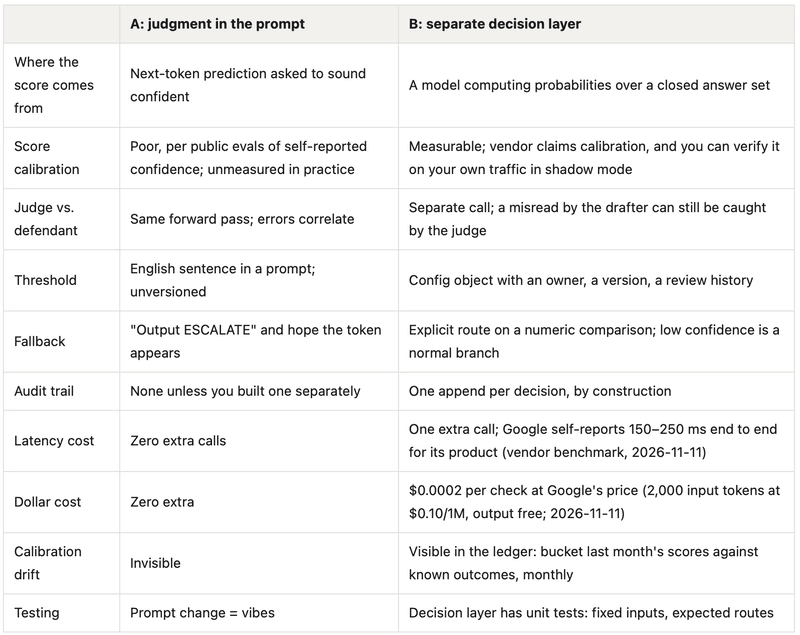
常见实现是让模型同时生成回复、判断是否符合政策,再给出 0–100 的信心分。如果回复里包含 ESCALATE,程序就转人工,否则直接发送。
问题在于,这个数字仍是模型生成的文本。模型输出 90,不代表同类判断实际有 90% 正确率。原文提到公开评测发现通用聊天模型的自报信心校准较差,但没有给出具体评测结果,不能据此量化所有模型的表现。
更麻烦的是,生成和自评可能一起犯错。模型误读了工单,自评时也可能沿用同一个误读。再加上规则散落在提示词中、发送前没有记录,事后很难回答:当时依据哪版政策,为什么放行?
「不确定就转人工」只有连接了检测条件和路由,才算系统能力。
提示词仍有用。模型主动报告疑点,可以增加待审核案例,也能给审核员提供线索。原文举例,附上「订单号不在账户历史中」这样的说明,可能让审核从五分钟缩短到三十秒;这是场景示意,并非实测结果。对于始终由人修改的内部草稿,仅用提示词也可能足够。
独立决策层到底多了哪些工程工作
按原文转述,Google 于 2026-11-11 发布的 Gemini Decisions API 面向有限答案的问题:支持带概率的是非题、2–255 个选项的选择题和量表评分;单份多模态输入最多 256K tokens,一次最多处理 1,000 个问题,并返回 0–1 的置信度。原文提到的模型名是 gemini-decision-1,相关校准表现来自供应商基准。
这些是原文所述的产品信息。它给出的 decisions_api.ask、policy_text 等字段明确属于示意伪代码,不能直接当成官方 SDK 接口。
退款案例把判断拆成三个问题:是否符合政策、是否存在退款滥用迹象、金额属于哪个区间。回复仍由生成模型起草,执行权则交给程序。
第一步是把阈值变成配置,便于审核和追溯:
THRESHOLDS = {                     # policy v7, owner: support-lead
    "auto_approve":  {"policy_ok": 0.95, "fraud_risk_max": 0.10,
                      "amount": "under_50"},
    "queue":         {"policy_ok": 0.70},   # below auto, above floor
    # below 0.70, or over_200, or fraud signals: always human
}
这里要看的是 0.95、0.10、0.70 和 under_50:它们是示例政策,不是通用安全标准。自动放行还必须确认答案确实为「符合政策」,并通过金额、欺诈等硬规则。对否定答案很有把握,也不能批准退款。
原文没有讲清答案概率、答案置信度和欺诈风险概率的具体区别,接入时必须核对各字段含义,不能统一当成「越高越可放行」。
第二步是把问题问清楚。一个问题只判断一件事,避免把「符合政策且没有欺诈」揉成单题,否则低分究竟来自哪里无法定位。政策全文作为上下文传入,例如 POLICY_V7,避免在问题里重新概括时改了含义。金额这类离散判断优先使用选择题;严重程度等已有人工分级标准的任务,再使用量表。
第三步是先记账,再发送。日志至少记录工单标识、问题、答案、置信度、threshold_version、最终路由,以及人工审核者和结论。政策正文与阈值如果分别变化,也需要各自可追溯,单靠一个版本字段未必够。
检查便宜了,验证和故障处理仍然省不了
按原文引用的 2026-11-11 报价,输入每百万 tokens 为 $0.10,输出免费。检查一张 2,000-token 工单,且不发生重试,费用是 $0.0002。
作者对比的生成成本为 $0.00086–$0.0603,计算前提是输入 4,000 tokens、输出 800 tokens、10% 重试率、70% 缓存命中率,参考的是 2026-10-19 更新的价格调查。这组数字支持「额外判断调用可能很便宜」,不能直接证明整个审核系统成本很低。延迟、人工队列和维护仍需单独计算。
原文还引用 Google 内部模型路由场景延迟最多下降 40% 的说法。那是供应商自身场景的数据,不能推导成退款流程多调用一次 API 后也会提速。
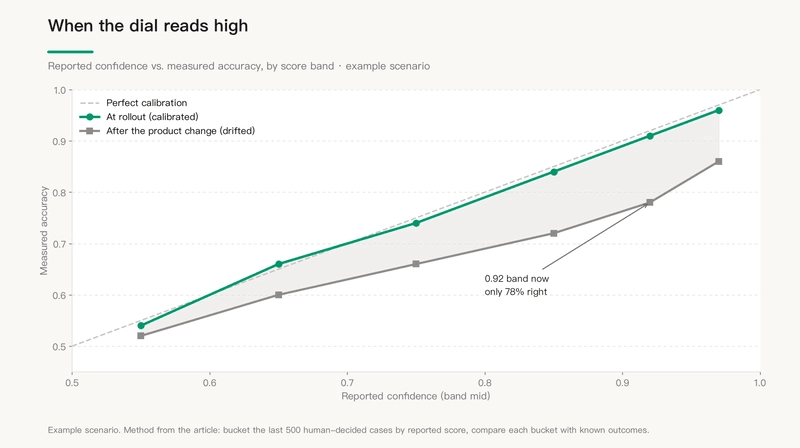
真正决定分数能否使用的是校准:找最近 500 条已有人工结论的案例,按评分分桶,对照实际结果。报 0.90 的案例如果只有 72% 正确,就不能按九成可靠来设计自动化。原文建议每月重跑,检查产品、用户或输入语言变化带来的漂移。
决策服务本身也会超时、限流或返回 5xx。下面这段示例解决的是服务不可用时如何退出自动执行:
def judged(ticket, draft):
    try:
        d = decisions_api.ask(..., timeout_ms=800)
    except (Timeout, ApiError) as e:
        ledger.append({"ticket": ticket.id, "route": "queue",
                       "reason": f"judge_unavailable:{e.code}"})
        return queue(draft, reason="judge_unavailable")
    return route(d, draft)
关键是异常分支进入 queue,并记录 judge_unavailable;timeout_ms=800 只是示例预算。队列也要设容量上限,超限后暂停非紧急动作,否则服务故障只是被转移成人工积压。
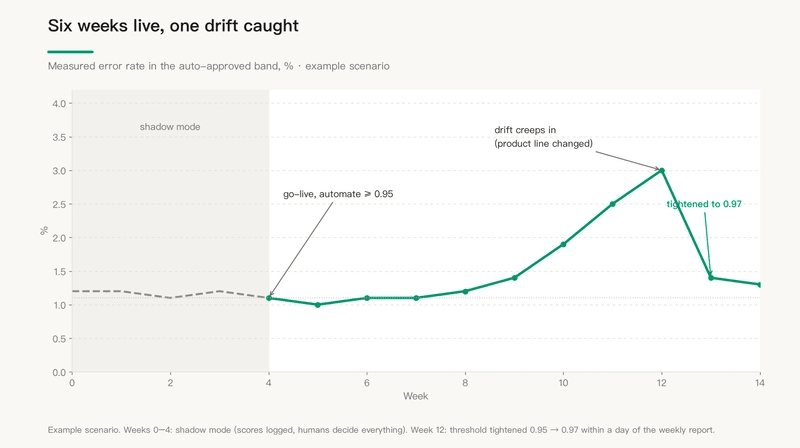
迁移可以分阶段:第零周只加日志;第一、二周影子评分,仍由人工决定;第三周开放一种低成本、可逆动作中评分最高的区间;第四周起根据已测错误率逐档放宽。事故期间只收紧审核,放宽等复盘后再做。
我的判断
我认同把行动权限从生成文本中抽出来。相较于继续堆提示词,版本化规则和执行日志更容易检查,也能回答具体事故中的责任问题。原文最后优先推荐日志,这个顺序合理。
但独立模型只提供了验证机会,不会自动带来独立可靠的判断。两个模型仍可能共享盲点。作者没有给出两种架构在同一批退款数据上的错误率、漏放率和人工工作量对照,因此可靠性提升应视为待验证的工程判断。
能确定的规则也没必要都问模型。金额已有结构化字段时,可以直接比较;人工禁行名单、权限和必须本人确认的动作,也应由明确规则处理。原文提到 United Airlines 不允许第三方 Agent 完成购票,并涉及旅客本人声明要求,但没有提供完整规则细节。这里可取的原则是:有些动作要求特定的人承担确认责任,置信度 1.0 也不能替代本人确认。
人工审核同样不是保险。原文设想一个有本职工作的人每小时收到四十条审核,最终可能机械通过;这个风险需要靠队列容量和实际改判记录观察。
买 API 会增加关键依赖。原文也提出开放权重模型配合受约束输出,或小型微调分类器的自托管路线,但没有提供对照数据证明其分数必然更差。作者自己的 KarmaBox 产品采用类似结构,这也是阅读其架构主张时应知道的商业背景。
能拿来做什么
- 给 Node 服务中的邮件发送、内容发布或工单关闭入口加执行日志,记录输入引用、规则版本和最终结果,先让每次动作都能回查。
- 对已有人工审核流程运行两周影子评分,观察分数分布和各区间的人工分歧率,再决定是否开放一个可逆动作区间。
- 将金额、权限、必须人工确认的条件写入确定性规则,再让模型判断文本中的歧义和风险,并明确区分答案值、概率与置信度。
- 为外部决策调用设置超时、转人工和队列上限,在审核界面展示原始材料与具体疑点,让审核员有条件作出独立判断。