用功能级熔断阻止 Agent 循环烧钱
文章通过重复调用和上下文持续膨胀识别 Agent 失控,建议按产品功能标记请求,先限流再阻断异常功能。提供可复用的 TypeScript 熔断代码及多款工具对比,作者同时披露了自身产品利益关系。
AI 深度解读
Agent 失控,往往先体现在请求流量里,账单只是晚到的结果。这篇文章提出的办法是:给每次 LLM 调用标记所属功能,观察短时间内的重复请求和上下文膨胀,只限制出问题的功能,让应用其他部分继续运行。
作者给出了一份 TypeScript 熔断器,也介绍了自己开发的 AtlasBurn。值得读的是检测思路和实现边界;产品能力与阈值效果则要分开看,原文没有提供误报率、漏报率或工具间的对照测试。
为什么账户预算拦不住一个失控的功能
OpenAI、Anthropic 的预算和告警适合作为最后一道防线,但作者认为,它们不能替代循环检测。
首先是范围太大。账户、项目或工作区里的某个 Agent 出问题,触发整体限制后,其他正常功能也可能受影响。其次是反馈存在延迟:一个每秒调用数次模型的循环,可能在用量面板更新之前就产生费用。最后,预算只关心花了多少钱,无法区分业务增长和程序卡死。
作者建议把控制单位缩小到 feature,例如客服入口 support-chat。每次请求带上标签,响应后记录模型、输入 token 数和时间,就能把异常归到具体功能。
预算负责限制损失,循环检测负责提前识别异常,两者需要同时存在。
这套归因也能服务成本统计:记录每个功能的 token 用量,再结合模型的 token 单价计算费用。不过,下面的简易代码只观察输入 token,尚未实现完整计费。
哪些请求形态像循环,代码又能识别到哪里
原文关注三种信号。
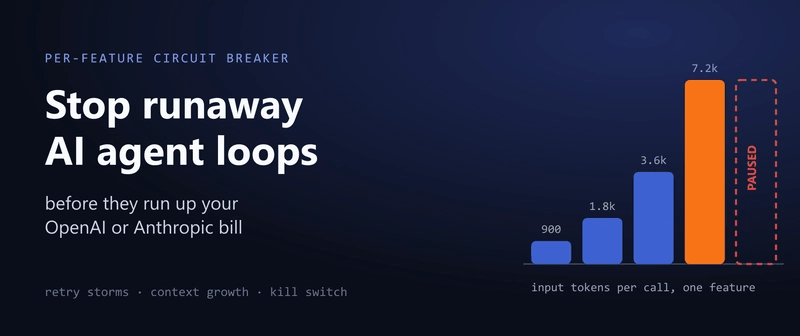
第一种是重试风暴:几秒内,相同模型反复收到输入大小相同的请求。典型诱因是工具持续失败,Agent 又不断重试。第二种是上下文失控增长:每轮把之前的输出继续塞回输入,token 数持续上升,有时成倍增长。第三种是请求速率突增,用来发现任务错误展开后同时发送大量请求的问题。
难点在于,正常聊天也会增长上下文。作者因此给增长检测加了两道门槛:最近 4 次调用发生在 30 秒内,并且最新输入达到 4,000 tokens,同时要求这 4 次输入严格递增、首尾至少翻倍。
下面这段代码实现前两种检测,命中后暂停对应功能 10 分钟:
type Call = { at: number; model: string; inputTokens: number };

const WINDOW = 4;            // 查看一个功能最近的 4 次调用
const MAX_SPAN_MS = 30_000;  // 这些调用发生在 30 秒内
const MIN_TOKENS = 4_000;    // 低于此大小时忽略上下文增长
const PAUSE_MS = 10 * 60_000;

const recent = new Map<string, Call[]>();
const pausedUntil = new Map<string, number>();

export function isPaused(feature: string): boolean {
  return (pausedUntil.get(feature) ?? 0) > Date.now();
}

export function recordCall(feature: string, call: Call): void {
  const calls = [...(recent.get(feature) ?? []), call].slice(-WINDOW);
  recent.set(feature, calls);
  if (calls.length < WINDOW) return;
  if (calls[WINDOW - 1].at - calls[0].at > MAX_SPAN_MS) return; // 未达到循环速度

  const sameModel = calls.every((c) => c.model === calls[0].model);
  const tokens = calls.map((c) => c.inputTokens);

  const identical = sameModel && tokens.every((t) => t === tokens[0]) && tokens[0] > 0;
  const growing =
    sameModel &&
    tokens.every((t, i) => i === 0 || t > tokens[i - 1]) &&
    tokens[0] > 0 &&
    tokens[WINDOW - 1] / tokens[0] >= 2 &&
    tokens[WINDOW - 1] >= MIN_TOKENS;

  if (identical || growing) pausedUntil.set(feature, Date.now() + PAUSE_MS);
}
重点看 identical:它判断的是模型和输入 token 数相同,没有比较请求内容。几个不同请求恰好一样长,也可能命中;重复请求只要长度发生变化,也可能绕过这条规则。
接入时,在发送前检查暂停状态,在响应后记录用量:
import OpenAI from "openai";
import { isPaused, recordCall } from "./loop-breaker";

const openai = new OpenAI();

export async function chat(feature: string, params: OpenAI.ChatCompletionCreateParamsNonStreaming) {
  if (isPaused(feature)) {
    // 仅对当前功能进行降级,其他功能继续运行。
    throw new Error(`AI feature "${feature}" is paused: loop detected`);
  }
  const res = await openai.chat.completions.create(params);
  recordCall(feature, { at: Date.now(), model: params.model, inputTokens: res.usage?.prompt_tokens ?? 0 });
  return res;
}

await chat("support-chat", { model: "gpt-4o-mini", messages: [{ role: "user", content: "Hi" }] });
注意 recordCall 在 await 之后:请求直接抛错就不会被记录,已经发出的并发请求也不会被撤回。作者说它足以应对单进程里「失败工具被重试 400 次」这类事故,但没有给出对应实验记录,不能当作验证结果。
从内存 Map 到生产防护,还缺哪些环节
这份实现只适合单进程。部署多个 Node 实例或 serverless 函数后,每个实例只能看到部分请求,需要 Redis 等共享状态。它也没有实现速率检测、费用预算,以及先限速再封禁的分级处理。
流式响应还有额外要求。原文指出,OpenAI 需要设置 stream_options: { include_usage: true },并读取最后一个 chunk 才能取得用量。OpenAI、Anthropic、Gemini 的各个客户端和调用路径也都得覆盖,否则绕过封装的请求不会进入检测。
作者据称参考了截至 2026 年 11 月的公开文档,给出的选型方向是:已有网关、主要需要预算或 Agent 迭代次数上限,可以看 LiteLLM、Portkey;需要追踪和评估,可以看 Langfuse。Helicone 也被提及,但原文没有充分展开其循环阻断机制。
AtlasBurn 则是作者自己的产品。按原文描述,它跨实例按功能执行上述检测,并补充持续每秒 10 次以上请求的突发检测,以及每日、每小时预算。
它对循环先限速,把调用间隔拉到 2 秒;60 秒后仍持续,或费用达到每日预算的 2%(最低 $0.25),再阻断。预算超限则直接阻断,提供 Alert、Throttle、Kill Switch 模式。
Node.js / TypeScript 的安装与初始化命令是 npm install @atlasburn/sdk、npx abn init。接入使用 initAtlasBurnAuto({ apiKey: process.env.ATLASBURN_KEY }),请求通过 atlasburnFeature("support-chat") 生成标签头;作者称标签会在发送给模型供应商前移除。
阻断返回符合供应商接口形式的 429,并带上 x-atlasburn-blocked: 1 和 x-should-retry: false。原文称行为规范的 SDK 会据此停止重试,实际接入仍要核对客户端行为。
Python 等语言通过 base_url 指向代理,以 AtlasBurn-API-Key 认证、x-atlasburn-feature 标记功能。作者还宣称只读取模型、token、时间和功能标签,不读取提示词及输出;SDK 使用 Apache-2.0 许可证,免费计划每月覆盖 10M tokens,包含防护和 Kill Switch。这些属于产品描述,原文没有独立验证材料。
我的判断
按功能归因和熔断,是这篇最值得借走的设计。它让一个异常任务的影响范围更小,也让费用能对应到具体业务入口。
但「同一个功能」不等于「同一次 Agent 执行」。多人同时使用 support-chat 时,不同会话的调用会混进同一个窗口。固定长度输入的正常批处理,也容易触发重复检测。原文没有解释如何区分这些情况,更没有给出阈值的对照数据,因此 4 次、30 秒、4,000 tokens 都应视为经验起点。
这份代码能识别可疑流量形态,不能证明 Agent 已经陷入循环。
框架里的 max_turns 能直接限制一次任务最多走多少轮;请求路径上的熔断器则观察实际调用,适合补充防护。两层一起使用,比单独依赖其中一层更完整。
AtlasBurn 还有一个明确取舍:服务不可达时采用 fail open,请求照常放行。这有助于业务继续运行,但该时刻无法依靠它阻止费用增长,供应商预算仍有保留价值。
能拿来做什么
- 在 Node 服务的统一模型调用入口加入 feature 标签,先覆盖客服、摘要等已有 AI 功能,并检查是否存在绕过入口的调用。
- 为 Agent 设置
max_turns,同时记录最近请求的模型、token 数和时间;先观察真实流量,再决定是否启用自动暂停。 - 多实例部署时,把检测状态迁到 Redis 等共享存储,并明确按功能还是按单次任务统计,避免混合正常并发请求。
- 接入流式调用或代理后,验证最终用量能否取得、
429是否会继续重试,以及功能被暂停时页面如何向用户解释和恢复。