用分时基线改善蜂窝网络掉话告警
统一的掉话率阈值容易在繁忙小区的高峰期误报,也可能漏掉低流量时段的真实故障。作者用蜂窝网络运维案例说明,按小区和时段学习正常波动范围,可以识别偏离日常规律的指标。
AI 深度解读
凌晨 3 点,小区开始掉话,告警没响。上午 9 点,工作日的例行高峰触发告警,工程师排查后却没发现故障。作者用这两个场景解释了同一条规则为什么会同时漏报和误报。掉话率有没有异常,得看这个小区在相近时段通常是什么水平。
按小区和时段学习基线,能让告警更贴近实际。难点在于,网络会扩容、换设备、调参数,基线也得跟着变。更新太随意,持续故障又会被模型学成「正常」。这篇最值得带走的是基线该在什么条件下更新,以及告警响了以后该先查什么。
同样的掉话率,为什么有时该报警?
作者在现网做过 2G/3G/4G/5G 射频和网络规划。下面这条规则代表他讨论的固定阈值做法,能用统一口径给数千个小区配置告警。
if drop_rate > 2%:
    raise_alarm()
第一行把判断压在 drop_rate > 2% 上,小区位置和时段都没有参与比较。高速公路旁、繁忙市场和安静村庄的小区,平时的指标波动就不同。阈值设低,忙碌小区可能频繁误报。设高,安静小区持续劣化几周也可能没动静。同一个小区,周一上午 9 点和周日凌晨 2 点也得分开看。
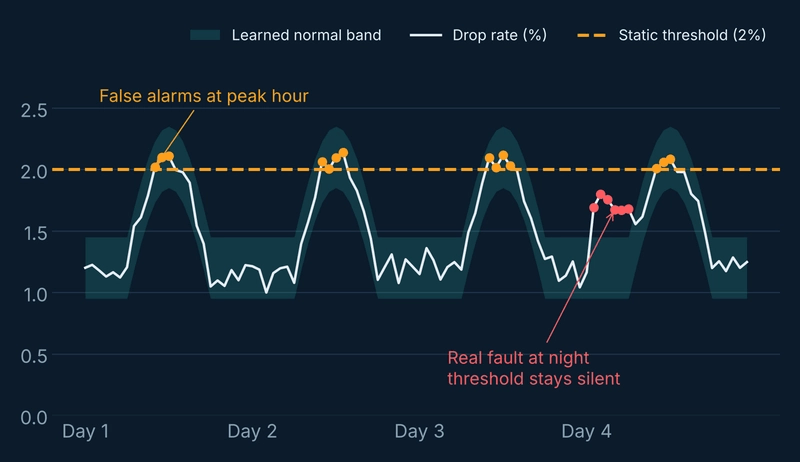
作者的做法是按小区、小时和星期几学习正常范围。这样,即使凌晨的掉话率还没到 2%,只要明显偏离这个小区同类时段的正常水平,也有机会触发告警。作者报告,在他的工作中,基于机器学习的做法比此前使用的固定阈值将检测准确率提高了约 18%。原文没有交代准确率的计算口径,也没说明这个数字是相对提升还是百分点差。
基线什么时候该跟着网络变?
作者参与过一次涉及 500 多个站点的设备厂商切换。两家厂商对计数器的定义不同,切换后 KPI 基线一夜之间发生偏移。指标跳变可以由统计口径解释,但固定阈值依然大面积触发,真正的故障就混进了告警堆里。
新站上线、参数调整、流量增长和软件升级,都会让上个月学到的正常范围逐渐失效。作者把这类变化称为概念漂移(concept drift)。直接拿最近的数据重训也有代价。一个小区如果持续劣化两周,这两周的数据就可能被模型吸收,最后告警自己消失了,用户仍在掉话。
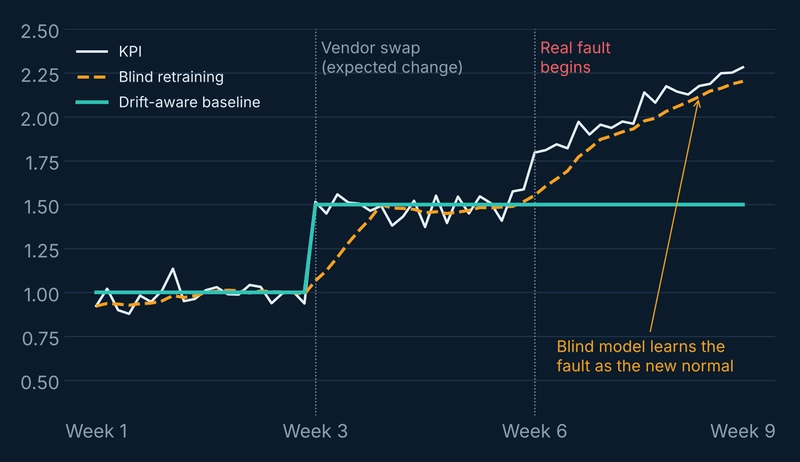
作者在硕士研究中提出,把厂商切换、新站上线和参数调整等计划内事件提供给检测器。只有当偏移持续存在、原因可以解释,而且没有伴随用户体验变差时,才更新基线。这里的实际难题是确认用户有没有受影响,原文没有给出判断口径。
告警响了,工程师应该先查哪个指标?
一条「小区 4521 异常」只告诉值班工程师去哪里看,他还要从几十个计数器里找线索。作者研究的另一部分是根因排序(root-cause ranking),也就是按解释本次异常的可能性给 KPI 排序,让工程师先查排在前面的指标。
排序给的是排查顺序。具体根因仍需结合变更记录和其他指标确认。作者认为这能为每次事故节省数小时,但原文没有给出计时记录或对照数据。
我的判断
我认同作者把「什么时候更新基线」单独拎出来。图里两张曲线都是示意,文章提供的量化结果也只有约 18% 的准确率提升。它能说明作者在自己的工作里看到了改进,但还看不出误报和漏报分别少了多少,也看不出改进有多少来自按时段比较。根因排序能省多少时间,目前也是经验判断。
如果手头已经有按对象和时段分组的历史数据,可以先用统计区间做对照。它和机器学习基线都能回答「同类时段通常是什么水平」,统计区间更便于值班同事检查异常边界。碰到厂商切换这种指标定义都变了的情况,两种做法都得依赖可靠的变更记录。再复杂的模型也无法仅凭一条 KPI 曲线确认统计口径有没有变。
能拿来做什么
- 回放前端错误率或 Node 接口失败率的历史告警。按服务、小时和星期几建立对照,用已知事故分别统计固定阈值和分时段基线的误报与漏报。
- 给监控指标接入发布、配置调整和统计口径变更记录。发现持续偏移时,先用请求成功率等用户侧指标判断影响,再决定是否把这段数据纳入基线。
- 改造告警消息,把最可能解释异常的几个指标和它们偏离基线的幅度一起展示,让值班同事打开告警就知道先查哪里。