MCP 工具定义的上下文成本实测
作者统计了 11 个 MCP 服务器的 146 个工具,定义合计约 2.44 万 Token,并比较不同服务器的开销。文章据此估算请求成本及缓存影响;每次实际注入多少定义仍需结合客户端行为核验。
AI 深度解读
接上 MCP 服务,模型还没开始干活,工具说明可能已经占掉大半输入。作者在本机启动 11 个服务,统计出 146 个工具、24,395 tokens;其中 10 个服务的定义就有 23,895 tokens。
这篇文章真正提醒的是:工具菜单也有成本,而且 agent 每调用一次模型,都可能再带一遍。缓存能显著降低账单,按需加载能缩短上下文,但两者解决的问题不同。对经常给 AI 编程助手加工具的开发者,这笔账值得先算清楚。
工具没被调用,为什么也要付钱
MCP 服务通过 tools/list 返回工具名称、描述,以及定义参数的 JSON Schema。客户端把这些内容交给模型,模型才能判断该选哪个工具、传什么参数。
工具说明因此属于输入的一部分。按原文引用的 Anthropic 计费规则,tools 参数也计入输入 tokens,不需要等工具真正执行才收费。
作者用一个无依赖的 Node 客户端,通过 stdio 启动服务并保存原始回复,再用 tiktoken 的 o200k_base 分词器计数。测量日期是 2026 年 11 月 14 日,样本包括 filesystem、memory、everything、sequential-thinking、fetch、git、time,以及 github、Playwright、Context7 和 Chrome DevTools。
这里的「每次」指模型调用,不是用户会话。一个 agent 为完成任务循环调用模型六次,工具定义就可能随请求发送六次。
工具调用少,不代表工具定义的输入成本低。
不过,这个结论有客户端实现前提:完整工具列表被放进每次模型请求。文章后面讨论的按需加载,正是在改变模型实际看到的工具范围。
该数工具定义,不能只数服务器
作者测量前猜测,10 个服务需要 25,000 到 40,000 tokens,结果比预期低。但服务之间的差异,比这个预测误差更有参考价值。
chrome-devtools 单个服务占 6,751 tokens,fetch 只有 296。多数工具平均占 100 到 200 tokens,但 Context7 的 resolve-library-id 单独就有 608 tokens,而整个服务只有两个工具。
沿作者选定的顺序累加,1、3、5、10 个服务分别占 2,925、5,150、10,417、23,895 tokens。换个组合,结果会变:所有五服务组合的均值是 11,089,最小 3,782,最大 18,892。两个浏览器服务合计就有 10,685 tokens。
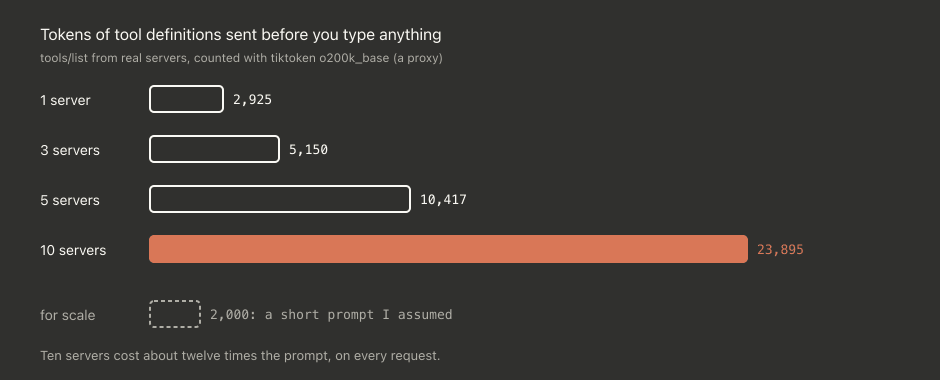
这也是为什么「上下文窗口够大」不能直接回答成本问题。23,895 放进 200,000 tokens 的窗口不算多,但相对于一次短问题,比例很高。
作者假设业务提示词为 2,000 tokens,三个服务的工具定义就占总输入约 72%,五个约 84%,十个约 92%。这个 2,000 是演示用假设,没有来自真实工作负载的统计。长代码审查和短问答,显然会得到不同的占比。
缓存和按需加载,各自省掉什么
作者按 2026 年 11 月 14 日抄录的价格估算:Claude Sonnet 5.5 每百万输入 tokens 为 2 美元,缓存命中为 0.10 美元;gpt-5.5 则分别为 5.00 和 0.50 美元。这里应把它们理解为文章的计算依据,不能直接当成当前报价。
按每天 20,000 次模型调用、每月 30 天计算,10 个服务仅工具定义的 Sonnet 5.5 未缓存费用就是 28,674 美元。若每次全部命中缓存,则降到 1,433.70 美元。
三个服务、5,150 tokens,在每天 1,000、20,000、500,000 次调用下,月度未缓存费用分别是 309、6,180、154,500 美元。作者提到完整表还包含 Opus 5.5 和 gpt-6.1-sol,但给出的正文没有对应明细。
缓存确实能解决很大一部分价格问题。工具定义通常位于请求前缀,Anthropic 的缓存顺序是 tools、system、messages;稳定的工具列表适合复用。原文称 OpenAI 从 1,024 tokens 起自动缓存,前缀也包含工具定义。
但「全部命中缓存」只是费用下界,没有计入写入费用。Anthropic 默认缓存有效期为 5 分钟,修改工具定义会让缓存失效,按用户返回不同列表也会影响复用。
缓存降低计费价格,按需加载减少进入模型上下文的工具定义。
后者通过 defer_loading: true 标记延迟加载工具,再由工具搜索找到需要的定义。原文转述 Anthropic 的案例:五服务配置从约 77,000 tokens 降到约 8,700,Opus 4 的准确率从 49% 升至 74%;官方将其概括为减少 85%。
作者把 85% 套到自己的 23,895 上,得到约 3,600 tokens。这只是推算,没有实际运行验证。另一个容易混淆的细节是:按原文引用的文档,延迟加载仍要求每次在 tools 数组发送全部定义,它控制的是进入模型上下文的内容,不等于网络请求体同步缩小。
我的判断
我赞同先量工具定义,再决定是否接入。对 AI 编程助手,服务数量只是粗略指标,工具说明长度和实际使用频率更能指导取舍。
但标题里的「24,000 tokens」不能直接套给所有 MCP 客户端。作者测了定义体积,没有请求真实模型,也没有测延迟、任务成功率或工具误选率。关于超过 30 到 50 个工具后选择准确率下降,以及长上下文中间信息利用较差的说法,都不是这次实验得出的。
计数也有边界:o200k_base 是 OpenAI 的分词器,不能精确代表 Claude 用量。样本只有作者挑选的 11 个免凭证服务,github 还是旧版参考服务。它适合看量级和排序,预算应以供应商返回的 usage 为准。
和直接关闭工具相比,稳定缓存保留了使用便利;和完整加载相比,工具搜索有机会减少上下文负担。但这篇没有同一真实工作负载下的对照数据,无法替一般团队选出统一答案。
作者提出「工具定义超过典型提示词约四分之一、又很少使用,就默认关闭或延迟加载」,也是经验规则。作者自己给出的反证条件是:真实工作负载缓存命中率超过 90%,并且 100 多个工具没有准确率损失。这样的验证比单看账单估算更有说服力。
能拿来做什么
- 给日常 AI 编程环境盘点一次
tools/list,分别统计工具数量和定义 tokens,优先检查浏览器类服务及描述特别长的工具。 - 在 Node agent 的用量记录中按模型调用计数,把一次任务中的循环次数算进去,再用供应商的
usage核对本地估值。 - 对只在少数任务使用的服务,采用任务开始时启用或客户端支持的延迟加载,并确认客户端确实支持
defer_loading: true对应的工具搜索流程。 - 已有稳定缓存的团队,先核对命中率和真实费用,再比较完整加载与按需加载的任务成功率;不要仅凭工具数量重构配置。