知识库建好了,Agent 为何仍不检索
文章指出,自动整理和更新知识库并不能保证 Agent 会使用已有答案,关键在于新会话是否优先触发检索。它从默认回答路径和配置问题切入,分析知识入库与实际调用之间的断层。
AI 深度解读
Wiki 已经让 AI 写好了,提问时它却不去查,非得提醒一句「你已经存过答案」。原文把这个问题归到检索流程:资料入库做得再自动,也不代表 Agent 会在回答前主动使用它。
作者给出的办法很具体:把查 Wiki 放到事实性问题的第一步,回答必须说明用了哪一页,再用已知答案的问题检查执行情况。这套做法值得借鉴,但文章没有给出改造前后的实测数据,末尾推荐的 AFFiNE 也与作者存在工作关系,需要分开看待。
为什么写进 Wiki,回答时还是用不上
原文从 11 月 11 日一位开发者的抱怨切入:Claude 已经拥有能自行编写、更新的「第二大脑」,用户却仍要提醒它去查。提醒之后,模型才找到已有资料。
这里至少有两个不同环节:入库负责保存、整理知识,检索负责在问题出现时找到知识。很多方案把精力花在前者:原始材料进入 _raw/,模型整理页面、补充链接、维护知识关系。后者却没有同样明确的入口。
于是,新会话开始时,模型可能直接依据当前提示、训练知识作答,或者重新搜索网页。上周二已经整理好的页面,反而没有被打开。
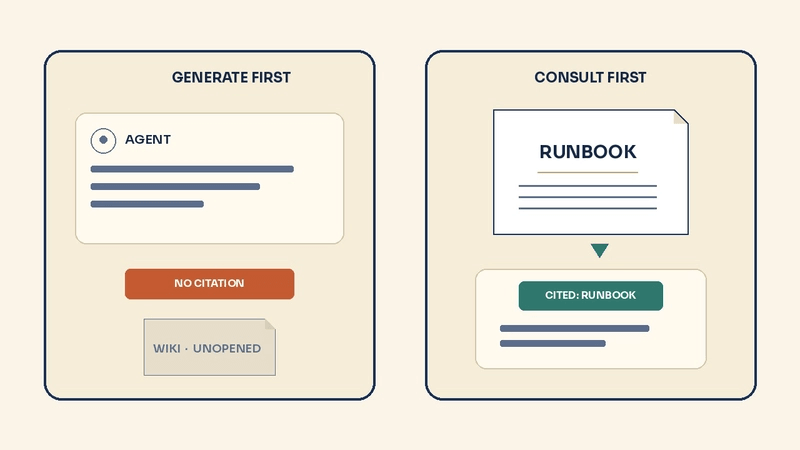
作者归纳了三个配置问题。
首先,规则太长。「先查 Wiki」埋在 CLAUDE.md 第四页,前面还有 20 条风格要求,很容易失去优先级。其次,入库有专门的斜杠命令,查阅却完全自愿,工具流程没有要求模型先搜索。最后,回答不用指出页面,系统也就难以发现它有没有使用知识库。
知识已经保存,与回答已经使用这些知识,是两件事。
不过,这个案例只能说明已有页面没有被主动访问,还不足以排除索引、权限、文档命名等其他问题。
怎样把「记得查」变成回答前的步骤
作者建议在 AGENTS.md、CLAUDE.md 或同类文件顶部放一组简短规则:
- 回答事实性问题前,先搜索 Wiki。
- 写明使用的页面,找不到就明确说明缺失。
- 页面缺失时,不要凭记忆编出一个看似有帮助的答案。
- 只有经过批准的入库任务,才能创建新页面。
- 两页内容冲突时,优先核对来源文档,并标出冲突。
这组规则的关键是划清知识边界:系统要回答的是「知识库里有依据的内容」,就应当把查不到也视为一种正常结果。
但作者没有停在规则文本上,还要求在工具调用流程里落实:事实性问题的第一次工具调用必须搜索 Wiki;回答模板从页面标题或「Wiki 中没有」开始。每周再抽查 10 个已知存在答案的问题,统计多少次无需提醒就引用了页面。
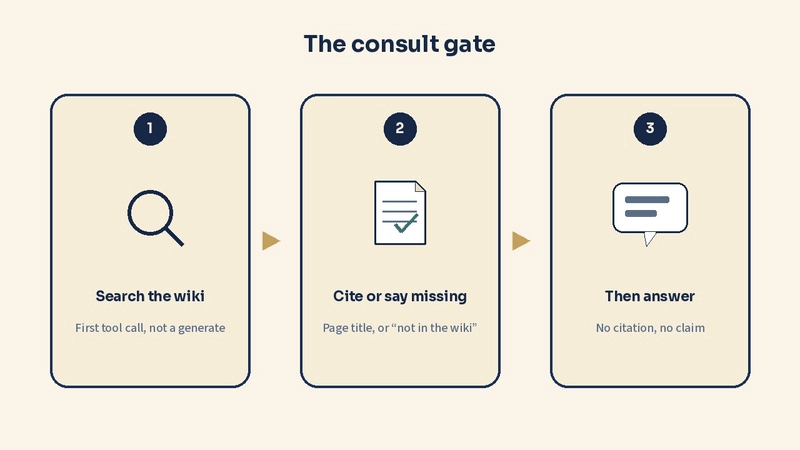
这里要分清两层约束。把要求写进文件,是给模型的指令;让程序控制第一次工具调用,才是流程约束。原文提出了后者,却没有提供对应的 API、拦截代码或客户端配置,不能据此认为加几行 Markdown 就完成了强制执行。
30 分钟检查,先验证 Agent 会不会查
作者提出的验证方法不复杂:挑 5 个答案已经存在于 Wiki 的问题,新开会话,不提醒查资料,直接提问。把回答分成三类:引用正确页面、引用错误页面、没有引用而直接作答。
只要不足 5 个回答引用正确页面,就缩短规则,并把查阅要求移到最前面。随后,在 Claude Code、Codex,以及其他连接同一 Wiki 的客户端里重复这 5 个问题。
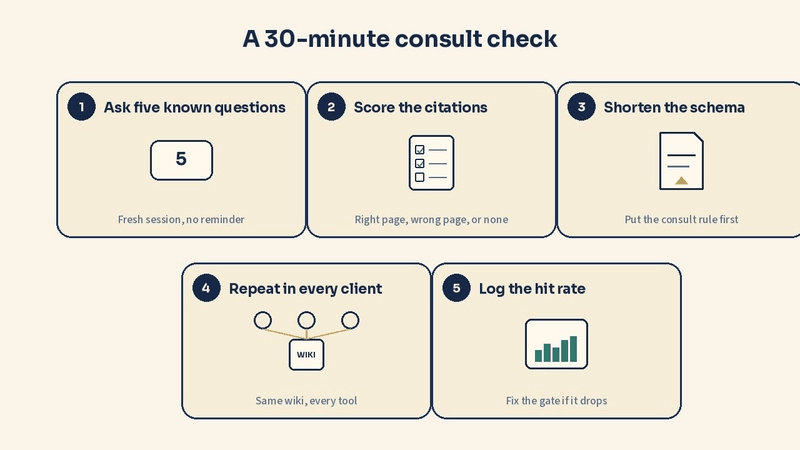
记录只需一行:日期、客户端、5 个问题里有几个无需提醒就引用了页面。这个办法能快速暴露配置回退,也能发现某条规则只在一个客户端生效。
但它首先测的是「有没有找到并引用目标页面」。引用正确,不保证答案忠实于页面;同一组 5 个问题,也不足以代表整个知识库。作者没有公布自己的得分、错误样例或改造后的提升幅度,因此这是一份检查方案,还不是效果报告。
多个客户端共用知识库,需要独立的工作区
原文后半段把问题从个人 Wiki 推向团队:知识工作区、模型服务和聊天界面应当分开。客户端通过 MCP 连接同一个可搜索空间,模型可以更换,已有知识和查阅入口继续保留。
大白话讲,就是别让团队资料只存在于某个聊天产品的专属记忆里。
作者以自己参与开发的 AFFiNE 为例,列出它的开源、本地优先文档、白板和数据库,以及可选的 BYOK AI、默认只读的工作区 MCP server。这里的 BYOK 指使用自己的密钥接入 AI。
作者也承认两个不适合的场景:只需要静态手册,以及需要 Agent 在文中所指的当前稳定版里直接写入工作区。原文没有给出稳定版版本号,不能进一步推断具体版本的写入能力。
它提出的架构方向有价值,但「统一工作区」解决的是访问入口,是否能准确检索,还得靠真实问题验证。
我的判断
我认同把检索设为明确步骤。对于团队内部约定、部署流程、项目历史,模型训练知识无法替代本地依据。要求引用页面,也能让使用者更容易复核。
需要保留的是它的适用范围。「查不到就不回答」适合严格依赖内部资料的助手;日常编程助手还会处理通用语言问题,把所有事实性问题都绑到 Wiki 上,可能增加无效查询。团队应先定义哪些问题必须查内部资料。
相比继续堆长提示词,流程约束和抽样检查更容易验证;相比每次人工提醒,统一入口更便于团队使用。但作者没有提供这些方案的对照数据,关于效果的判断仍是经验之谈。
另外,「指标下降就修入口,不修模型」说得过满。失败也可能来自文档缺失、检索结果不相关或模型误读。应先看失败发生在哪一步,再决定修改规则、文档还是检索流程。
能拿来做什么
- 给前端或 Node 项目的内部助手明确查阅范围,例如项目约定、发布步骤和已有方案决策,并要求回答附上具体页面名称。
- 从现有知识库挑出 5 个确定有答案的问题,在 Claude Code、Codex 中分别新开会话检查,记录正确引用、错误引用和无引用的情况。
- 把查阅规则放到
AGENTS.md或CLAUDE.md顶部,再核实工具流程是否真的先搜索;页面引用出现后,还要检查答案是否符合页面内容。 - 团队共用 Wiki 时,分别检查搜索权限与写入能力。选型前确认是否需要自动入库,避免把默认只读的 MCP 连接当成完整读写流程。