评测集如何更新而不丢失可比性
文章提出通过明确负责人、不可变版本快照、变更日志及候选样本池管理评测集,避免随意改动导致分数失去可比性。还涵盖数据泄漏检查、代表性采样和基准刷新规则。
AI 深度解读
模型分数涨了,产品体验却没变,问题可能出在评测集:题目被悄悄换过,标签修过,最近一次事故又被塞进了十道相似题。分数还在更新,衡量能力的尺子已经变了。
作者的主张很明确:评测集需要持续维护,而且要像产品和代码一样管理。文章没有提供实验结果,给出的是一套工程流程,试图同时保住两件事:历史分数可比较,新出现的问题也能被测出来。对于正在比较模型、调整提示词或维护 AI 功能的团队,这个矛盾值得先理清。
分数能不能比较,先看评测集有没有版本
评测集不是一份随手修改的题库。它决定了团队用什么证据判断模型进步、功能能否上线,以及某次修改是否引入退化。
作者建议指定负责人或小型评审组,明确评测用途、数据来源与许可、标注规范和已知局限。安全评测不能因为新增样本方便,就逐渐变成通用推理测试。每道题为什么存在,也应该留下记录,否则收集得越多,越难解释这套题究竟测什么。
变更流程是:提出修改、评审签字、编写发布说明,再正式发布。修改样本、标签和评分规则,都要走这个流程。
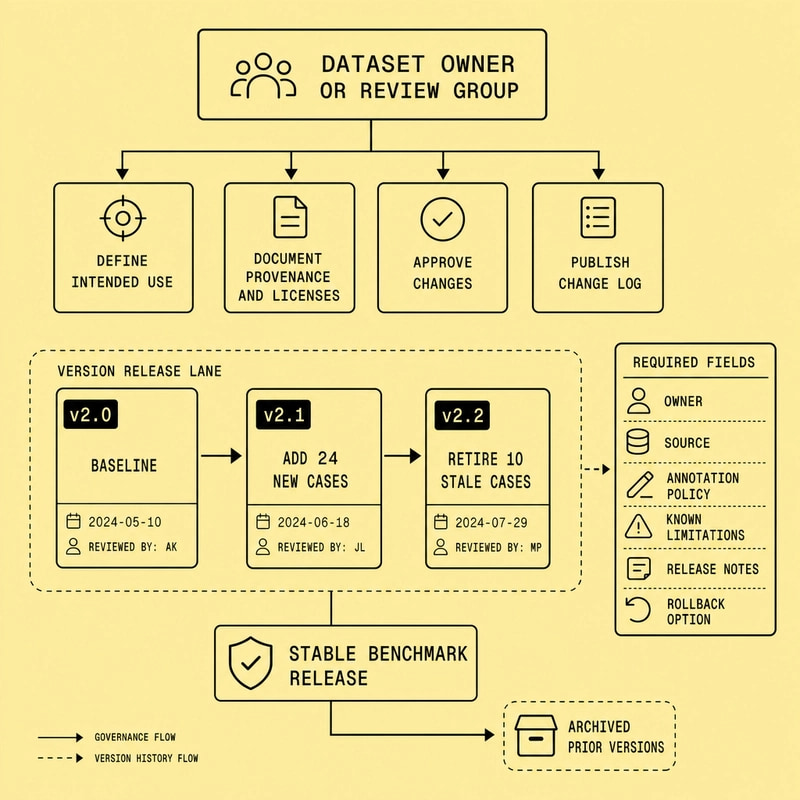
版本号必须对应不可修改的完整快照。比如 SafetyEval v2.3,不能只保存题目,还应包含提示词、标签、元数据、评分脚本和执行说明。报告引用具体版本,才能知道不同模型是否答了同一套题、接受了同一套评分。
原文提出三类版本变更:
- patch 用于不影响评分的错别字和元数据修正。
- minor 用于新增样本或有限的标签修正。
- major 用于破坏可比性的变更。
这里不能机械套用语义化版本。修正一个明显错标,和重写一道题的提示词,影响不同;后者可能改变难度,需要在变更日志里标明趋势中断。
评测集变了,分数变化就不能直接归因于模型。
因此,变更日志最该回答的问题是:改了什么、为什么改、影响哪些样本,以及前后分数还能不能比较。
新故障先进入候选池,正式题库按节奏更新
生产事故、红队测试、用户投诉和错误聚类,都能提供新样本。错误聚类就是把大量失败输出按相似问题归类,找出反复出现的故障模式。
但作者反对把最新事故直接放进正式评测集。刚发生的问题最容易吸引注意力,也最容易挤占其他问题的权重。
他们建议维护独立候选池,记录来源、日期、失败类别和评审意见,再做去重、验证与标签审核。同一失败模式如果只是换了措辞,却重复出现十次,最终分数就会过度反映这一类问题。
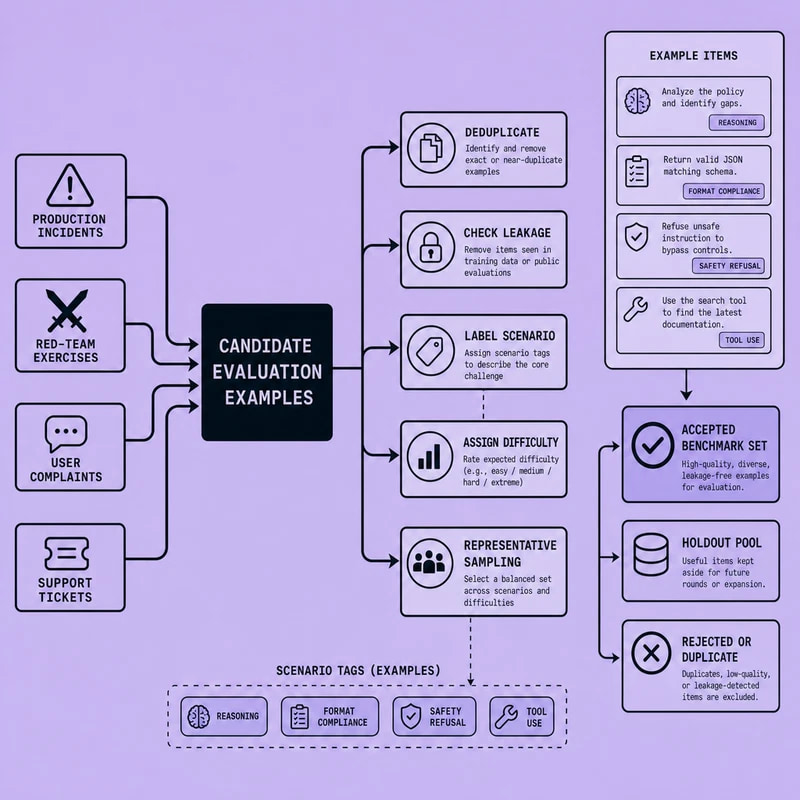
审核时需要判断:这是新故障还是旧题改写?任务是否真实?预期结果能否稳定评分?加入后增加了覆盖面,还是只增加了某个类别的数量?
正式发布可以按月或按季度进行,具体取决于变更量,而不是每换一个模型就改一次题库。候选池持续接收问题,正式版本在两次发布之间保持稳定。
旧题也需要退出。废弃的产品流程、失效的政策约束、退役工具,以及不再符合用户行为的提示词,都可能让评测集看起来丰富,实际却测错了方向。作者建议归档这些题,保留退出原因,并记录删除是否影响历史趋势。
为兼顾连续性和时效性,原文提出「冻结核心集+扩展集」:核心集用于长期比较,扩展集按计划吸收新任务。必要时同时报告当前集合与沿用集合的分数,让读者看清进步发生在哪套题上。
题库管理规范,也可能测不出真实能力
版本完整,只能说明变更有迹可循,不能证明题目仍然有效。作者重点讨论了难度、泄漏和代表性三个问题。
难度需要分桶。简单题验证基础能力,中等题识别渐进改善,困难题暴露边界故障。全是简单题,模型容易接近满分,退化不容易显现;全是困难题,小幅改善又可能被噪声淹没。作者建议依据实际解题率或错误率划分难度,每次发布检查构成。一道六个月前的难题,今天可能已经很普通。
泄漏也不限于题目进入训练集。评测样本被复制到 system prompt、测试 notebook 或调试文档,都会污染测量。即使没人看过完整标签,团队反复对着同一套保留集优化,也会逐渐适应它。保留集(holdout set)就是预留出来、用来检验泛化表现的数据。
对应措施包括限制原始数据访问、记录使用者与版本,并将评测题与训练语料、提示词库、候选样本做去重和相似度检查。暴露过多的部分,需要隔离并替换。
代表性则要求题目对应真实使用情况。原文建议按任务类型、用户群体、语言、领域和风险分层抽样。生产环境包含多语言任务,题库就不能长期偏向英文;高风险流程重要,也不能让低风险题目淹没它。
当目标任务改变、泄漏可疑、头部模型分数接近上限,或旧题退出后留下明显覆盖缺口时,小修补可能已经不够。
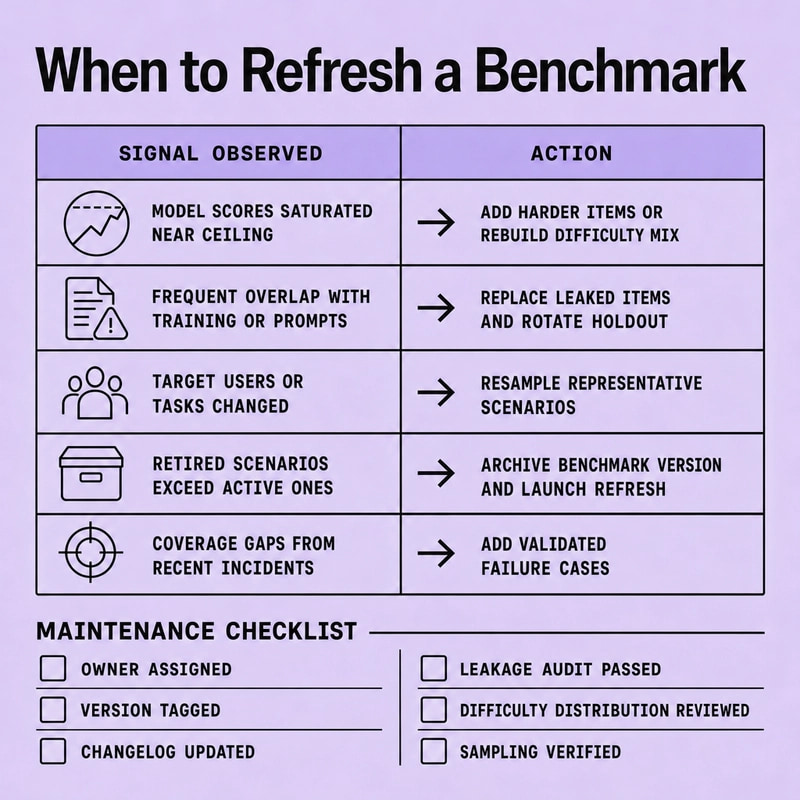
作者给出的刷新顺序是:检查失败日志,标记过时场景,从当前生产范围抽取新任务,检查泄漏,重新平衡难度,再发布类似 SafetyEval v3.0 的新版本,并解释它与 v2.3 之间的趋势中断。旧快照继续保存,保留集也要更新。
我的判断
这套建议最有价值的地方,是把「模型变了」和「测量方法变了」分开。对于经常调整提示词、模型和检索流程的团队,固定题目、评分方式和版本记录,是解释结果的起点。
但原文没有提供实施前后的对照数据,也没有证明按月优于按季度,更没有给出难度配比、相似度阈值或泄漏判定的量化标准。这些属于流程建议和经验判断,不能包装成验证过的最佳参数。文中提到 Imversion Technologies Pvt Ltd,也用了假设性的表述,不能据此认定这是该公司的实测案例。
另一个需要补上的边界是可复现性。冻结题目和评分脚本,能固定测量条件;如果模型输出或评分过程存在随机性,重复执行仍可能得到不同分数。原文没有展开这些变量。
「冻结核心集+扩展集」也有维护成本。相比只保留一套滚动题库,它更利于追踪趋势,但需要分别解释结果;核心集长期重复使用,同样会暴露并失去区分度。冻结不能代替泄漏检查。
能拿来做什么
- 如果正在比较模型或提示词,先固定当前题库、标签和评分脚本,为结果记录准确版本;以后新增或修改题目时,把可比性说明写进发布记录。
- 为 AI 功能建立独立故障候选池,记录用户任务、实际输出、预期结果和失败原因,完成去重与审核后,再按固定周期纳入正式评测。
- 检查现有题库是否过度集中于英文、某类任务或最近一次事故,并按真实用户、语言和风险补齐覆盖缺口。
- 当分数持续上涨却无法解释实际体验,或多数候选模型都接近满分时,检查泄漏、难度饱和与任务漂移,再决定修补题库还是发布新版本。