多智能体协作,先把交接条件写清楚
编码智能体之间的任务交接应明确起始版本、复现命令、验收结果和完成确认权限,仅描述故障现象不足以支持执行。文章汇总了四篇实践记录,但作者未亲自复现其中结论。
AI 深度解读
多个 coding agent 一起干活,最容易丢的往往不是代码,而是交接时的任务边界:从哪个提交开始、怎样复现、改到什么程度、由谁验收。原文的主张很明确:继续堆聊天记录,不如把交接做成可验证的契约。
它把任务契约、运行台账和审批关卡串成了一套流程。对用 AI 写代码的团队,价值在于让执行、证据和责任对得上。不过,作者明确说自己没有复现实验,文中的工具效果和数字应当按来源方的报告理解。
下一位 agent 收到任务后,能直接开工吗
「CSV 导出丢了筛选条件」准确描述了症状,却没定义工作。执行者仍然不知道复现版本、预期结果、允许修改的范围,也不知道谁有权确认完成。
任务契约要补齐这些信息。它不属于某种工具:工单系统能承载,仓库里的 HANDOFF.md 也能承载。关键是把上下文、权限边界、交付证据和验收责任写清楚。
实现者不能靠宣布完成,替代独立验收。
原文用一个很小的 CSV 样例说明职责:产品负责人准备三条记录,两条 open、一条 closed,筛选后的导出必须恰好两行;工程师确认问题和代码路径;执行者先在指定 revision 复现,再修改,并检查未筛选导出是否仍然正常。工程师审 diff 和回归证据,产品负责人确认筛选语义。
如果指定版本复现不了,应该先交回命令、环境和实际输出。直接改代码,可能修的是另一个问题。这套 CSV 流程是建议检查项,来源没有声称它已经跑通。
下面这份配置校验契约,展示了怎样把停止条件也写进任务:
outcome:    reject invalid worker-count configuration before startup
scope:
  allowed:  config parser and focused parser tests
  excluded: deployment, credentials, queue architecture
inputs:
  revision:     record the real base commit
  config_key:   replace with the actual key
  reproduction: supply a synthetic invalid value
acceptance:
  - omitted value preserves the current default
  - valid positive integer preserves behavior
  - zero, negative, and non-integer values are rejected
  - error names the key without printing secret configuration
stop_when:
  - the parser contract conflicts with documented behavior
  - the change requires a production configuration update
  - unrelated failures prevent a trustworthy comparison
重点看 stop_when。来源中的执行者发现 worker count 为零原本就表示自动调整,于是停止并要求修订需求。为了让新测试通过而改掉既有语义,反而是执行错误。
交付还要统一证据格式,避免下一位接手时重新追问:
Before:      command, exit code, observed output, base revision
Change:      files and the reason each file is necessary
After:       same reproduction, focused tests, actual exit codes
Uncertainty: checks not run, and why
Review:      commit reference and named acceptance owner
注意 Uncertainty:没运行哪些检查、为什么没跑,都要写。对应到完整模板里的 untested_cases,留空是信息缺失,明确写无未测项才是可核查的声明。命令必须来自真实仓库,凭据不能贴进契约;环境不可用是阻塞原因,不能靠共享账号绕过去。
审批要发生在写入之前,台账要承认不知道
交接文档解决「接下来做什么」,工具边界解决「现在允许做什么」。
原文介绍的实现用 Work Order 下发任务、Work Report 回传结果,提供 TypeScript package、MCP server 和 Python 实现。Python 与其他实现运行共享测试用例,对相同文档报告相同问题。中间的 MCP gateway 逐次检查工具权限和预算,并记录调用证据。
Version 0.7 加入 staged tools:读取正常执行,指定的写操作先暂存。比如 gmail/send 返回 pending:gmail/send#3,执行者把它列进报告,管理者批准后才按顺序执行一次;退回则丢弃。
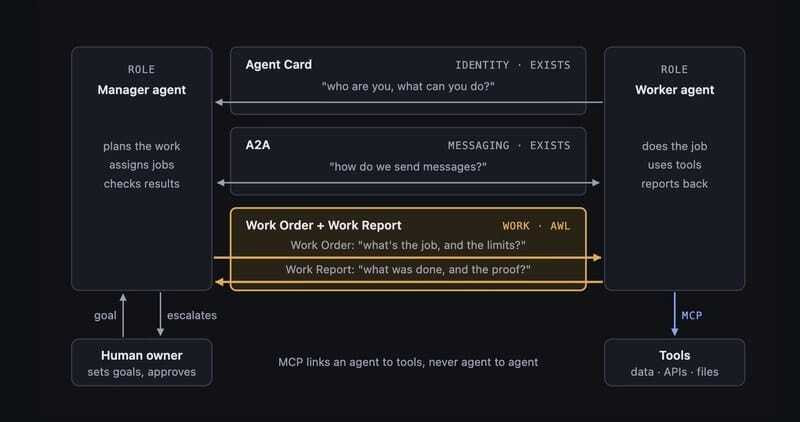
它支持用 effects: ["gmail/send#3"] 选择性批准,也支持后续操作通过 {"$ref": "github/create_issue#3", "pointer": "/structuredContent/number"} 引用前一个结果。执行前会核对报告和真实调用日志,不匹配就全部不执行;来源声称重复运行 --commit,包括崩溃后重跑,也不会重复发送。子 agent 也不能接走暂存工具,绕过管理者审批。
运行台账则解决另一个问题:任务还活着,还是已经卡住?
Agent Board 把看板作为追加式台账的投影。任务先登记再启动;状态由事件记录,健康度在读取时根据状态和空闲时间计算。不可靠的 PID、退出码或用量保留 unknown。Claude session 没有可靠 PID 时,Stop 按钮也会禁用。
启动 wrapper 每 15 秒心跳一次,启动失败记为 failed、退出码 127;reconciler 每 5 秒检查,进程消失但没有退出记录就标 lost,空闲超过 600 秒标 stalled,新事件到来后恢复。生命周期 hook 同步运行,工具 hook 异步运行;锁等待 25 ms、工作预算 150 ms,目标在 200 ms 内退出,失败就丢事件,始终退出零且不写 stdout。
这些取舍让监控尽量不拖慢执行,也限制了完整性。心跳只证明存活;没有总步骤数,就不显示完成百分比。即使解析到 PROGRESS n/total,也仍是 agent 自报。
多加几个审核者,为什么可能更糟
Agent Board 的隔离评审接收有限材料:任务 diff、最多 200 行测试输出、执行报告和原始需求路径,总预算 256 KB。结论必须是 APPROVE 或编号修复清单,否则记为 INVALID。只允许一轮修复,再审仍未解决就以退出码 2 进入人工队列;若用两个模型评审,两者都要批准。
来源记录了 584 次结论:160 次 APPROVE、337 次 FIX、87 次 INVALID,后者约占 15%。修复请求多,可以说明关卡在拦问题,但没有对照数据,无法据此判断代码质量提高了多少。INVALID 也提醒我们:格式约束可能制造额外返工。
并发同样需要上限。该实现按 checkout 路径哈希设置内核 advisory locks,写任务先拿独占 writer lock,再拿两个 slot lock 之一,非阻塞尝试。来源第一天全用 high effort,周额度只剩 11%,第三路并发卡住,于是把上限设为两路。默认 token budget 为 4000 万,超预算停止并退出 125。
人工审批也有容量限制。原文建议回看最近二十次升级决策:双方是在争论「会发生什么」,还是「应该追求什么」?前者可能只缺共同证据;后者涉及吞吐、成本、客户优先级,才更需要人的取舍。
另一篇供应商文章提出,让 agent 给八个交付维度分配权重和退出底线,用 U(o) = w1·u1(o1) + w2·u2(o2) + … + w8·u8(o8) 计算效用,仅在 U(o) ≥ r 时接受。交替报价由 bargaining engine 完成,来源声称约一秒可达成结果。它适用于能明确表达约束和偏好的问题,能否搬进一般编码任务,原文没有给验证。
我的判断
最值得借鉴的是三层职责:契约交代工作,台账记录事实,关卡控制交付和副作用。
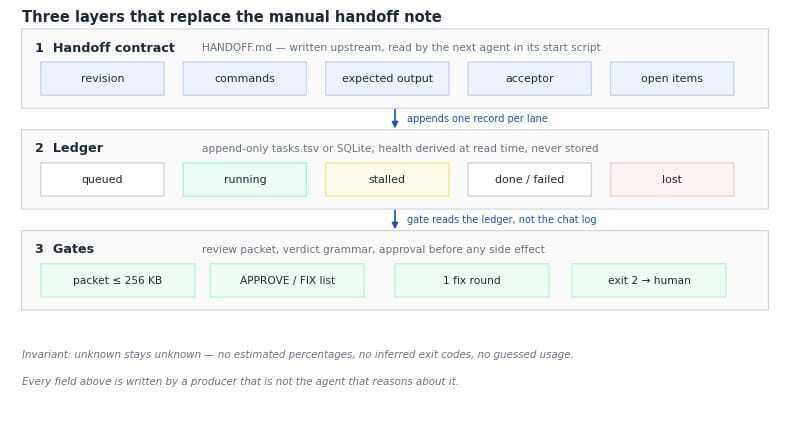
相比转发整段聊天,契约更容易检查遗漏;相比执行后驳回报告,暂存写操作能减少撤销成本。但后者要求工具调用经过统一 gateway,已有脚本、外部进程和子任务能否全部纳入,才是落地难点。
台账也不等于全知。来源在 2026-09-08 至 10-23 的观察中提到 6,568 个 wrapper 外进程,它们靠扫描才被发现,随后可能进入 lost。默认预算依赖 agent 自报 token 事件,进度同样自报。
成本分析也只能作为排查线索:来源第一天记录了 36 个任务,在 36 小时内累计约 24 agent 小时;重复读上下文约占 25%,过大命令输出 18%,重复整体验证 12%,常规任务使用 high effort 12%。这些是单个实践环境的经验,没有对照实验,不宜当成通用收益承诺。
先让两个角色之间的一次交接可靠,再扩大队伍。
另外,原文末尾在凭据提醒处截断,不能补写成完整结论。
能拿来做什么
- 给下一次 AI 修复任务附上
HANDOFF.md,先写真实 base commit、复现命令、预期输出、修改范围和验收人。可以按原文第一周方案,用约 30 行校验脚本检查必填项,以连续十次无需补信息作为目标。 - 做 Node 配置校验时,把默认值和零值语义查清,再给 agent 写验收条件;交付要求包含修改前后同一复现命令的退出码,以及未运行的检查。
- 多 agent 并行前,先登记进程、加心跳和失联检查,再设仓库并发及预算限制。原文第二周补台账,第三周补评审,把人工队列控制在五项以内;讨论循环最多两轮。
- 前端任务验收加入真实数据截图。原文记录过 UI 未打开浏览器就报告 ready 的失败;测试通过以后,仍需有人检查页面实际呈现。