让 AI 写对 SQL,先补齐表间关系
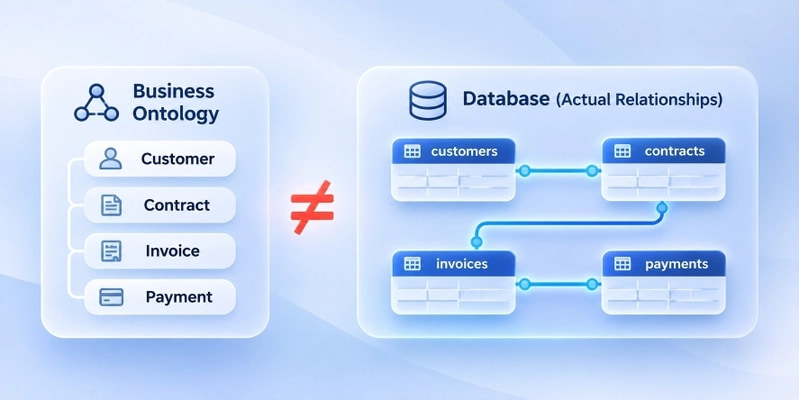
文章指出,业务本体能解释客户、合同和付款的含义,却不能单独确定数据库的正确关联路径。通过跨客户、合同、发票与付款的查询场景,说明业务定义完整仍可能生成错误 SQL。
AI 深度解读
给 AI 补齐客户、合同、收入等业务定义,仍然可能得到一条算错钱的 SQL。问题不一定出在模型理解能力上,而是数据库没有明确记录表之间怎么连接,模型只能对着列名猜。
这篇文章讨论的,是企业 AI 查询里容易被忽略的一层:业务概念与真实数据之间,还需要可验证的关系证据。作者用「本季度有效合同收到多少客户付款」串起关系发现、重复计数和口径审核。它提供了一套值得借鉴的检查方法,但没有给出真实部署的效果数据。
概念解释清楚了,为什么 SQL 还会错
业务本体(Ontology)可以定义客户是什么、合同怎样才算有效、付款与发票有什么关系。但这些定义无法单独证明:数据库里的哪两列应该 JOIN。
原文的例子只有四张表:客户表 crm_customers、合同表 sales_contracts、发票表 billing_invoices、收款分配表 cash_allocations。查询需要经过完整路径:
客户 → 合同 → 发票 → 收款分配。
麻烦在于列名不统一。合同表的 customer_ref 对应客户表的 customer_id;发票表的 agreement_no 实际存放 contract_id;收款分配表的 invoice_ref 对应 invoice_id。如果数据库没有声明这些外键,仅凭业务定义,AI 无法确认这条物理路径。
用户没提发票,查询却必须经过发票。模型一旦跳过中间表,就可能猜出错误连接,或者直接放弃回答。SQL 能执行,只能说明数据库接受它,不能说明它回答了用户的问题。
查元数据当然是起点。作者给出了 PostgreSQL 查询,通过 information_schema.table_constraints、key_column_usage 和 constraint_column_usage 查找 FOREIGN KEY。但在遗留系统、ERP 导入数据和分析仓库里,外键可能根本没有声明。
目录里没有关系,不代表业务上没有关系。反过来,同名字段也未必属于同一个标识域。两个系统都叫 customer_id,并不能据此认定它们指向同一批客户。
数据能对上,还要证明 JOIN 不会把钱算多
作者建议先收集候选关系的证据:类型与格式是否兼容、字段描述是否吻合、不同值数量与唯一性怎样、取值是否存在包含关系,以及已有查询和审核文档是否支持这种连接。
下面这段 SQL 检查发票里的合同编号,有多少能在合同表中找到:
-- PostgreSQL 示例;假设标识符类型兼容。
WITH invoice_keys AS (
    SELECT DISTINCT agreement_no AS id
    FROM billing_invoices
    WHERE agreement_no IS NOT NULL
),
contract_keys AS (
    SELECT DISTINCT contract_id AS id
    FROM sales_contracts
    WHERE contract_id IS NOT NULL
)
SELECT
    COUNT(*) AS distinct_invoice_keys,
    COUNT(c.id) AS matching_keys,
    ROUND(
        COUNT(c.id)::numeric / NULLIF(COUNT(*), 0),
        4
    ) AS inclusion_ratio
FROM invoice_keys i
LEFT JOIN contract_keys c ON i.id = c.id;
要看的是 inclusion_ratio:分母为去重且非空的发票合同编号数,结果保留 4 位小数。它接近 1.0,说明两列很可能有关联,却不能直接证明关联正确。
共享的自增编号、重叠测试数据、迁移期间的临时映射,都可能制造高匹配率。合法关系也可能因为同步延迟、历史记录而匹配不足。因此,包含率适合筛选候选,不适合直接决定生产查询路径。
接下来还要检查基数,也就是两边各有多少行会匹配。一份合同对应多张发票很正常,但被当作父键的 contract_id 如果不唯一,连接就可能产生意外扩张。原文建议用 HAVING COUNT(*) > 1 查重复合同编号,再按发票数量倒序,用 LIMIT 20 查看子表中的高频合同。
这里最容易踩坑的是聚合粒度:你到底在按哪一种记录算钱?
假设一张发票有 3 笔收款分配。把发票与收款分配连接后,发票行会出现 3 次。此时累加 invoice_amount,发票金额也会被算 3 次。
JOIN 正确,不代表汇总结果正确。
能生成查询之后,还缺哪些审核
原问题问收到多少付款,因此作者选择累加收款分配粒度的 received_amount,而不是发票金额。下面的 PostgreSQL 示例展示了完整连接路径:
SELECT
    c.customer_id,
    c.customer_name,
    SUM(a.received_amount) AS cash_received
FROM crm_customers c
JOIN sales_contracts s
  ON s.customer_ref = c.customer_id
JOIN billing_invoices i
  ON i.agreement_no = s.contract_id
JOIN cash_allocations a
  ON a.invoice_ref = i.invoice_id
WHERE s.contract_status = 'ACTIVE'
  AND a.received_at >= :quarter_start
  AND a.received_at < :next_quarter_start
GROUP BY c.customer_id, c.customer_name;
要留意 SUM(a.received_amount),以及 :quarter_start 到 :next_quarter_start 的左闭右开区间。不过,这仍然只是示例,不能直接当作生产口径。
ACTIVE 指今天有效,还是付款发生时有效?退款和冲正是否记为负数?一张发票能否覆盖多份合同?金额有没有跨币种?业务想看的是现金收款、开票收入,还是确认收入?
这些问题无法靠字段匹配解决。它们决定了即使连接路径正确,查询是否仍然答非所问。
作者进一步建议,为候选关系保存结构化证据。例如记录 sales_contracts.contract_id 与 billing_invoices.agreement_no 的对应关系,并保留 declared_foreign_key: false、type_compatible: true、value_inclusion_ratio: 0.98 和 parent_key_unique: true,状态则标为 candidate_requires_validation。
这里的 0.98 是示意值,原文明确说它不是实际部署测量结果。
完整流程应从元数据出发,生成候选列对,检查取值与唯一性,形成候选关系图,再经过业务规则审核,得到适用于具体场景的已批准连接路径。
作者也介绍了其所在 Arisyn 平台的分工:IntaLink 负责主外键关系识别及基于数据的候选关系发现;Semora 负责术语、指标、语义映射、歧义处理,以及 SQL 生成与验证。按其描述,Semora 自己管理连接和权限,映射数据源 ID,再通过 IntaLink APIs 获取关系信息。
这段属于作者的产品能力介绍。文章没有提供准确率、性能或对照测试,不能据此判断产品实际效果。
我的判断
我认同作者把语义、连接关系和使用审核分开。给模型更多业务说明,无法补出数据库里未经确认的字段映射;找到字段映射,也不能自动确定指标怎么算。这几个环节解决的是不同问题。
但文章证明的是问题可能怎样发生,没有证明这套流程在真实团队里能降低多少错误。缺少样本规模、误报率和人工审核成本,它更接近工程方法建议,不能当成已经验证的效果报告。
它也没有比较几种常见替代做法:补齐外键、维护经过审核的 SQL 或视图、在语义层固化关联关系。对范围固定的报表场景,直接维护明确的查询路径可能更省事;面对表多、命名混乱、关系散落在历史 SQL 中的系统,关系发现才更有探索价值。这是按任务范围做取舍,原文没有给出成本对照。
还有一个实用边界:关系获批不等于所有指标都可以放心使用。合同到发票的路径能用于查收款,不代表直接累加发票金额也安全。审核最好覆盖「路径、指标、粒度与时间口径」,而不只是确认两列能连上。
真正需要验收的,是查询结果如何被证明可信。
能拿来做什么
- 做 AI 查询功能时,准备一组包含隐藏中间表、缺失外键和不一致列名的测试数据,检查系统能否找全路径,并明确说明每条连接的证据。
- 在 Node 查询服务里保留候选关系的证据和审核状态,让「推断出的关系」与「已批准的路径」能够被程序区分,避免候选结果直接进入关键业务查询。
- 验证金额类 SQL 时,专门检查一对多连接后的重复计数。沿用原文的例子,让一张发票对应 3 笔收款,分别核对发票金额与实际收款的汇总结果。
- 给 AI 编程助手提供已有的审核 SQL、字段含义和指标口径;当
ACTIVE、季度范围或收入定义不清楚时,要求它指出缺失条件,再继续生成查询。