手写流式 AI 聊天的实现与维护经验
Sybill 团队分享不用 AI 框架构建聊天功能的经历,通过 SSE 传输增量事件,并用异步生成器逐步读取。产品还支持断线后保留回答和多会话并行,作者强调相关工程投入超出预期。
AI 深度解读
做出一个像 ChatGPT 的聊天窗口,难点远不止把模型输出逐字显示出来。Sybill 团队从 2025 年 1 月开始手写 Ask Sybill,陆续补上流式渲染、长对话性能、工具审批和断线续传,花的时间远超预期。
这篇复盘最有价值的地方,是把那些容易漏估的成本摊开了。作者最后的选择也很明确:如果今天重做,会先看 AI 聊天框架。对前端和全栈开发者来说,其中的性能数据和故障处理设计,比「要不要用框架」这个结论更值得细读。
聊天流里传递的,为什么不能只有文字
他们最初没有使用 AI 框架,而是打开 ChatGPT,在浏览器 Network 面板观察答案如何到达:服务器通过 Server-Sent Events(SSE)连续发送小事件,前端逐个处理。
作者用异步生成器(async generator)读取事件。它可以产出一个值,等待更多数据,再继续产出;聊天界面则用 for await 循环消费结果。读取、解析和界面处理因此分开,不必挤进一大段回调里。
下面的代码示意展示了这层分工。
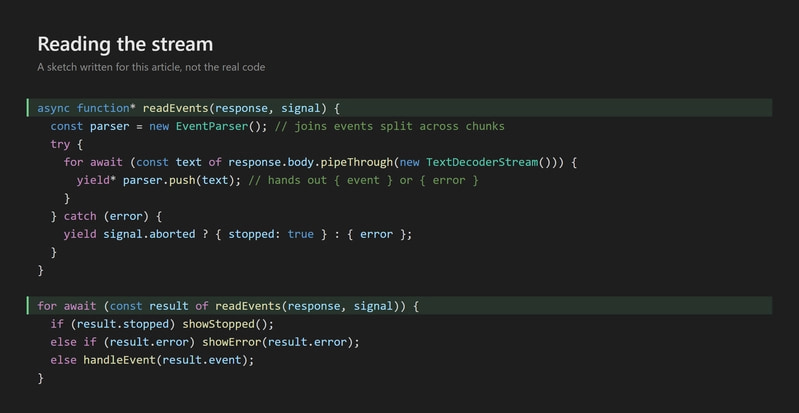
要留意的是错误处理:这个读取器从不抛出异常,而是返回 { error };用户点击停止时,则返回 { stopped: true }。网络故障、无法解析的后端消息和主动停止,都进入同一个循环,再由界面分别处理。主动停止是正常操作,不应该显示成报错。
产品继续增长,事件也越来越多。delta 携带答案片段,chat_title 设置标题,task_progress 展示执行进度,mcp_tool_approval 请求用户批准外部工具调用。一次回答还可能包含 ack、execution_plan、sources 和 done。
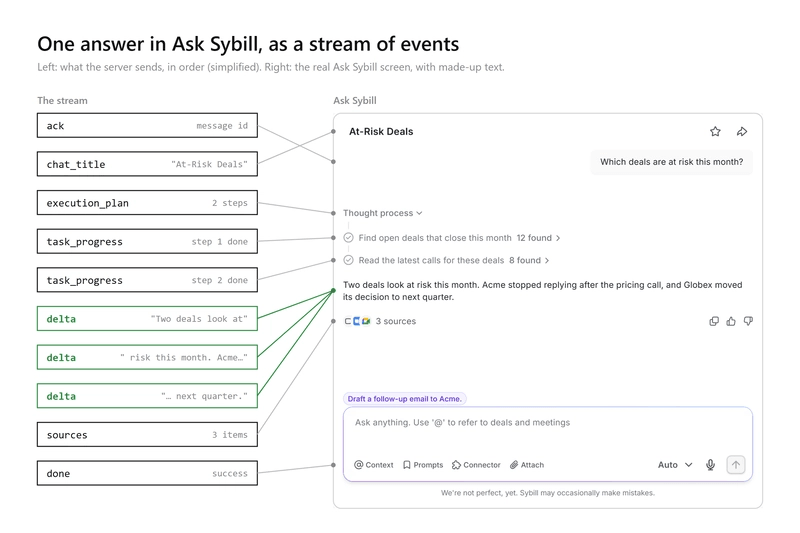
这时,团队维护的已经是一套前后端协议。每增加一种事件,后端要发送,共享类型要描述,前端要解析并展示。作者认为,框架的价值之一就是提前提供常见事件,让团队只扩展自己的业务部分。
流式回答卡顿,先查更新范围和显示节奏
他们其实没有一开始就交付逐字输出。适配不同模型的流、保持页面流畅都需要额外工作,流式功能反复让位于更紧急的需求,早期只能等完整答案生成后再显示。
真正接入后,又碰到两个问题。
第一个是到达节奏不稳定。模型可能一次返回很多文字,然后停一会儿。每个片段都触发 React 重渲染,页面便出现卡顿和文字跳动。团队尝试过节流,跳动仍然存在;也试过固定速度打字,结果模型已经回答完,界面还在慢慢播放。
最终采用的是小缓冲区:先收集新文字,再按屏幕帧更新,多数屏幕上约每秒 60 次。它把网络到达节奏和显示节奏分开,又尽量跟上模型输出。
第二个是状态放得太集中。整个聊天保存在同一个对象里,每次追加文字都产生新对象,所有依赖它的区域跟着更新。作者把流式文本拆成独立的小状态切片,让更新集中在正在生成的消息上。
在一段 15 轮对话的测试中,一次回答流入期间,React 累计渲染耗时从约 3.3 秒降到约 0.35 秒。
流式渲染的成本,既取决于更新频率,也取决于每次更新牵动了多少界面。
长对话还有另一类卡顿。有些用户的聊天超过 100 轮,一次性渲染全部消息,会让最新内容约 24 秒后才出现。
他们先显示最新 10 条消息,再每次补入更早的 10 条,并把后续更新放进 startTransition,让 React 可以在更重要的交互到来时中断这些工作。
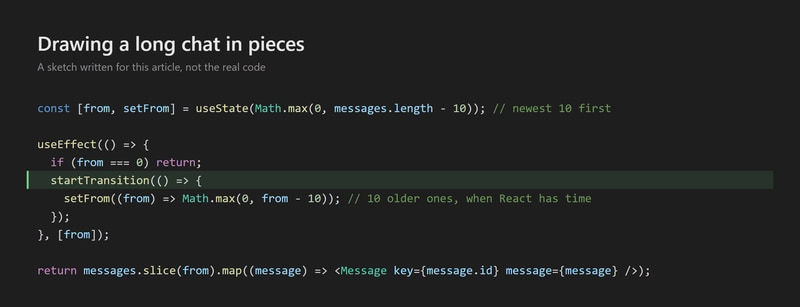
关键是分批推进起始索引,不能只给整份长列表包一层 startTransition 就期待同样效果。调整后,最新消息不到 1 秒便能出现,历史消息继续补入,页面保持可操作。
不过,最终所有消息仍会挂在页面上。作者明确承认:对话再大,还需要虚拟化,只渲染视口附近的消息。分批渲染解决首次打开时的阻塞,虚拟化控制长期存在的节点数量,两者处理的问题不同。
隐藏的 Tooltip,为什么也能拖慢聊天
每条消息下面通常都有复制、反馈、重试等按钮,每个按钮又有提示浮层(Tooltip)。长对话积累下来,隐藏的浮层也有几百个。
他们原先使用的组件库,会让这些 Tooltip 持续参与 React 管理;悬停展示时,还要通过 JavaScript 测量按钮和页面,再计算位置。在一段 124 轮对话里,连续悬停按钮 30 次,累计阻塞页面约 11.5 秒,平均每次接近 0.4 秒。
作者改用 Popover API 把浮层放到页面顶层,再用 CSS anchor positioning 定位到按钮旁边。悬停逻辑移到 React 外的普通 JavaScript 中,展示时只触发当前 Tooltip 的 React 渲染。
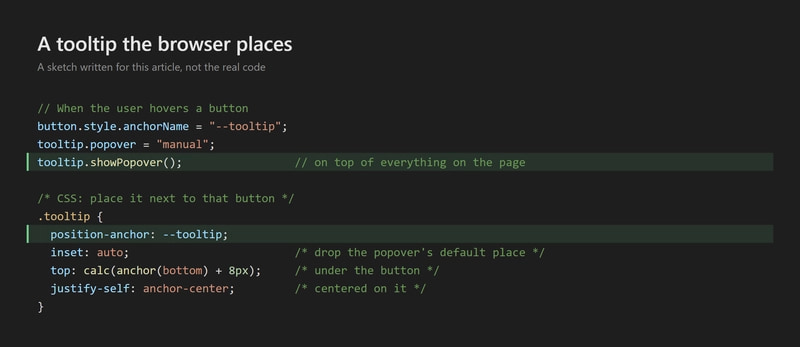
图中需要关注 showPopover 和 position-anchor:浏览器承担展示层级和定位工作。但这并没有完全消除 JavaScript 定位,旧浏览器或浮层无法适配屏幕等情况仍保留回退方案。
相同测试下,30 次悬停的累计阻塞降到约 2.5 秒。这组结果提示我们,聊天页的性能排查不能只盯着答案正文,重复出现的交互组件也可能成为主要开销。
断线后能接着看,后端必须继续生成
他们曾经遇到回答生成到一半丢失:网络断开,或者用户刷新页面,剩下的内容就没了。
解决方案是把每个回答事件写入 Redis Streams。它保存有序消息,并为事件分配 id。浏览器记住最后收到的 id,重连时请求这个 id 之后的事件。如果用户打开一段仍在生成的对话,也按同样方式接入。
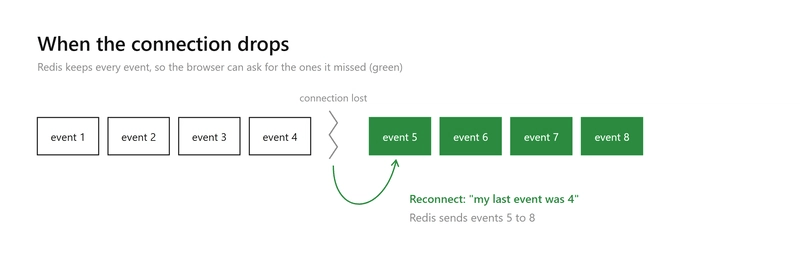
但保存事件还不够。早期实现里,浏览器连接一关闭,后端对模型输出的读取也随之停止。用户回来后,只能补到已经保存的部分,后续答案根本没有生成。
因此,他们把模型输出读取与浏览器连接解耦:后端独立读取模型结果,持续写入 Redis,同时向在线连接推送。浏览器离开后,生成和保存照常进行。
续传依赖两个条件:事件能够重放,生成任务也能脱离浏览器连接继续运行。
还有一个容易遗漏的问题:模型思考或执行任务时,可能长时间没有输出,中间代理会把安静的 SSE 连接关闭。他们在没有业务事件时,每隔 15 秒发送一次心跳,避免连接因空闲被切断。
我的判断
作者对自研成本的判断很有说服力,因为他交代了成本如何逐项冒出来:协议扩展、状态拆分、列表调度、浮层性能、事件存储和任务生命周期,每一项都超出了「调用模型接口」的范围。
但这仍是一篇工程复盘。文中的性能数字来自他们自己的聊天页面,原文没有交代设备、React 版本、消息长度、重复测试方式,也没有提供采用框架后的对照数据。它能证明这些改动在他们的测试里有效,不能证明其他项目会获得同样收益。
作者现在倾向使用 Vercel 的 AI SDK,因为按他的描述,它已经处理了流式文本、停止和工具审批等常见需求。这个选择合理,但原文没有说明框架能否直接覆盖他们的 Redis Streams 续传和后台生成设计,也没有给出实际迁移成本。
对于已经上线的自研系统,我更倾向于先按问题拆解:性能瓶颈可以局部修复,通用流协议可以评估替换,特殊业务事件继续保留。作者也承认,当时迁移会暂停一段时间的产品工作。理解了自研成本,并不等于立即重写就是最划算的选择。
能拿来做什么
- 开发 React 流式聊天时,分别检查文本显示节奏和状态订阅范围。优先让正在生成的消息独立更新,再判断是否需要缓冲,避免只靠节流掩盖整页重渲染。
- 长对话打开缓慢时,可以先显示最新 10 条,再每次补入 10 条,并通过
startTransition降低后续工作的优先级。如果最终节点数量仍然过大,再引入虚拟化。 - 在 Node 后端设计续传时,同时检查事件存储和生成任务生命周期。连接断开后,谁继续读取模型输出、客户端如何提交最后事件 id、空闲期间如何发送心跳,都需要明确约定。
- 新建 AI 聊天项目时,先用自己的标题、进度、停止、审批和续传需求核对框架覆盖范围。把通用能力与业务扩展分别列清,才能估算自研和接入框架各自的工作量。