Claude Code 子代理缓存失效如何推高用量
作者分析两周会话记录,在 134 个子代理中识别出 24 次大规模缓存重写,累计约 850 万 token,并据此开发 Embers 插件。文章通过请求中的缓存读写计数,定位恢复子代理工作时上下文重新计费的现象。
AI 深度解读
Claude Code 的额度涨得快,未必是任务变多了,也可能是同一份上下文被反复写进缓存。作者检查了两周的会话记录,发现自己的主要损耗来自已经完成、过了一阵又被叫回来补活的子代理,而不是最初怀疑的工具等待。
他据此做了插件 Embers:让主会话决定何时续用旧代理,给预计还要返工的代理单独配置长缓存,并缩短等待长任务的间隔。值得看的不只是插件,而是这套排查方法:先找出缓存为什么失效,再判断哪种修补值得付钱。
为什么隔几分钟补一句话,会重新消耗大量额度
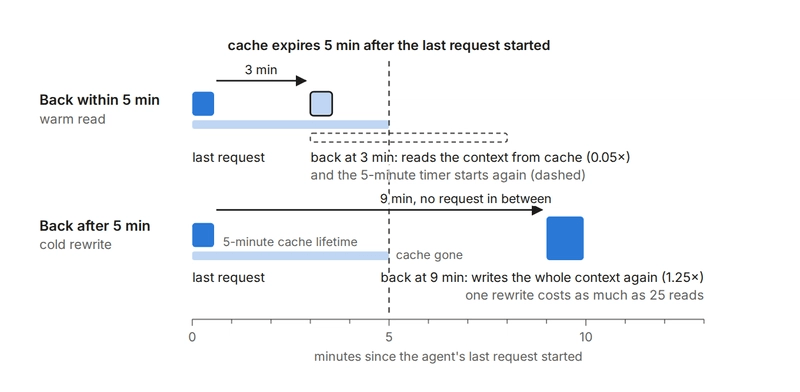
每次请求都会重新提交代理的完整上下文。与之前请求前缀一致的部分,可以从提示词缓存(prompt cache)读取,省下重新处理的成本。
按原文给出的 Opus 5.5 价格,缓存读取为基础输入价的 0.05 倍,写入五分钟缓存为 1.25 倍。同样一批 token,重新写入一次的价格相当于读取 25 次。
缓存的计时起点是上一次请求开始,不是请求结束。
作者称,订阅套餐内的主会话缓存有一小时,子代理只有五分钟;使用 API key、云服务商,或订阅转用 usage credits 时,两者都只有五分钟。命中缓存的读取会重置计时,但已经结束工作的代理不会主动发请求,也就无法自行保温。
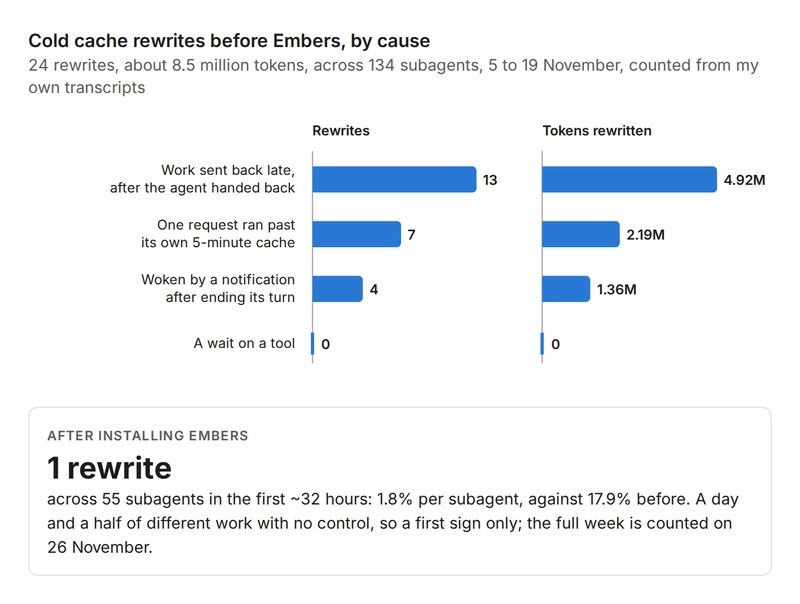
作者分析了 11 月 5 日至 19 日的 134 个子代理。他把「写入至少 100,000 tokens,且读取量比前一次已缓存量少至少 100,000 tokens」记为一次冷缓存重写,共找到 24 次,合计约 850 万 tokens,平均每次约 35 万。
按公开单价折算,这些重写价值 $56.17,占全部子代理提示词成本 $494.66 的 11.4%。不过,订阅没有逐笔账单,作者只是用公开价格估算额度压力,并观察到缓存写入与额度消耗同步。这不是官方公布的额度换算公式。
真正该改的是任务交接,而不只是等待方式
其他用户报告把问题指向长时间工具调用:#103309 中,有人不到 24 小时用掉每周额度的 54%,检查的 190 次超过 100k tokens 的重写,都发生在子代理闲置至少五分钟之后,相关测试要跑 10 至 15 分钟;#99808 则报告约 92% 的重写 tokens 出现在 Bash 调用之后。
但作者自己的 24 次,工具等待占零次:
- 13 次是代理完成后,主会话隔了 5 至 116 分钟再追加任务,重写约 490 万 tokens。
- 4 次是代理结束当前轮次后,隔了 1 至 11 分钟被系统通知唤醒,重写约 140 万 tokens;其中一分钟的案例可能是前缀改变。
- 7 次没有闲置,而是单次请求生成了 28,000 至 63,000 个输出 tokens,持续 5 至 8 分钟,结束时自己的缓存已经过期,重写约 220 万 tokens。
这直接改变了解法。给子代理加「定时醒来」的指令,救不了已经交差的代理;要控制追加任务的时间,必须改主会话的行为。
Embers 通过 SessionStart hook 注入指南,要求主会话在子代理完成时运行 date。作者把完成后 240 秒作为优先续用窗口,给最后一次请求的生成时间留出余量。不过,这仍是经验边界,不能保证缓存一定还热。
超时之后,再比较冷启动旧代理和新建代理的成本。作者测得新代理基础上下文约 36k tokens,再假设需要读取 30k 文件内容,起步约 66k。他选择以 150k tokens 为分界;旧代理掌握未保存到文件的工作时,分界提高到 350k。
这些阈值不是模型定律。它们建立在十轮后续交互、新代理分别需要重做约 65k 或 220k tokens 工作的假设上。代理大小可以参考完成通知里的 <subagent_tokens>;作者样本中,它与最后一次请求的上下文相差不超过 1%。
一小时缓存和定时轮询,都有自己的账单
把 subagentPromptCacheTtl 全局设为一小时,看起来省事,但一小时缓存每次写入要付基础输入价的 2 倍,高于五分钟的 1.25 倍。
按作者计算,只有约 38.5% 的五分钟缓存写入属于「间隔 5 至 60 分钟后发生的重写」,全局延长才达到盈亏平衡。他的重写占比只有 24.8%,而且未必都能被一小时覆盖。其他用户估算从贵 8.6% 到省 10.5% 都有,收益取决于工作负载。
Embers 因此提供 embers:relay,在代理文件里通过 experimental: { cacheTtl: 1h } 单独配置一小时缓存,供多轮审查、已知稍后还会追加任务的工作使用。按其假设,若只在收尾时续用一次,迟到 5 至 60 分钟的续用比例需超过 62.5% 才划算;累计续用上下文达到最终上下文四倍时,门槛约为 16%。
五分钟代理则由 SubagentStart hook 提醒:长任务放后台,前台分段等待。这条命令用于每次最多等待 170 秒后返回:
timeout 170 bash -c 'until <done-condition>; do sleep 15; done'; echo rc=$?
注意 170,以及调用 Bash 工具时另设的 timeout: 200000,单位为毫秒。Bash 默认超时为两分钟;从 Claude Code 2.1.318 起,后台子代理还会在三分钟后把 shell 命令转入后台。原文中的 <done-condition> 是待替换条件。
公共讨论提出过 270 秒间隔,但没有前后对照。作者采用更短间隔,也是因为缓存从请求开始计时。按 300k tokens 的 Opus 5.5 上下文估算,每次轮询约六美分,重写比读取多 $1.44,等待约一小时内轮询较便宜;等到两小时,则约多花 $1.30。
安装命令如下,前提是 python3 已在 PATH 中:
git clone https://github.com/Ev3nt1ne/embers
claude plugin marketplace add /path/to/embers
claude plugin install embers@embers
注意将 /path/to/embers 换成实际目录。还要让 subagentPromptCacheTtl 和 CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL 保持未设置:两者都会覆盖代理文件配置,即使显式设成 5m,也会让 relay 丢掉一小时缓存。
我的判断
我赞成先查 transcript,再决定改哪里。长测试、晚追加任务、单次生成过久,最终都表现为缓存重写,处理方式却完全不同。作者最有价值的发现,是证明了自己的第一判断不成立。
但 Embers 的节省效果还只能算早期信号。安装后约 32 小时,55 个子代理出现一次重写,每代理重写次数从 17.9% 降至 1.8%;两段时间处理的任务不同,也没有对照组,不能据此认定插件能稳定省下同等比例的额度。
长缓存也有边界。作者观察到八个 relay 的全部 528 次请求都写入一小时缓存,但这不能单独证明晚续用必然命中。#94728 和 #87215 分别报告过含 thinking blocks 的历史、消息唤醒导致的期内重写,作者尚未在当前版本验证。
此外,usage credits 和 hook 无法读取的托管配置可能把缓存降回五分钟;等待超过一小时仍会失效;单次生成超过五分钟的七次重写,也没有被等待规则解决。作者明确说过,relay 对最后一类情况的帮助尚未测量。
相比全局延长缓存,我更认可按任务选择;相比频繁给旧代理补一句话,先整理一份完整交接说明更容易控制成本。但 150k、350k 和轮询间隔都应该视为可调整参数,不能当成通用最佳实践。
能拿来做什么
- 在 Claude Code 额度异常上升时,先检查 transcript 的缓存读写量,把晚续用、长工具调用和长生成分开统计,再决定是否调整缓存。
- 给前端改造或代码审查子代理追加任务前,尽量合并已知要求,并让它把结论和改动位置写入文件,降低新代理接手时的重做成本。
- 对测试、构建等长任务,先确认重写确实发生在等待之后,再尝试分段等待;同时计算轮询成本,避免把长时间保温当成免费操作。
- 使用 relay 时,检查
ephemeral_1h_input_tokens是否大于零,并在 10 至 50 分钟后续用,观察cache_read_input_tokens是否接近此前上下文大小,用自己的记录验证配置是否有效。