生产级 Agent 该留下哪些审计记录
文章围绕动作、授权者与可验证证据设计 Agent 审计链,将输入、工具调用和决策关联到身份及时间戳。它区分短期调试日志与长期审计记录,并以能否重建决策过程作为记录完整性的判断标准。
AI 深度解读
Agent 删除了一条客户记录,事后却找不到提示词、工具调用和审批人,排查就只能靠猜。原文讨论的是:怎样给 AI Agent 留下一条能查清动作、确认授权、验证记录完整性的审计轨迹。
作者的结论很明确:生产环境里的 Agent 不能只记录报错,还要记录身份、输入、动作和授权依据,并保护这些记录免遭篡改。对正在接入工具调用、自动修复或人工审批的团队,这是一份可参考的设计清单,但距离完整的生产方案还有几处缺口。
为什么有了运行日志,还需要审计轨迹
运行日志通常服务于开发者,用来查延迟、异常和调用失败;审计轨迹还要服务于安全人员、审计人员和事故调查者。他们可能几个月后才来查,关注的是:谁执行了动作、谁允许它执行、有什么证据。
因此,审计事件需要稳定的结构和更长的保存周期,不能跟着调试日志一起快速轮转。
作者要求每个事件都携带 agent ID、agent version、human user、session、trace ID 和环境信息。提示词修改、模型替换都可能改变行为,只知道 Agent 名称,无法确定当时运行的是哪一套配置。staging 和 production 也必须区分,否则测试退款和真实退款看起来可能完全一样。
这些信息要放在每个事件里。只在会话开始时记一次,后续事件被单独检索时就容易丢失上下文。
一次工具调用,要留下哪些证据
作者把记录内容分成三组:谁在执行、看到了什么并调用了什么、动作为什么被允许。
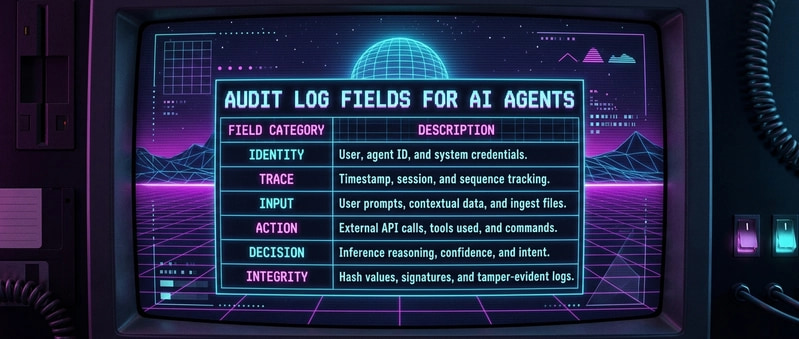
输入侧应记录工具名称、参数和目标系统。提示词则保存哈希与指向受保护全文的指针,检索上下文保存文档 ID,避免把敏感全文复制到每条日志中。工具返回值至少保留状态和简短摘要,用于判断后续动作是否依据了正确结果。
下面是原文的最小事件示例,用于把一次退款调用关联到具体 Agent、版本和用户:
{
  "event_id": "evt_01HZX9",
  "trace_id": "tr_7f3a",
  "agent_id": "refund-agent",
  "agent_version": "2.4.1",
  "user_id": "u_1842",
  "action": "tool_call",
  "tool": "payments.refund",
  "arguments_hash": "sha256:9b1c...",
  "status": "success",
  "ts": "2026-11-16T09:41:58Z"
}
要留意 arguments_hash 这一行:哈希可以用于校验,却不能还原参数。若要支持事后复核,还得能找到受控保存的原始参数。这个最小示例也没有包含前面要求的环境、session、模型和审批字段,不能直接当作完整规范。
授权侧需要记录 model ID、执行过的策略检查及各自结果。人工批准时,保存审批人和时间;护栏拦截时,也要留下记录。被阻止的尝试可能比成功调用更能暴露风险。
审计不仅要证明动作发生过,还要说明它凭什么获得执行权限。
这里的「为什么」应理解为可核查的策略与审批依据,不能指望一段记录完整解释模型内部如何产生了决定。
结构化和防篡改,需要一起设计
作者建议使用固定且有版本的 JSON schema,并让同一个 trace ID 贯穿 Agent、工具和服务。OpenTelemetry span 已有父子关系,可以把审计字段作为 span attributes,再导出到专用存储。
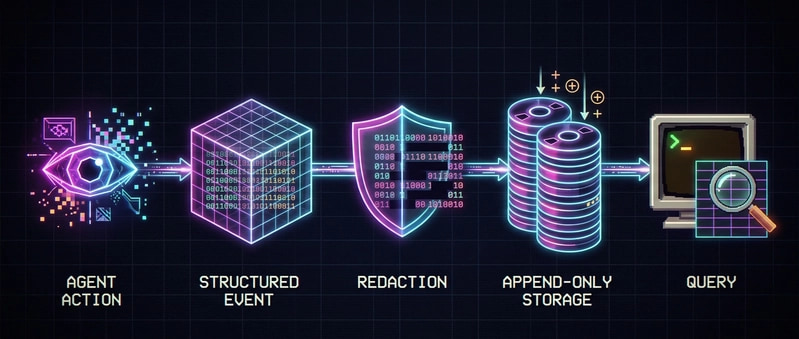
独立存储能让审计数据的结构和保留规则更稳定。不过,原文所说的查询「几秒返回」没有测试规模、索引设计或测量结果,只能视为目标,不能当作性能保证。
完整性方面,作者提出只追加写入、哈希链,以及带保留锁的 write-once storage。下面的示例让每条事件关联上一条记录的哈希:
import hashlib, json

def append(log, event):
    prev = log[-1]["entry_hash"] if log else "0" * 64
    body = json.dumps(event, sort_keys=True)
    event["prev_hash"] = prev
    event["entry_hash"] = hashlib.sha256((prev + body).encode()).hexdigest()
    log.append(event)
重点看 entry_hash 的计算:它把上一条哈希和当前事件正文一起纳入校验。修改历史正文后,原有链条会出现不匹配,作者因此要求定期运行验证器,并对异常告警。
但这段代码只是演示。若攻击者能重写全部记录并重新计算哈希,仅靠链条本身不足以证明历史可信;尾部记录被删除,也需要额外依据才能发现。原文没有交代这些边界,生产方案仍需考虑受保护的校验基准与存储权限。
数据内容同样需要约束:不记录原始密钥、API keys 和 session tokens,个人信息在入库前脱敏,全文放进独立的访问受控存储。保留期限按风险和法规确定,读取审计记录的行为也要留下记录。
我的判断
我认同作者把「授权证据」放到显眼位置。Agent 接入真实工具后,只有报错堆栈和最终回复,通常不足以还原一次操作。相比把所有内容塞进普通应用日志,独立的事件结构更便于持续查询和复核。
但「陌生人能仅凭记录重放决策」这个标准需要收紧理解。文档 ID 对应的内容可能更新,工具结果摘要也可能省略关键细节;模型调用还未必能确定性复现。记录有助于重建经过,不等于保证重放出相同结果。
全文没有给出团队实测、事故复盘或成本对照,主要是一组工程建议。末尾的 Xccelera 案例属于产品自述:它声称将依赖发现、升级、代码修复和测试纳入证据记录,却没有提供可验证样例或对照数据,不能据此判断效果优于其他方案。
能拿来做什么
- 给 Node Agent 的工具执行入口统一生成审计事件,先覆盖身份、版本、环境、trace ID、工具、结果与授权依据,避免每个工具各写一套日志。
- 为提示词和工具参数建立受控存储与引用关系,同时处理敏感信息,确保哈希对应的原文在调查时仍可找到。
- 给自动依赖修复流程串起完整证据,记录发现了什么、升级了什么、修改了什么,以及哪些测试通过、谁批准继续执行。
- 用一次真实工具操作检查审计链路,确认能查到输入引用、策略结果和最终输出,再验证历史修改是否会触发完整性告警。