跨编程 Agent 记忆服务,真的需要吗
作者通过安装运行和源码审阅,评估 ai-memory 共享多个编程 Agent 会话背景的方案。其判断是项目有实际工程投入,但引入常驻记忆服务前,应先考虑更简单的免费替代办法。
AI 深度解读
在 Claude Code 里干了两个小时,切到 Codex,又得重新交代任务。ai-memory 想用一套共享记忆服务解决这个问题。拆解作者安装、运行并检查代码后,认可它的工程质量,却给出一个相当克制的结论:多数个人开发者可能暂时用不上。
这篇文章值得读的地方,是把「软件做得好」和「你需要安装它」拆开讨论。AI 让功能开发更便宜,但配置、维护和理解这些功能的成本,仍然需要使用者承担。
跨 Agent 接力,究竟需要保存什么
Claude Code 和 Codex 各自保存会话记录。切换工具时,新 Agent 不知道旧 Agent 做过哪些尝试、留下什么问题,开发者就得重新补充上下文。
ai-memory 的方案是运行一个常驻服务,让二十多个编程 Agent 共用记忆。会话结束后,安装在工具里的 hooks 自动捕获对话,先清理 API key、token 等敏感内容,再把原始记录整理成笔记。
笔记有两份存储:提交到 git 的 Markdown 是记忆原件,数据库负责建立索引,可以从笔记重建。这个设计让内容有机会脱离服务继续保存和阅读,不必完全依赖数据库。
下一次启动 Codex,它会向服务领取交接记录,接着处理之前的工作。需要查询历史时,系统会综合全文、实体、图邻居、可选向量和已记录的观察信息,合并检索排名。大白话解释,就是同时找文字匹配、相关对象和关联记录,再排出结果。
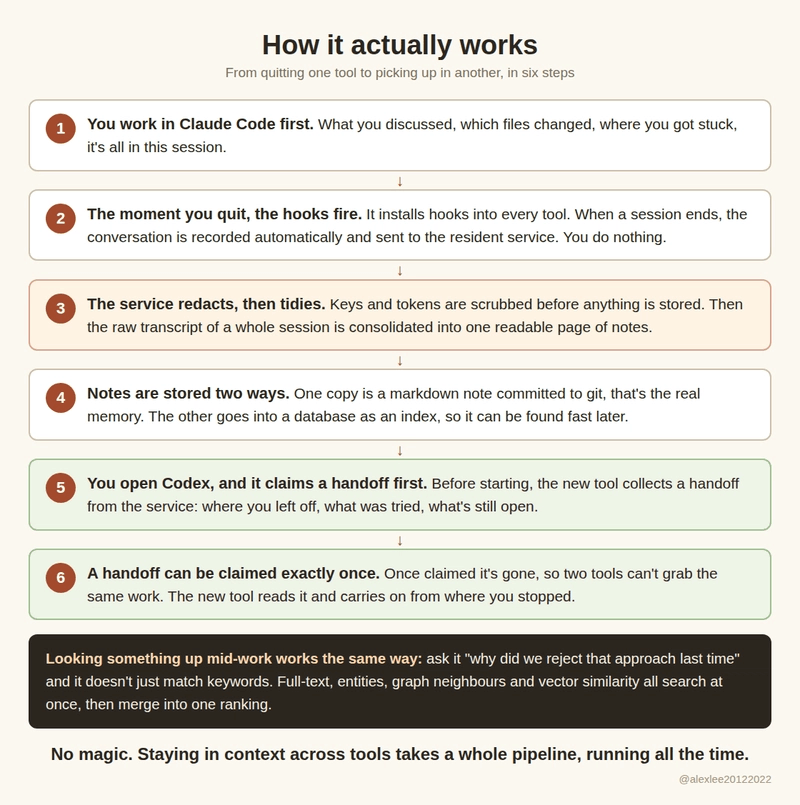
交接记录只能领取一次,避免两个 Agent 同时接走同一项工作。作者实际重复领取过,第二次得到的是没有待处理交接的反馈。
这已经超出了「保存聊天记录」的范围。它还在处理任务交接和多人协作中的部分协调问题。
工程质量有证据,检索成绩仍需分开看
按原文记录,ai-memory 当时位列 GitHub 总趋势榜第 9,超过 14,000 stars,包含 528,000 行 Rust、11 个 crates,以及 88 次数据库迁移。它提供 24 个 MCP tools 和约 70 个 CLI 子命令,体量相当可观。
这些是文章写作时的快照,不能当成当前排名。但作者确实做了几项检查:运行超过 1,200 个测试,全部通过;故意在会被 hooks 捕获的提示中放入假 API key,再直接检查数据库,发现保存的是脱敏结果,假密钥没有字符残留。
这证明被测路径上的脱敏有效。它还不足以覆盖所有秘密格式、异常路径或安全边界。
检索数据也有一个有意思的反差:项目自报的基准里,不调用 LLM 的纯全文检索得分为 0.951,略高于内置向量检索的 0.945。作者明确说自己没有复跑。
因此,可以保留的结论是:在项目公布的那组评测中,全文检索表现更好。原文没有交代完整评测条件,不能据此推导所有记忆检索都该放弃向量。它更像一个提醒:引入更复杂的检索方式,需要先证明收益。
免费运行,不等于免费获得好用的记忆
作者最有说服力的反例,来自「不配置 LLM 也能工作」这个卖点。
他没有设置 API key,运行后查看生成页面,拿到的摘要只有:
「1 prompt, over 42s, ended (exit).」
它记录了 1 次提示、持续超过 42 秒和退出状态,却没有说明做了什么、为什么这么做、下一步是什么。运行链路成立,交接价值却很有限。
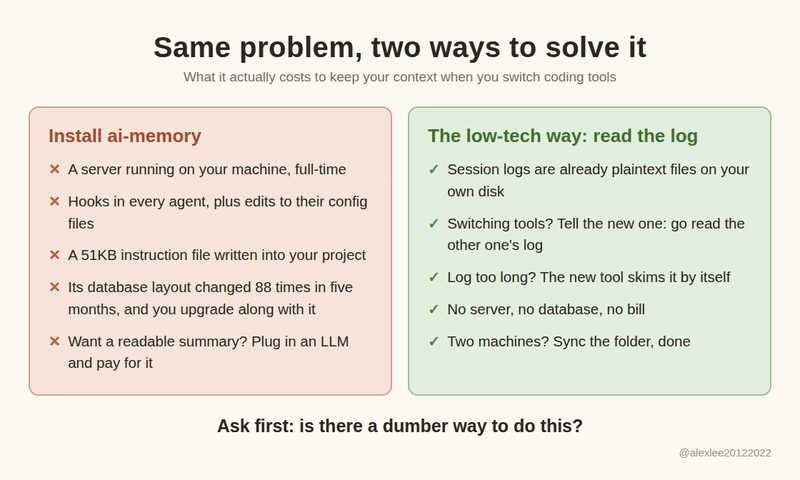
要得到人愿意读的总结,需要接入 LLM 并支付 API 调用费用。作者因此认为,它与付费记忆服务的成本差距会缩小。不过原文没有列出具体调用量、价格和对照产品,这仍是方向判断,不能当成成本测算。
更容易被忽略的是接入成本:本机常驻服务、各个 Agent 的 hooks、会修改配置文件的安装流程,以及写进项目的 51KB 指令文件。项目五个月里发生了 88 次数据库结构变更,也说明系统仍在快速演进,但不能直接推断用户要手动处理全部迁移。
作者还估计,约三分之二的代码由 AI 编写。这个比例是拆解者的估算;项目开发者公开承认大量使用 AI,并称借助 AI 在一个周末完成了从 Ruby 到 Rust 的迁移,README 也将 Claude Code 列为协作者。
代码生成变便宜,并没有自动降低使用者的接入成本。
作者据此提出一个更简单的替代方案:Claude Code 和 Codex 都会在本地保存明文 JSONL 会话日志。切换时,让新 Agent 读取另一个工具的日志;记录太长,就搜索、筛选相关部分。跨机器则同步日志目录,Git 也是他提出的选项。
我的判断
我赞同作者把「是否需要」放在「功能是否齐全」前面。个人开发者偶尔在两个 Agent 之间切换,首要问题通常是补齐当前任务的上下文。先尝试读取日志,能更快知道问题到底有多大。
但「读日志就够了」也有前提:新 Agent 能访问文件,日志里能找到相关信息,而且使用者接受每次切换时进行筛选。原文没有比较两种方案的耗时、上下文遗漏率或长期使用效果,所以它目前是作者的个人实践,不能替一般团队下结论。
原始日志还可能包含密钥和内部信息。ai-memory 的自动脱敏有被测路径作为证据,直接同步日志的替代方案则没有给出等价处理。若采用后者,需要把日志能否共享也纳入判断。
多人使用不同 Agent、需要权限管理、经常跨机器交接时,自动捕获、统一检索和单次领取交接就有明确价值。只是,领取一次只能避免同一条交接被重复领取,不能据此认定整个系统已经解决所有并发协作问题。
这篇文章提供了一个不错的选型顺序:先验证轻量方案在哪一步失效,再决定是否引入完整服务。至于 ai-memory 是否值得用,仍要看团队是否真的需要它承担那些额外工作。
能拿来做什么
- 如果你在同一个前端或 Node 项目中切换 Claude Code、Codex,可以先让新 Agent 读取上一段会话日志,检查它能否准确复述已完成事项、失败尝试和待办,再决定是否需要共享记忆服务。
- 如果日志太长,先筛选当前任务相关记录,或补一份简短的交接 Markdown。把下一步工作和关键决策写清楚,比单纯积累更多历史更容易验证效果。
- 如果团队考虑引入 ai-memory,应拿真实的多人交接任务试用,重点观察检索是否找到所需内容、权限是否合适、交接是否顺畅,并单独检查不配置 LLM 时的输出是否可用。
- 如果准备跨机器同步日志,先检查其中的密钥、token 和内部信息,再确定同步范围;原文验证过服务的一条脱敏路径,没有验证直接同步原始日志同样安全。