本地扫描 Claude Code 历史操作风险
agentdryrun 读取本机 Claude Code 会话记录,按规则模拟判断历史操作应放行、人工确认还是拒绝,不执行或修改任何操作。扫描范围涵盖递归删除、强制推送、下载脚本执行、敏感文件读取及数据外传,支持 Python 3.9 以上且无依赖。
AI 深度解读
权限弹窗点了「允许」,不代表我们记得代理做过什么。作者引用 Anthropic 的说法:用户会接受 Claude Code 93% 的手动权限请求,于是做了一个只读工具,回看自己的操作记录。
agentdryrun 的用途是按自定义规则重放判断:哪些操作可以通过,哪些需要人工确认,哪些应该拒绝。更有参考价值的是,作者拿真实历史验证后发现,第一版的大部分警报都来自解析错误。
历史记录能回答哪些权限问题
Claude Code 已经把会话记录保存在本机的 ~/.claude/projects。其中包含代理调用的工具、命令或路径、执行目录、时间戳,以及失败信息。
python -m agentdryrun scan 读取这些文件,把操作归类,再按照 JSON 规则文件进行模拟判断。它要求 Python 3.9+,没有依赖,不需要往代理里安装组件,也不需要上传记录。
它复查的是代理尝试过的操作,不会执行命令,也不会阻止操作。
检查范围集中在容易造成损失的动作:
- 递归删除会区分项目内、项目外、用户主目录和无法解析的路径。
- 强制推送、删除远程分支会被识别,涉及
main时判断更严格。 - 检查
curl ... | sh,以及读取.env、SSH 密钥、云凭据和向其他主机发送文件或命令输出。 - 识别破坏性数据库、云命令,以及修改代理设置、CI 工作流、Git hooks、shell 启动文件的行为。
- 对 MCP 工具,根据名称推测它是否会修改、发送或删除内容。
这里的规则需要自己调整。scan --write-rules 会生成一份副本,把个人历史里没有出现过的操作类型锁住;它并不能证明这些操作今后都不需要。
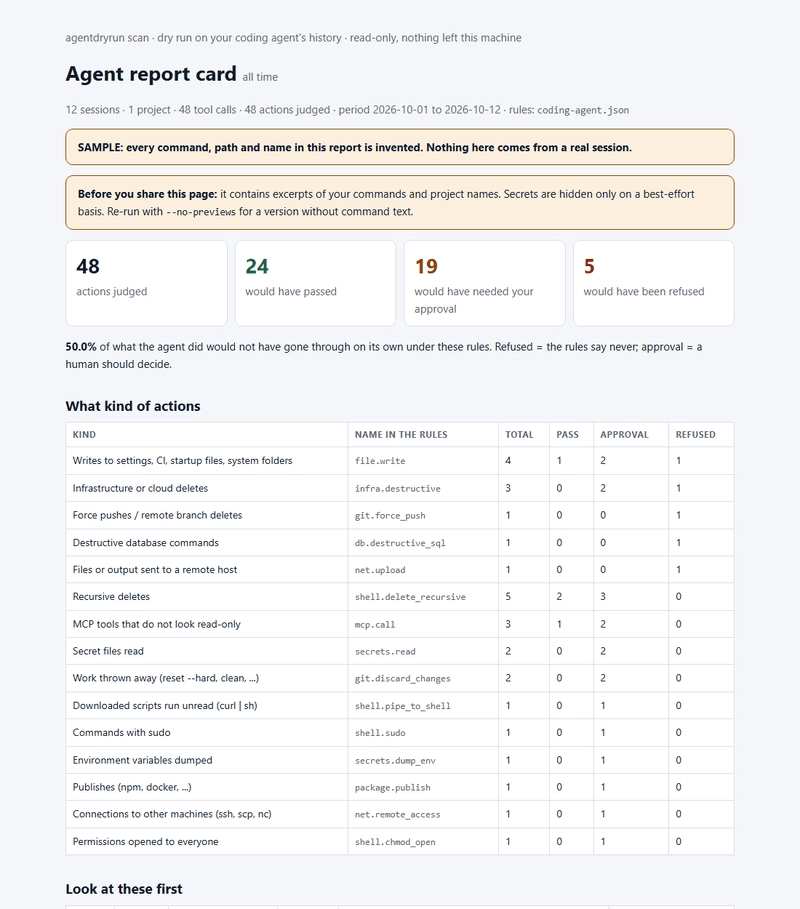
图中 48 次操作、24 次通过、19 次需要审批、5 次拒绝,是虚构命令组成的演示,不是作者的实测结果。
为什么真实记录让警报大幅减少
作者用一份真实的 90 天历史测试第一版,约有 11,000 次工具调用。结果约五分之一需要审批,还有二十多次会被拒绝。继续排查后,发现几乎全是解析器制造的噪声。
例如,curl ... | python -c "..." 被认成下载后交给 shell 执行,但该案例中的 Python 代码只是读取下载内容。here-document 里正在写入文件的文字,也被当成命令分析。
路径判断同样容易出错。rm -rf "$DIR/build" 即使上一行已经设置变量,仍会被判为路径无法确认;cd other-folder && rm -rf build 则使用了错误的工作目录。第一版还把所有工作目录之外的写入都算作问题,忽略了跨目录开发的正常需求。
修复这些问题后,需要审批的比例降到约 3%,拒绝项剩下两次,都是实际发生的向 main 强制推送。
安全检查是否有用,既取决于查得多严,也取决于能否正确理解命令上下文。
作者把这些案例加入回归测试,并公开构建日志。但这仍是一份个人历史上的结果,没有其他团队或工具的对照数据。
怎么运行,以及它看不见什么
原文给出的运行方式如下,适合先生成一份不展示命令文本的报告:
git clone https://github.com/ntinosgkiou-code/agentdryrun
cd agentdryrun
python -m agentdryrun scan --no-previews
重点是最后一行的 --no-previews:它会从页面中省略命令文本,方便分享,但原文没有说明报告是否还包含其他敏感字段。
也可以在 Claude Code 中依次执行 claude plugin marketplace add ntinosgkiou-code/agentdryrun、claude plugin install agentdryrun@agentdryrun,再调用 /agentdryrun:scan。
它靠命令模式匹配工作,可能漏掉脚本内部的删除行为、python -c 中的操作和运行时生成的路径,也可能误报无害命令。虽然记录包含失败信息,工具仍不能据此确认命令最终是否成功,更不知道用户是否批准过。
目前只支持 Claude Code。读取器依据 2026 年 10 月 25 日看到的记录格式编写,该格式不是公开接口,升级可能导致失效。Codex 等其他代理的适配还需要脱敏会话样本,作者在 issue 11 中说明了需求。
项目是 Apache-2.0 协议的原型,未经外部安全审查。作者披露使用 Claude 辅助写作,同时说明代码、测试和测量是真实的。
我的判断
我认可它从真实历史反查规则的思路。频繁点击允许之后,报告可以帮助开发者找到需要认真配置的权限边界,也能暴露规则里的误报。
但约 3% 不能作为一般团队的目标值。操作习惯、仓库布局、规则宽严都会影响结果;作者没有提供漏报率,也没有证明那份历史里的危险动作都被识别了。
它更适合补充 Auto mode、权限规则和沙箱:后者控制执行边界,这个工具帮助检查边界需要覆盖什么。MCP 工具名也只能提供线索,无法替代对实际工具行为的理解。
能拿来做什么
- 先扫描自己的 Claude Code 历史,优先核对强制推送、项目外删除和凭据读取,再决定如何修改权限规则。
- 前端或 Node 项目如果经常清理
build、跨目录工作,要逐条确认路径和变量解析,避免把正常构建操作长期列为警报。 - 分享报告时使用
--no-previews并检查剩余内容;反馈误报、漏报或崩溃时,按作者要求只提交去掉秘密的命令文本。