MCP 协议切换导致采集静默中断三天
HISTOR 在三天内停止读取 2195 个 MCP 服务器,现有监控却未报警,直到对照另一团队的日志才发现异常。文章围绕新旧协议的会话初始化差异,分析兼容处理与监控盲区。
AI 深度解读
HISTOR 连续几天没能读取 2,195 个 MCP 服务器,监控上的成功率却有 98.8%。问题不是服务器集体宕机,而是客户端升级协议后,把大量旧服务器挡在了兼容逻辑之外。最后揭开缺口的,是另一支团队维护的独立日志。
这次事故值得程序员花几分钟读:它把协议兼容、重试退避和监控盲区串到了一起。一个局部看起来更严格的判断,怎样造成大面积漏读,又怎样被漂亮的指标掩盖,作者给出了具体记录。
协议升级为什么会让旧服务器突然读不了
HISTOR 是一个公开记录 MCP 工具定义变化的服务,按 30 分钟到 6 小时的间隔读取官方注册表中的远程服务器。它需要知道服务器提供哪些工具,并记录变化。
事故发生在连接流程升级之后。
截至 2025-11-25 的旧版 MCP,客户端先发送 initialize,双方协商协议版本,再请求 tools/list。2026-07-28 修订版取消了这次握手,改用 server/discover,每个请求自行携带协议版本和能力信息。
同时支持新旧协议的客户端,需要先判断对端属于哪一种。按作者对 Streamable HTTP 兼容规则的说明,客户端应先尝试新请求;如果收到 HTTP 4xx,且响应体不属于新版协议定义的错误,就尝试旧版 initialize。
他们团队在 10 月底接入新协议,却额外收紧了回退条件:HTTP 状态必须是 400、404 或 405,JSON-RPC 错误码必须是 −32600、−32601 或 −32602,而且响应 id 必须与请求一致。
动机可以理解:回退太宽松,客户端可能被诱导使用双方原本都支持的较旧协议。但实际服务器没有那么整齐。
下面是 mcp.quotewise.io 拒绝新协议时的真实响应,它已经明确列出了支持的旧版本:
{"jsonrpc": "2.0", "id": "server-error",
 "error": {"code": -32600,
  "message": "Bad Request: Unsupported protocol version: 2026-07-28. Supported versions: 2024-11-05, 2025-03-26, 2025-06-18, 2025-11-25"}}
关键在 "id": "server-error"。HISTOR 因为它与请求 ID 不符而终止读取。作者指出,官方 Python SDK 的 1.x 系列在尚未读取请求 ID 就发生错误时,也会使用这个值。
另一个例子是 mcp.kaiku.tech:它只允许匿名访问 initialize 和 tools/list,其他请求都要求 Bearer token。陌生的 server/discover 因而得到 401,但发送 initialize 就能正常读取。
2,195 个失联服务器的最后错误分布,展示了严格匹配的代价:
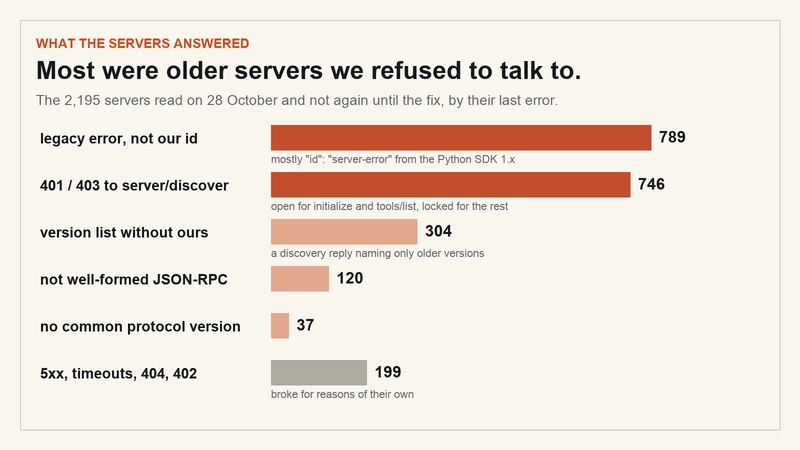
其中,789 个返回其他 ID 下的旧式错误,746 个返回 401 或 403,304 个给出的版本列表不含客户端版本,120 个返回格式有问题的 JSON-RPC,37 个没有共同版本,另有 199 个属于其他失败。
旧协议也远没有退出主流。作者统计的 21,474 个成功读取过的远程服务器中,最新成功记录使用 2026-07-28 的有 4,097 个,占 19%;2025-06-18 有 13,744 个,占 64%。其余分别是 2025-11-25 的 126 个、2025-03-26 的 2,853 个,以及 2024-11-05 的 650 个。
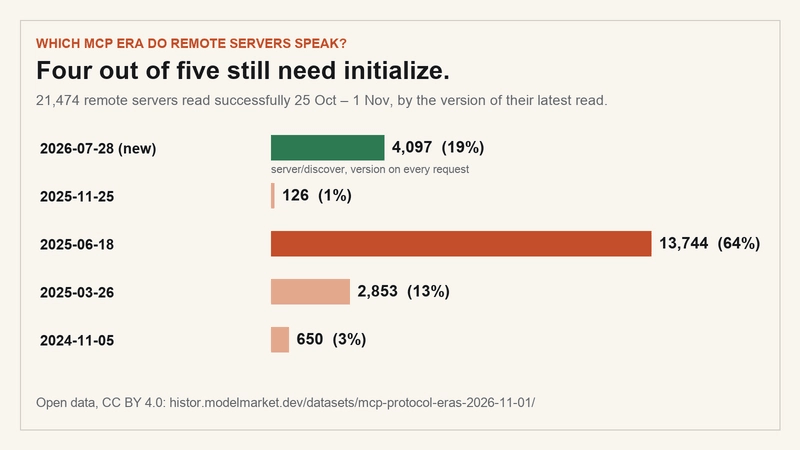
这个分布还有偏差:165 个可能同时支持新旧协议的服务器,最后一次读取发生在 10 月 29 日之前,因此仍被计入旧版本。它是这批服务器的观测结果,不能直接当作整个 MCP 生态的普查。
为什么漏了两千多个服务器,成功率还这么高
修复前一小时,HISTOR 发起 9,514 次远程读取,成功 9,400 次,成功率为 98.8%。
这个数字没有算错,问题出在分母。
读取失败的服务器,会先后等待 6 小时、12 小时、24 小时再重试;遇到 401,至少等一天。连续失败的服务器逐渐退出高频任务队列,剩下的请求自然越来越集中在正常服务器上。
重试退避改变了请求样本,成功率就不再能代表覆盖情况。
对这个采集服务,更接近业务目标的指标是:今天究竟有多少个不同服务器至少成功读取过一次。这个数从 10 月 29 日约 28,200 个,跌到 10 月 31 日约 23,000 个,可惜他们没有给它配置告警。
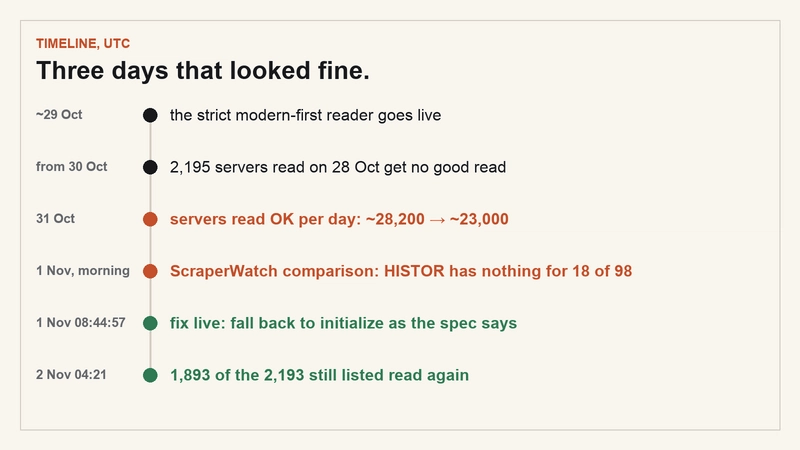
这里也不能把覆盖数量的全部跌幅,都归因于这次兼容问题。原文明确追出的事故集合,是 10 月 28 日正常、从 10 月 30 日到修复前一次都没读成功的 2,195 个服务器。
这类监控陷阱并不限于 MCP。只要任务失败后会降低执行频率,就需要同时回答两个问题:执行过的任务成功了多少,以及应该覆盖的对象还有多少没有成功处理。
独立日志怎样把 15 个异常追成 2,195 个
ScraperWatch 从 10 月 30 日开始记录 MCP 工具变化,每天读取一个固定随机样本,包含 3,000 个注册表服务器。它只支持 2025-06-18,始终从 initialize 开始。
11 月 1 日,HISTOR 团队逐字段路径比较对方的 98 条工具变更记录:64 条完全一致,另有 15 个服务器上的 18 条记录,HISTOR 根本没有对应数据。沿着这些失败继续查询,才找到全部 2,195 个受影响服务器。
双方实现不同,在这里形成了有效互补。不过,对照方也有错误:ScraperWatch 的 robots.txt 解析器误读了约 250 个禁止抓取的样本端点。删除相关读取后,那两天的日志剩下 81 条变更,其中 53 条与 HISTOR 逐路径一致。作者说明,握手问题的发现不依赖被删除的记录。
修复后的读取器允许进行一次旧协议回退,包括这些情况:
- 首次新式请求返回 400、404、405、401 或 403,且符合旧式拒绝特征。
- 旧错误码出现在任意
id下,或者响应体根本不是 JSON-RPC。 - 错误或发现响应列出的版本全部早于 2026-07-28,或者
server/discover响应缺少supportedVersions。 tools/list第一页尚未读到任何内容,就遭到旧式拒绝。作者确实遇到一个宣称支持新版、随后又拒绝新版的服务器。
限流、超时、5xx、重定向、新版协议自身定义的错误,以及含义不明确的响应,仍然终止读取。
修复于 11 月 1 日 08:44:57 UTC 上线。前 90 秒的 172 次远程读取有 171 次成功,其中 145 次使用旧协议。团队没有重置重试计划,而是等待服务器按原有退避时间回来。
按正文后续统计,次日 04:21 UTC,仍在注册表中的 2,193 个受影响服务器已有 1,893 个恢复读取;剩余 300 个中,161 个因 HTTP 400、401、402、服务器错误或超时等原因失败,139 个仍被协议判断拦住,其中 73 个返回了格式有问题的 JSON-RPC 错误体。
我的判断
这篇复盘最有价值的地方,是同时提供了错误响应、生产统计和修复后的读取结果。它足以说明:他们原先的兼容条件确实拦住了大量可读取服务器。
但不能据此把「401、403 就回退」写成所有请求通用的规则。这里的前提是首次协议探测、只读取工具列表,并且只回退一次。带凭证、执行工具或产生写入的客户端,还需要结合自己的权限与协议要求判断。
相比始终使用旧协议,这次修复保留了探测新版的机会;相比无限放宽回退,它也保留了明确的停止条件。不过作者没有给出安全对照实验,无法据此证明这套边界对所有 MCP 客户端都最合适。
独立日志同样是补充手段。固定样本每天读取一次,无法覆盖全量和所有短时故障。作者已经把双向比对自动化到每周快照之后,却仍未补上每日成功覆盖数量告警,这项缺口尚未关闭。
原文还有一处口径不一致:时间线图片写着当天 18:05 已恢复 1,894 个,正文却写次日 04:21 恢复 1,893 个。原文没有解释,精确恢复进度应保留疑问。
能拿来做什么
- 如果你维护 Node MCP 客户端,把文中的不同
id、401/403 和旧版本列表响应做成兼容性测试样例,明确验证首次探测何时允许回退。 - 如果你维护带重试退避的采集任务,同时记录请求成功率、成功覆盖对象数和距上次成功的时间,让长期失败对象继续出现在监控里。
- 如果你的 AI 编程工具依赖多个 MCP 服务,在升级协议前保留一组真实旧服务做回归,并用实现不同的读取器抽样比对工具列表,及时发现单一路径的盲区。