从近万条反馈提炼 Claude Code 约束
作者筛选 Claude Code 问题追踪器中近万条相关反馈,按行为聚类和反应数排序,选出 20 类可通过 CLAUDE.md 规则干预的问题。材料涵盖破坏性 Git 操作、规划模式误改文件和命令误用,并提供可复现的采集分析脚本。
AI 深度解读
「别加注释」「用 pnpm」「别再道歉」:反复给 Claude Code 纠偏,往往只修正了当前会话。nomore 项目的作者想把这些重复提醒整理成可复用的 CLAUDE.md 规则,于是分析了近 10,000 条 issue,人工选出 20 条行为规则。
这份清单值得参考,但它更接近「哪些抱怨获得了最多共鸣」,还不能证明哪些规则最有效。对程序员更有用的,是它展示了怎样从公开反馈和自己的对话记录里,提炼出值得长期保留的约束。
近万条 issue,最后筛出了什么
作者抓取了 anthropics/claude-code 中标有 area:model 或 data-loss 的 issue,排除拉取请求、重复报告和已撤回报告,再按相似标题分组,以每条 issue 的 1 + reactions 为权重给分组排序。
接下来还有两道筛选:只使用仍然开放或以 not planned 关闭的 issue,并由人工挑出 CLAUDE.md 规则确实可能改变的行为,最终留下 20 条。抓取和挖掘脚本放在仓库中,作者称统计数字可以复现。
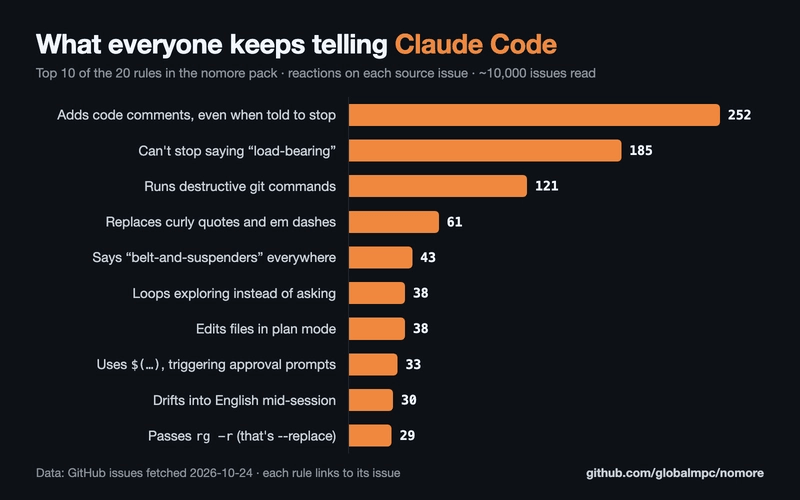
这里必须保留作者自己的限定:目前每条规则只对应一个 issue,所以所谓「报告最多」,实际更接近「获得回应最多」。
近万条是分析范围,不是每条规则都得到了近万条反馈的支持。
回应数能反映共鸣,却不能直接代表发生频率,更不能证明写入规则后问题就会消失。原文也没有逐条展示这 20 条规则的效果。
Claude Code 写了大部分代码,筛选仍靠人把关
这套工具本身也是用 Claude Code 做出来的:35 次提交中,33 次的代码由它编写,覆盖通过 gh CLI 抓取 issue、清理标题、相似度分组、排序,以及 125 个测试。
作者给项目配置了 CLAUDE.md,要求完成前运行测试,每次修复缺陷都补回归测试,同时逐步审查产出。
但有测试,不等于分析结果就合理。第一次分组时,Claude Code 选择的阈值把 1,489 条 issue 塞进同一组。作者从输出中发现异常,收紧阈值后,最大分组降到了 24 条。最终选择哪些规则,也由人决定。
这段经历比提交占比更有参考价值:处理文本归类任务时,除了检查程序能否运行,还要检查结果是否符合常识。原文没有说明那 125 个测试具体覆盖什么,不能据此认定分组质量已经得到充分验证。
公共规则之外,自己的重复提醒更有价值
nomore 免费提供,采用 MIT 许可证。下面的命令把公共规则下载为本地文件:
curl -fsSL https://raw.githubusercontent.com/globalmpc/nomore/main/rules/CLAUDE.md -o nomore-rules.md
要注意末尾的 -o nomore-rules.md:它只保存文件。之后还要在项目的 CLAUDE.md 中加入 @nomore-rules.md;按作者的说明,也可以把两个文件都放进 ~/.claude/,供所有项目使用。
项目还提供了一个处于 preview 阶段的本地 CLI。它在本机读取 Claude Code 对话记录,不联网,把重复纠正整理成候选规则,再交给用户选择。
作者在自己的会话里发现,多数重复内容其实是「commit」「continue」这类任务指令,而非长期偏好。因此,工具只展示一个短列表,不会把所有重复表达都自动写成规则。
重复出现,只能说明值得检查,不能直接说明应该长期执行。
我的判断
我认可「从真实纠正里提炼规则」这个方向。相比凭空写一大份提示词,它至少有明确的问题来源,也方便追溯某条约束为什么存在。
但公共清单适合当候选库。比如「用 pnpm」取决于项目,「别加注释」也不能覆盖所有维护需求。放到全局之前,需要确认它是否适用于每个仓库。
还要区分两类证据:作者展示了工具如何构建、如何纠正分组错误,却没有提供规则启用前后的对照数据。125 个测试验证的是工具代码的某些行为,不能替代对规则效果的验证。因此,「这些规则能减少多少返工」目前仍是经验之谈。
原文也没说清本地 CLI 如何区分任务、偏好和临时纠正。让人最后选择,是合理的保留步骤。
能拿来做什么
- 检查最近的 Claude Code 对话,把反复出现的纠正分成项目约束和临时任务,只将稳定约束写进 CLAUDE.md。
- 对前端或 Node 仓库,把实际使用的包管理器和验证命令写清楚;像「用 pnpm」这样的要求,应先放在对应项目中。
- 引入公共规则时,先阅读并选择适用条目,再观察同类任务中是否减少了重复纠正,别把回应数当成效果保证。
- 用 AI 编写抓取、分类或分析脚本时,除了运行测试,也抽查原始输入与最终分组,尤其检查异常大的分组。