用 Temporal 让本地 Agent 崩溃后续跑
Undead Agent 使用 Ollama 运行 Gemma,逐个汇总文本文件并生成报告,将执行步骤交给 Temporal 持久化工作流管理。进程遭 SIGKILL 后,新进程可接管任务,保留已完成步骤,并通过面板展示终止与恢复记录。
AI 深度解读
把 AI Agent 的进程强制杀掉,它还能接着处理文件,已经完成的模型调用也不用重跑。Undead Agent 做了这样一个演示:Gemma 负责生成摘要,Temporal 保存执行进度,进程死后由新 worker 接手。
它最有价值的地方,是把「模型负责什么」和「任务如何活下来」分开了。对写过批量处理脚本、长任务服务的程序员来说,这个项目提供了一种可以借鉴的实现方式。不过,「从死亡处继续」有边界,重试也不等于恢复模型的思考现场。
进程可以丢,已经完成的工作怎么保住
Undead Agent 的任务很简单:读取目录中的文本文件,逐个生成摘要,再把摘要合成报告。作者选择这个场景,是因为长任务很容易遇到休眠、内存不足导致的进程终止,以及部署重启。普通脚本如果只把进度保存在内存里,执行到第 9 步崩溃,重启后就可能从头再来。
项目把这些操作放进 Temporal 的持久化工作流(durable workflow)。大白话解释,就是由独立的执行系统记住哪些步骤成功了,以及成功时返回了什么。
下面这段代码定义了完整的任务顺序:
export async function undeadAgent(dir: string): Promise<string> {
  const files = await listFiles(dir);
  const summaries: string[] = [];
  for (const f of files) {
    summaries.push(await summarizeFile(f));
  }
  return writeReport(summaries);
}
要看的是 summaries.push(await summarizeFile(f)):每个文件作为独立 activity 执行,已完成 activity 的结果会记录在 Temporal 历史里。这里能恢复,依赖的是 Temporal 的执行机制,普通 JavaScript 函数里的 await 没有这种能力。
新 worker 接手后,会重放工作流,通过历史结果重建 summaries 数组,再继续未完成的步骤。数组没有直接跨进程存活,构建它所需的结果被保留了。
恢复的是任务进度,正在生成的那一次模型回答仍可能需要重做。
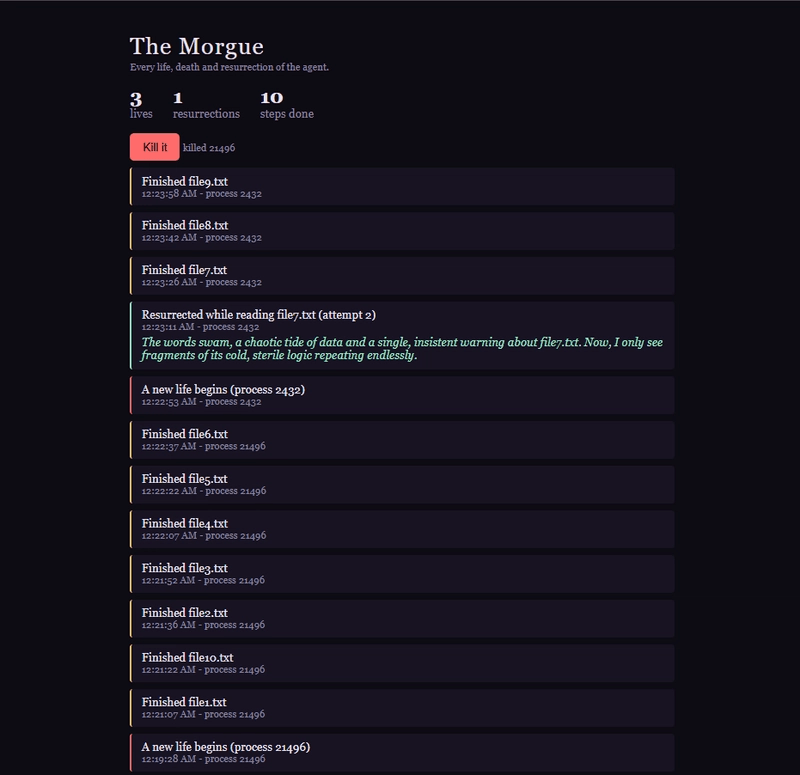
作者提供了一次真实运行的事件记录:12:22:37,worker 21496 完成 file6.txt,即将处理 file7.txt;随后进程被杀。12:22:53,新 worker 2432 启动;12:23:11,file7.txt 进入 attempt 2;12:23:26,该文件处理完成,之后继续处理文件 8、9。
这次记录里,文件 1 到 6 没有重做。它证明的是这条文件摘要流程能够恢复,不能据此推导所有 Agent 任务都能无损重试。
「复活」靠超时和重试,「鬼魂」靠一次新提示
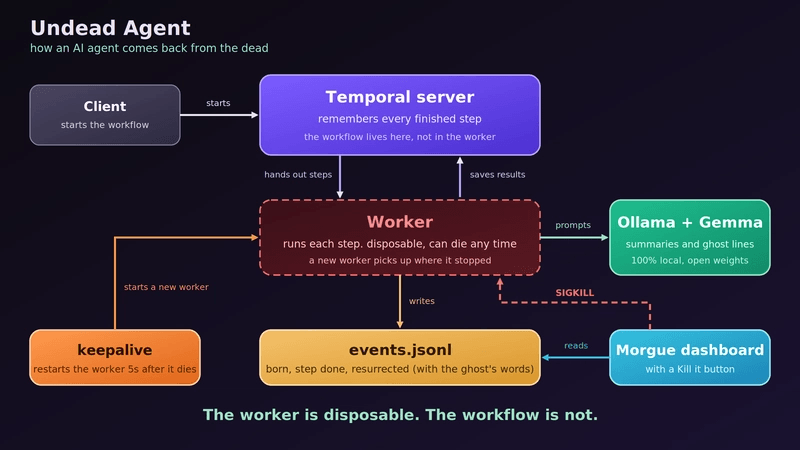
面板上的 Kill it 按钮发送的是 SIGKILL,worker 没机会收尾。作者最初用 Ctrl+C 测试,但当时 worker 会等待当前步骤完成,因此没有真正验证执行中断的恢复。
负责启动进程的是 keepalive.ts。它在子进程退出后,通过 setTimeout(start, 5000) 等待 5 秒,再执行 npx tsx src/worker.ts。新进程启动,不代表中断的步骤立刻重试:Temporal 还要等待原 activity 超时,文中说重启后可能再等待最多 30 秒。
「鬼魂知道自己死过」也有一个明确机制:读取 Context.current().info.attempt,当 attempt > 1 时,再调用模型,让它围绕当前文件生成两句阴森的旁白,并要求不使用 emoji。
这里需要拆开两件事。attempt 大于 1 表示发生了重试;在作者刻意杀进程的演示里,它对应一次复活。但重试也可能来自其他失败,不能单靠这个计数确认进程曾被杀。旁白同样是新生成的文本,没有证据表明模型保留了中断前的内部状态。
每个步骤还向 events.jsonl 追加事件,包括 born、step done 和 resurrected,面板读取这些记录,展示生命周期。公开页面由 Render 托管,播放的是一次真实运行的录像,真实 Agent 在作者本地运行。
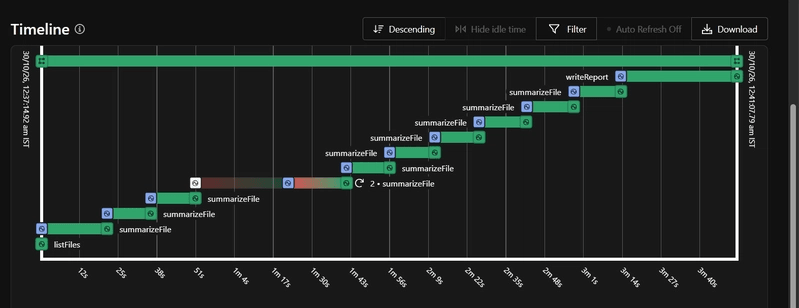
作者还踩中了一个很实际的坑:最初所有步骤统一设置 30 秒超时,单文件摘要能完成,最终报告却连续超时四次,直到 attempt 5 才成功。后来他把报告步骤单独调整为 120 秒。
短超时让演示恢复得更快,也可能误伤正常的慢请求。超时配置必须跟步骤的实际耗时一起考虑。
本地模型降低了调用门槛,但可靠性由工作流提供
项目默认使用 Ollama 中的 gemma3:4b,模型名称通过一个环境变量配置。Gemma 承担两个任务:生成文件摘要,以及撰写复活旁白。
下面是它调用模型的方式:
async function ask(prompt: string): Promise<string> {
  const res = await fetch('http://localhost:11434/api/generate', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ model: MODEL, prompt, stream: false }),
  });
  if (!res.ok) throw new Error(`Ollama error ${res.status}`);
  const data = (await res.json()) as { response: string };
  return data.response.trim();
}
关键是 stream: false:函数等待完整响应后,才返回 data.response.trim()。这段实现没有保存生成到一半的 token;请求中断后,未完成 activity 会重新执行。
作者看重本地部署的几个好处:不需要 API key,不向托管模型发请求,没有按 token 计费,反复测试重试时只消耗本机资源。文件内容也可以留在本机的处理链路里。严格说,「文件不离开磁盘」并不准确,内容仍会被读取并交给本地模型。
模型与工作流分开,也便于调整 Gemma 的规格,而不改任务编排。但文章没有给摘要质量、运行速度或硬件需求的对照数据。它验证了恢复机制,没有验证默认模型适合哪些文档。
我的判断
我认可这个项目的工程取舍:把完成记录交给进程之外的系统保存,让 worker 可以被替换。作者用 SIGKILL 和 Temporal 时间线展示恢复过程,比只展示一次顺利跑完更有说服力。
但原文的「不丢失任何东西」说得太满。演示覆盖的是 worker 死亡,没有证明 Temporal 服务、历史存储或整台机器故障后会怎样。原文也没有说明输入文件在重试期间发生变化时如何处理。
还有一个关键边界:activity 可能已经产生效果,却没来得及记录成功。对于摘要计算,后果通常是多算一次;如果任务扩展到写文件、发通知或调用外部接口,就需要考虑幂等,也就是重复执行时避免重复产生效果。这个项目没有给出这些场景的验证。
已完成步骤可以跳过,不代表每个外部操作都只会发生一次。
和自行保存 JSON 进度相比,Temporal 把历史、重放、超时和重试集中管理,也增加了服务运行与配置工作。作者自己承认,大部分时间花在周边工程和可视化上。对于短脚本,记录完成文件列表可能已经够用;对于频繁中断、需要查失败原因的长任务,这种投入才更容易体现价值。文章没有给两种方案的成本对照,这部分应当视为经验判断。
能拿来做什么
- 做 Node 批量文档摘要时,可以按文件划分步骤,保存每份摘要的完成结果,再执行最终汇总。这样一次中断不会迫使整批重跑。
- 为日常 AI 编程任务加入故障演练:在执行中发送
SIGKILL,检查已完成步骤是否重复、未完成步骤能否恢复,以及最终产物是否完整。 - 给文件处理和报告生成分别设置超时。原文的 30 秒与 120 秒可以作为理解差异的案例,实际配置仍要根据模型和输入耗时确定。
- 想复现时,先安装 Ollama 并拉取 Gemma,安装 Temporal CLI 后执行
temporal server start-dev;使用git clone https://github.com/Khushighosh/undead-agent && cd undead-agent && npm install获取项目,在docs/放入.txt文件,再分别运行npx tsx src/keepalive.ts、npx tsx src/dashboard.ts和npx tsx src/client.ts,打开http://localhost:3000测试Kill it。