用日志与 GA4 识别 AI 来源流量
文章结合来源域名和 UTM 参数识别 AI 引荐流量,提供 GA4 正则、Express/Next.js 中间件及 SQL 报表方案。也说明无来源信息的访问和 Google 内部 AI 搜索点击造成的归因盲区。
AI 深度解读
「ChatGPT 给网站带来了多少流量?」看起来查一下统计后台就能回答,实际更诚实的答案是:至少有这些,还有一部分无法确认。用户从 AI 回答里点击链接,可能带着来源域名,也可能只有 UTM 参数,甚至什么标记都没有。
作者给出的办法,是把来源分类、GA4 渠道规则和服务端日志接起来,再用间接证据观察无法归因的部分。它的价值在于建立一套能解释、能维护的统计口径,同时承认:点击能统计到哪里,结论就只能说到哪里。
先分清四种流量,才知道数字漏在哪里
原文把 AI 带来的访问分成四种:带 Referrer、带 UTM、没有来源标记,以及发生在 Google 搜索内部的 AI 导流。前两种可以按规则识别,第三种被作者称为「Dark AI」,第四种则混在 Google 搜索流量里。
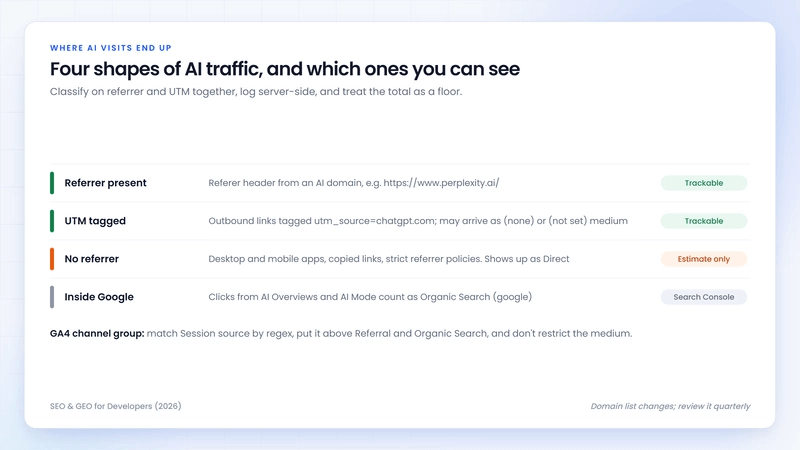
Referrer 是浏览器随请求携带的来源信息,UTM 是链接上的营销归因参数。两者都缺失时,统计系统没有足够证据判断用户是不是从 AI 助手过来的,访问往往会落入 Direct。
服务端能补上部分被拦截的统计,却不能凭空恢复已经丢失的来源。
原文还提到,Search Console 在 2026 年向所有网站推出了生成式 AI 表现报告。但正文没有提供官方依据,这个产品状态不能仅凭原文确认。实际落地时,需要另行核实,不能把它直接当作现成的数据入口。
作者建议先做一个共用分类器:AI_SOURCES 保存域名和 UTM 值,classifyAI({ referrer, url }) 返回来源名称,以及 referrer 或 utm 识别方式。覆盖对象包括 ChatGPT、Perplexity、Claude、Gemini、Copilot、DeepSeek、Meta AI 和 Grok。
这套设计最有用的地方是统一口径。前端、服务端和 SQL 报表应当共用同一份规则配置,避免各自维护一套名单。Gemini 曾使用 Bard 域名,Copilot 也更换过主机名,因此作者建议每季度检查一次,把名单作为配置维护。
GA4 最容易漏算的,是渠道条件写得太窄
作者没有确认 GA4 内置 AI 渠道究竟覆盖哪些来源,因此建议建立自己控制的渠道组。操作路径是:
Admin → Data display → Channel groups → Create new channel group → Add new channel,命名为 AI Assistants。
匹配条件选择 Session source · matches regex,下面这段同时覆盖域名来源与简短的 UTM 来源值:
^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|claude\.ai|gemini\.google\.com|bard\.google\.com|copilot\.microsoft\.com|copilot\.cloud\.microsoft|chat\.deepseek\.com|meta\.ai|grok\.com)$|^(chatgpt|perplexity|claude|gemini|copilot|deepseek|grok)$
要看的是后半段:只匹配域名,会漏掉 chatgpt、claude 等 utm_source 值。
另外两个设置会直接影响结果。第一,不要追加 medium = referral 条件,因为带 UTM 的访问可能表现为 chatgpt.com / (none) 或 (not set)。来源认出来了,再拿 medium 卡一道,反而会丢掉它。
第二,把 AI Assistants 放在 Referral 和 Organic Search 前面。GA4 从上到下匹配渠道,先命中的规则生效。作者还指出,自定义渠道组可以用于历史数据报表,方便回看往年变化,但它只能重新分类已有记录,补不回从未采集的访问。
服务端日志要回答「去了哪页」,还要明确统计单位
作者用 Express 中间件补充 GA4:只处理 GET 且接受 HTML 的请求,通过 req.get("referer") 和完整 URL 分类,再写入 ai_visits。字段包括时间、来源、识别方式、路径和 User-Agent;数据库写入不阻塞页面请求。
对于 Next.js,原文采用结构化日志,把数据交给日志管道,或转发给 Route Handler。它解决的是中间件不方便直接写数据库的问题:
// middleware.ts
import { NextResponse, type NextRequest } from "next/server";
import { classifyAI } from "./lib/ai-referrers";

export function middleware(req: NextRequest) {
  const hit = classifyAI({ referrer: req.headers.get("referer") ?? "", url: req.url });
  if (hit) {
    // 输出结构化日志,通过日志管道收集。
    console.log(JSON.stringify({ type: "ai_visit", ...hit, path: req.nextUrl.pathname, ts: Date.now() }));
  }
  return NextResponse.next();
}

export const config = { matcher: ["/((?!_next|api|.*\\..*).*)"] };
要检查最后一行的 matcher:它排除了 _next、api 和带点号的路径,业务路由若包含点号,也可能被排除。原文没有说明 Next.js 版本和部署环境,接入前还需要确认项目的中间件约定及日志采集能力。
报表可以先做两张:用 date_trunc('week', ts) 按周统计来源;再查最近 30 days 的路径分布,按次数排序取 LIMIT 25。后者更接近内容决策:哪些文档、比较页、定价页在承接 AI 点击?
不过,作者给出的表只有请求记录,没有会话标识,也没有注册或订单关联键。它能统计命中次数;若要分析会话、用户和转化,还需要补充关联设计。原文也没有给出去重、预取请求或机器人过滤方案。
来源信息通常只能看到类似 https://chatgpt.com/ 的站点地址,无法据此知道具体对话或提示词。作者明确反对为此尝试指纹追踪。
我的判断
这篇最值得采用的是「可追踪访问下限」这个口径。没有 Referrer,也没有 UTM 的请求,无法靠补一段代码准确归因。
作者给了三种观察暗流量的办法:检查深层页面的 Direct 落地访问;比较它与已识别 AI 访问是否同步上涨;在注册问卷里增加「AI assistant」选项。例如最近 30 days 查询 Direct 落地页,排除 /、/login、/app,取前 25 条,就能找到值得调查的页面。
但深页 Direct 也可能来自聊天分享、邮件、书签或丢失参数的链接。同周上涨只能提供线索。作者关于 AI 更常导向深层文档、比较页和定价页的判断,没有给出样本与对照数据,应当视为经验之谈。
实现上还有一个边界:分类器按来源逐项循环,每项先检查 Referrer,再检查 UTM。如果两者指向不同助手,列表顺序可能决定结果,并非全局优先 Referrer。一般团队应先明确冲突规则。
相比只看 GA4,服务端日志更方便连接业务数据,但维护成本也更高。小站可以先做好渠道分类,确有转化分析需求再补日志。
作者最后推荐了自家 Vista AI 品牌可见性看板,用提示词采样观察被提及的情况。点击与提及确实是两个维度,但原文没有披露采样范围和代表性。提及上涨、点击持平,可以提出调查问题,还不足以断定「被提及却没有链接」。
能拿来做什么
- 先给 GA4 增加
AI Assistants渠道,检查正则、渠道顺序和 medium 限制,并记录规则维护日期。 - 在 Node 或 Next.js 项目里复用分类配置,记录来源、识别方式和落地路径;需要关联注册、订单时,再设计会话与转化关联键。
- 每周查看最近 30 天承接 AI 点击最多的 25 个页面,检查内容是否准确、示例是否可用、下一步入口是否清楚。
- 把已识别访问和深页 Direct 分开报告,用注册问卷补充证据,不给无法归因的部分随意乘上一个估算系数。