让前端编程 Agent 持续工作的五种方法
文章用 Kiro Crew 演示定时任务、记忆、子代理、工作流和机器人五种模式,减少开发者逐轮提示和等待的操作。部分模式也适用于 Claude Code、Codex 和 OpenClaw,作者披露其 AWS 开发者布道师身份。
AI 深度解读
想让 AI 写完一个功能,开发者往往还得守着它:补上下文、催下一步、检查结果。原文作者尝试把这套协作变成能持续运行的流程,给出五种做法:定时任务、记忆、子代理、工作流,以及负责固定领域的 Bot。
它值得看的地方,是把「少盯着 AI」拆成了可配置的机制。不过,文章以 Kiro Crew 和 Kiro IDE 为例,作者也是 AWS 的 Developer Advocate,Kiro 属于 AWS。文中的功能演示可以参考,关于效率和可靠性的结论则需要分开看。
先让任务按时启动,再让偏好跨会话保留
定时任务解决的是「谁来发起下一次工作」。
Kiro Crew 通过 Gateway 运行,可以部署在 VPS、Mac mini 或笔记本上。每个任务由提示词、cron 表达式和时区组成。作者实际展示了两个任务:每天早上 7 点搜集前端与全栈新闻,每周一早上 9 点寻找可以投稿的会议征稿机会,时区都是 America/Los_Angeles。
新闻任务的 cron 是 0 7 * * *。编辑页还有 Run Now,可以先验证提示词和输出,再交给定时器。
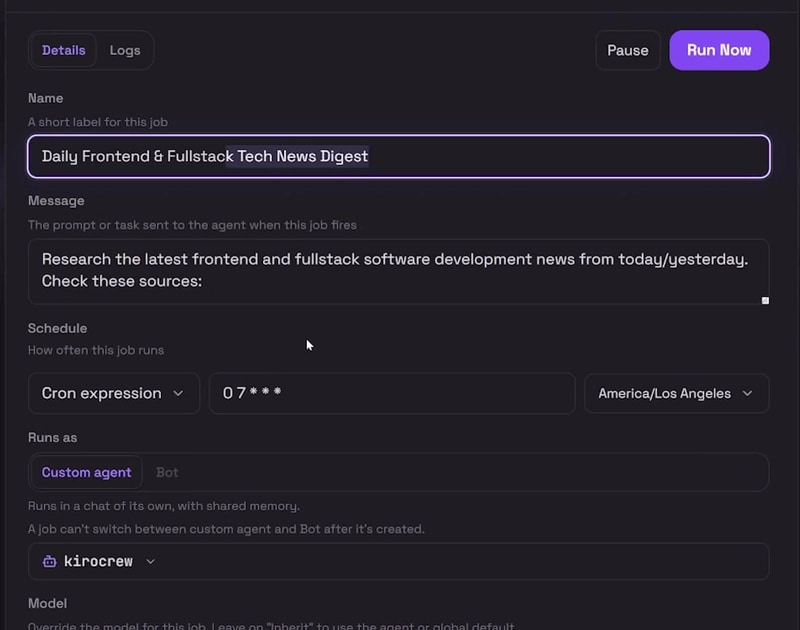
作者还提出一种前端用法:每天运行 Lighthouse,发送报告,或者提交修复 PR。也可以直接在聊天里要求「每晚 2 点检查 /pricing,告诉我哪些指标下降了」,由代理创建任务。
这里要分清:新闻和征稿任务是作者正在运行的实例,自动检查 Lighthouse、提交修复 PR 是文中建议的应用方式,没有展示持续运行后的效果。
记忆解决的则是「下一次还要不要重新解释」。
Kiro Crew 把记忆保存在 ~/.kiro/crew/workspace/memory,使用普通 Markdown 文件记录偏好和项目情况,需要时放进上下文。作者偏爱 Vue.js,代理因此会优先选择 Vue.js 或 Nuxt;缩进习惯、是否使用 Options API,也可以通过聊天要求记住。
Kiro IDE 提供四种模式:Use and learn、Use but don't learn、Use only、Off,默认是 Off。原文没有解释中间两种模式的具体差别,不能仅凭名称推断。
作者使用 Use and learn,支持按项目或全局学习。他展示了一条创建于 21 天前的全局记忆:画图时直接产出成品,不再反复询问设置;连用 headless Chrome 渲染 PNG 的工具绕行办法也一起保存了。Kiro Crew 有时还会把学到的内容转成 skill。
定时任务省掉重复发起,记忆省掉重复交代,但两者都没有自动解决结果是否正确的问题。
子代理负责并行,工作流负责把结果接起来
遇到互不依赖的任务,可以让子代理(subagent)分别处理。作者建议明确提出要求,因为有些工具虽然会自动拆分,但表现并不稳定;涉及代码修改时,必要时配合 worktrees。
他的新闻搜集任务拆成三路:市场与大型科技公司、AI 发布、开发者新闻。最后一路包含 Hacker News 讨论,以及 Vue、Nuxt、Vite 的发布信息,主代理再汇总结果。
这次演示显示:3 个子代理,35 秒,1.73 credits,界面标注模型为 claude-opus-5.5。作者也提到 Claude Opus 5.5 擅长拆解任务,但没有给出系统评测。
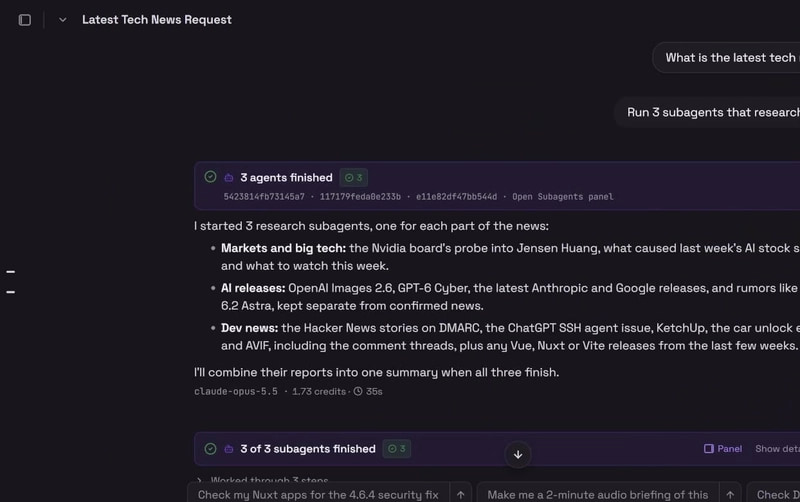
每个子代理拥有独立上下文,可以减少主聊天被研究材料塞满的情况。相比打开 10 个终端各跑一个代理,集中查看和汇总也更方便。不过,上下文独立不等于文件修改互不冲突,编码任务仍需明确工作边界。
工作流进一步解决「先后顺序、检查和返工」的问题。用迁移任务举例,调查、设计、实施、审查可以组成一套重复执行的流程,每一步再按需要分派代理。
Kiro IDE 的 feature-pipeline 配方包含 setup、requirements、design-loop、plan、code-loop、validate-gate 六步。其中:
design-loop包含design-draft和design-review,最多运行两轮。code-loop包含implement、并行审查的review-fable和review-gpt,再由code-aggregate汇总,最多运行两轮。
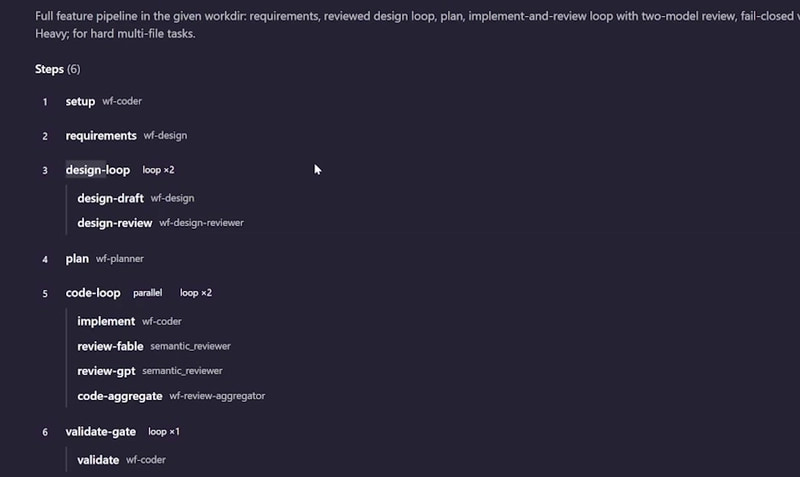
这些配方以文件保存,可以打开修改。另一个 ralph 配方让一个编码代理逐项处理 JSON 清单,每轮处理一项,最多运行 200 次,直到清单完成。
这里最有用的变化,是把「做完以后检查一下」变成明确步骤。至于审查能发现多少缺陷、循环是否值得消耗,原文没有对照数据。
Bot 把一次任务变成持续负责的领域
Bot 把前面的机制组合起来:拥有自己的记忆、定时运行、调用子代理,并围绕目标持续工作。Kiro Crew 把 Bot 的子代理称为 workers。
作者创建了一个叫 A11y 的无障碍 Bot。它的 Heartbeat 可以每小时唤醒一次,主动寻找工作;文中给出的目标示例是让 Lighthouse 分数保持在 90 以上。
Heartbeat 默认关闭,Bot 有目标后才能启用,可选间隔为 30 分钟到 4 小时。设置目标后,Bot 会提出里程碑,由用户确认;还可以开启每日、每周或每月汇报,并通过聊天生成仪表盘,展示当前工作和下一步。
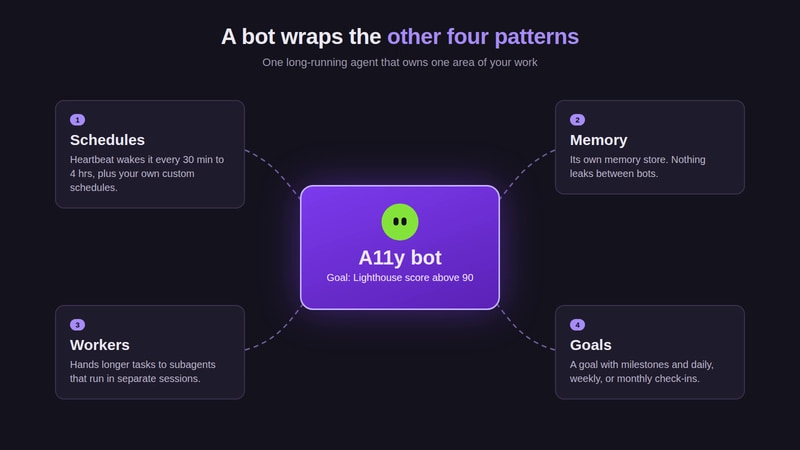
但这段展示有个边界:截图中的目标、里程碑和仪表盘仍为空。它说明了如何配置,不能证明 Bot 已经长期守住质量指标。
成本同样需要单独考虑。每次 Heartbeat 唤醒、每个 worker、每次定时运行都会消耗 credits。即使一次醒来没有找到值得修改的问题,唤醒本身也有成本。
Bot 的价值取决于它能否持续发现有价值的工作,而不只是能否持续运行。
我的判断
作者说对的一点,是把代理使用从「怎样写提示词」推进到了「怎样组织工作」。固定触发条件、保留偏好、拆分任务、加入检查,这些机制比每次临时追问更容易复用。
但「可以走开」和「回来就能验收」之间,还有一段距离。原文唯一具体的耗时与费用记录,是新闻研究的 35 秒、1.73 credits;它没有串行对照,也没有验证新闻覆盖率、代码正确率或长期维护成本。这些目前属于个人使用经验。
对于前端团队,Lighthouse 也需要明确测量页面、运行环境,以及究竟关注性能还是无障碍分项。一个总目标不能替代验收标准,分数超过 90 也不能直接证明所有无障碍问题已经解决。
常见替代方案仍然有位置。固定的 Lighthouse 检查可以交给 CI 或 cron 执行脚本,合并后检查可以由事件触发。AI 更适合参与解释问题、整理报告和提出修复方案;确定性步骤交给脚本,通常更容易复现。
全局记忆也要克制。个人偏爱 Vue,不代表团队每个仓库都该选 Vue。个人习惯、项目约束和可复用经验,适用范围不同,不能靠「记住了」就混在一起。
能拿来做什么
- 从一个只生成报告的定时任务开始,例如固定检查
/pricing。先用Run Now验证页面、输出和时区,再决定是否开放自动提交 PR。 - 把反复解释的偏好写入记忆,同时标明项目范围。涉及团队技术选型时,优先让仓库内明确的约定作为依据。
- 对互不依赖的资料研究明确要求使用子代理,并规定每路交付内容。代码任务则先划定修改范围,必要时使用 worktrees。
- 对重复迁移建立包含实施、审查和校验的工作流。只有确实需要持续维护某个领域时,再引入 Bot,并从较长的 Heartbeat 间隔开始观察成本。