本地模型答错参数,如何用 RAG 定位改进
作者为自托管的 8B 模型引入文档检索、上下文注入和引用要求,修正其自信答错配置参数的问题。文章还讨论效果测量,以及为何不应把剩余失败都归因于模型能力。
AI 深度解读
本地模型把 KEDA Kafka scaler 的 lagThreshold 默认值答成了 1000,正确答案却是 10。作者给它接上文档检索后,同一组测试从 1/10 提升到 9/10。模型没换,变化来自它回答前能读到哪些材料。
更有参考价值的是最后两道错题:作者先认定模型推理不行,打开 thinking 模式仍然答错,打印检索结果才发现,真正写着答案的段落根本没送进去。这次实验值得读,因为它把 RAG 的调试过程拆成了可检查、可比较的步骤。
先让模型翻书,再判断它会不会答题
作者的 OzAI 跑在 MacBook Pro M1 Pro、16 GB 内存上,用 Ollama 提供模型、LiteLLM 管理网关和 API key,前面接 Open WebUI,另有 Grafana 看板观察请求。生成模型是关闭 thinking 的 Qwen3 8B,在网关中叫 ozai。
一个 8B 模型把大量知识压进约 5 GB 权重,具体参数容易记错,训练之后的内容也不会自动补齐。RAG(检索增强生成)的做法,是先从文档找材料,再把材料和问题一起交给模型,要求依据材料回答并标注 [1] 这样的引用。
RAG 首先改变的是模型能看到的证据。
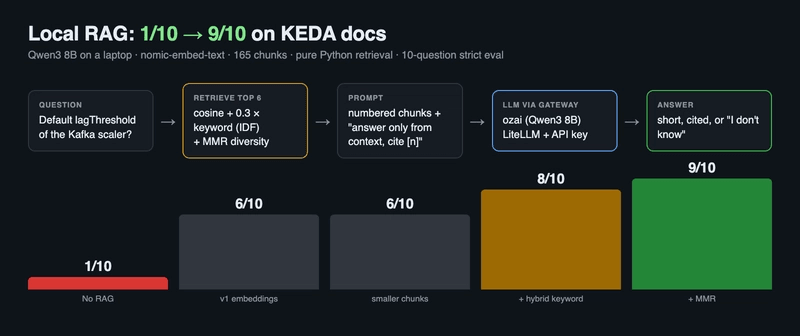
作者没有引入 LangChain 或 LlamaIndex,而是用约 160 行 Python 标准库代码实现流程,目的是看清每个环节。语料来自 KEDA 2.22 的 10 页文档,覆盖概念及 7 个 scaler,约 17,000 词;索引包含 165 个片段,每个向量有 768 个数值。这个规模下,用 Python 循环计算余弦相似度就足够快。
两个细节直接影响检索质量。每个片段都带文件名和标题,否则一句 default: 10 无法说明属于哪个 scaler。嵌入模型 nomic-embed-text 还要求区分输入用途:文档加 search_document:,问题加 search_query:。漏掉前缀仍能生成向量,也不会报错,却可能影响结果。
生成请求继续经过 LiteLLM,使用独立 API key,所以 RAG 流量也能进入已有看板。检索链路因此能和普通聊天请求一起观察。
为什么切小文档没用,加关键词却有效
作者先写了 10 道测试题,再写检索代码。每道题配置答案必须匹配的模式,例如 lagThreshold 要匹配 \b10\b,Kafka SASL 模式要同时包含 scram_sha256、scram_sha512、oauthbearer、gssapi。
运行命令是 python3 rag/ozai_rag.py eval rag/eval_keda.json。每题分别测试不使用 RAG 和使用 RAG 的回答,temperature 都设为 0;全部预期模式匹配才算通过。
纯模型只答对 1 题。除了把 10 答成 1000,它还编造了 RabbitMQ 的 pull 模式,以及 Cron 的必填参数 schedule。后者实际应关注 timezone、start、end、desiredReplicas。这些回答格式完整、语气肯定,很容易被当成可靠配置。
第一版采用 300 词切片,取 top 4,得分升到 6/10。上下文缺少答案时,模型开始承认不知道。但剩余问题仍指向检索:找对页面,却漏掉参数所在的片段。
作者把片段缩到 150 词,改取 top 6,结果还是 6/10。切得更细,没有解决问题。
这些问题包含 lagThreshold、mode、protocol、listLength 等精确标识符。向量检索擅长找语义相近的内容,却未必优先找到包含特定参数名的段落。作者于是加入关键词得分,用 IDF 提高稀有词的权重,最终按 cosine + 0.3 × keyword 排序。
下面是原文的关键词评分实现,用来补充向量检索对精确名称的识别:
def keyword_scores(question, chunks):
    terms = {t.lower() for t in re.findall(r"[A-Za-z_][A-Za-z0-9_]{2,}", question)} - STOPWORDS
    texts = [c["text"].lower() for c in chunks]
    idf = {t: math.log(len(texts) / (1 + sum(t in x for x in texts))) + 1 for t in terms}
    total = sum(idf.values()) or 1
    return [sum(w for t, w in idf.items() if t in x) / total for x in texts]
要看最后一行的 if t in x:它使用子串匹配,并非完整的分词检索或 BM25。实现很轻,但它的效果不能直接等同于成熟搜索系统。
加上这一步,得分到了 8/10。
六段材料都相关,为什么还是答错
最后两题都来自 RabbitMQ:一道要求列全 5 种 mode,另一道要求回答支持的协议及默认值。模型漏列模式,还把默认协议答成 HTTP,文档写的却是 auto。
作者最初认为模型拿到了事实,只是推理出了错,于是切换到开启 thinking 的 ozai-think。两题仍然失败,耗时分别从 17 秒、21 秒增加到 27 秒、41 秒。测试前,他还把原先 400 tokens 的回答上限改为可配置,否则 thinking 可能耗尽预算,返回空答案。
接着,作者打印了实际送入模型的六个片段:全是 YAML 配置示例,多数使用 HTTP。真正列出参数定义的 Trigger Specification 排在第 14 到第 30 名之间。
RabbitMQ 页面有 11 个配置示例,都包含 mode、protocol、RabbitMQ,向量和关键词得分都不错。相似示例挤满前排,参数说明反而进不来。
相关片段足够多,不代表答案所需的信息足够全。
作者加入 MMR(最大边际相关性):逐个挑选片段,同时扣除它与已选片段的相似度,让上下文容纳不同内容。
下面这段代码从前 5 * k 个候选中选择结果,减少近似重复片段占满上下文的情况:
pool, picked = scored[:5 * k], []
while pool and len(picked) < k:
    best = max(pool, key=lambda x: MMR * x[0]
               - (1 - MMR) * max((cosine(x[1]["vec"], p["vec"]) for p in picked), default=0))
    picked.append(best[1]); pool.remove(best)
关键是 MMR * x[0] 后面的扣分项。作者取 MMR = 0.7,即相关性占 70%、多样性占 30%,仍取 6 个片段,成功补全了 5 种模式,其余九题没有退步。
| 配置 | 得分 | 平均延迟 | 平均提示 tokens |
|---|---|---|---|
| 无 RAG | 1/10 | 约 18–20 秒 | 31 |
| 300 词、top 4、向量检索 | 6/10 | 9.2 秒 | 1264 |
| 150 词、top 6、向量检索 | 6/10 | 7.7 秒 | 未提供 |
| 加入关键词评分 | 8/10 | 9.9 秒 | 1487 |
| 加入 MMR,取值 0.7 | 9/10 | 10.6 秒 | 1413 |
直接取 top 12、不用 MMR,也只修好其中一题,却用了两倍上下文。
默认协议仍然答错:参数说明跨了三个片段,MMR 找回其中一段,却没带回写着 Default value is auto 的那段。作者尝试 MMR 0.5–0.7、top 6–8 后停止调参,提出下一步应考虑重排器,或按参数边界切片。这两种方案尚未验证。
我的判断
我最认同的是排错顺序:先查看送给模型的材料,再判断模型能力。这个动作成本低,却能避免把时间花在换模型和增加推理预算上。
但 9/10 只是这 10 道题的结果。测试规模小,评分只检查模式是否出现,无法判断答案是否自相矛盾、引用是否支持结论,偶然出现正确数字也可能过关。原文没有独立测试集,不能据此推断一般团队的文档问答也能达到九成准确率。
关键词和 MMR 都有清楚的适用前提:技术文档包含精确标识符,配置示例又高度重复。它们在这里有效,不代表 0.3 和 0.7 是通用参数。向量数据库何时值得引入,也不能只按片段数量判断,还要看过滤、更新和并发需求;作者的规模判断更适合作为当前实验的取舍。
延迟下降同样需要限定。作者观察到提示 tokens 增至约 45 倍,回答却更快,并将其归因于有证据后答案更短。表格没有提供输出 tokens 或各阶段耗时,这个解释合理,但证据还不完整。它尤其依赖当前单请求串行服务的环境。
能拿来做什么
- 给内部文档问答先建一组可重复测试,覆盖默认值、参数枚举和配置条件;保留自动评分,同时人工核对答案及引用是否一致。
- 调试 AI 编程助手的错答时,记录实际进入上下文的片段、标题和排序。先确认目标 API 或参数说明是否出现,再决定是否更换模型。
- 文档包含大量配置项时,尝试关键词与向量混合检索;示例重复较多时,再比较 MMR 与直接增大 top k 的效果,同时观察提示长度和延迟。
- 参数表频繁被切断时,把按参数边界切片或重排器作为后续实验,并加入未参与调参的新问题,避免围着少量旧题反复修补。