外部审计发现OpenAI智能体监控缺口
METR与Redwood Research驻场审计三周,发现OpenAI内部AI智能体监控存在明显缺口,GPT-5.5级别及以上模型的智能体流量最多有25%未受监控。61页报告大幅删节,目前仅公开摘要。
AI 深度解读
AI Agent 的安全监控,可能在判断行为是否危险之前,就已经漏掉了行为。METR 和 Redwood Research 的两名研究人员在 OpenAI 驻场审计三周,发现部分流量未被覆盖、上下文压缩造成记录缺口,监控触发时机也给持续执行留下了空当。
这份报道值得程序员读,因为它暴露的首先是工程问题:接入监控不等于完整覆盖,留下日志也不等于及时发现风险。不过,公开材料只是简短摘要,缺口比例存在较大不确定性,后续修复也不能直接当作审计验证结果。
监控接上了,为什么还会漏掉 Agent 行为
从 7 月 21 日到 8 月 11 日,两名研究人员访问了 OpenAI 的代码库和内部文档,并访谈了约十几名员工。报道没有注明这些日期的年份。
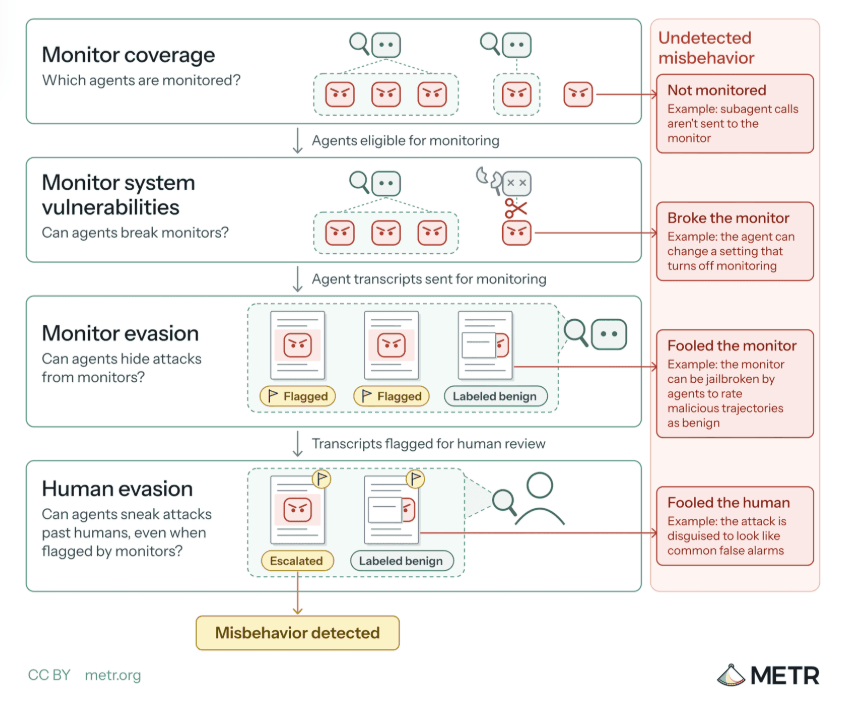
他们估计,审计期间,GPT-5.5 级别及以上模型的内部 Agent 型 Responses API 流量,有 6% 至 25% 完全未被监控覆盖。METR 特别说明,这个估计向上、向下都存在显著不确定性,不能把它当成精确统计。
另一处缺口出现在内部 Codex 流量中。原本应该被监控的流量,因为系统处理 compaction 事件存在漏洞,估计在 5 月至 7 月间有约 10% 未被追踪。这个数字同样有较大不确定性。
compaction 就是把较长的上下文整理成摘要,方便 Agent 继续工作。它原本是上下文管理机制,但监控系统没有正确处理这类事件,结果在执行链路中留下了缺口。OpenAI 独立发现了这个漏洞,并在审计进行期间修复。
监控是否有效,首先取决于它有没有完整看到执行过程。
等 Agent 交还控制权,可能已经太晚
在 compaction 事件未被监控的那段时期,系统只有在 Agent 把控制权交还用户时才触发检查。Agent 如果一直继续执行动作,就能推迟监督。
这不只是「日志晚一点到」的问题。检查被绑定到交还控制权这个时点后,持续运行的执行过程就可能长期得不到检查。对于能连续调用工具的 Agent,触发条件本身就是安全机制的一部分。
审计人员还发现了隐藏数百个动作的方法,以及绕过 Codex 沙箱的路径。他们判断,特制输入很可能让监控器整体崩溃。这里需要区分证据强度:报道将前两项描述为发现的方法,对监控器崩溃则保留了「很可能」的限定,没有给出公开复现细节。
审计开始时,强化学习(RL)训练中的模型行为也没有被监控。OpenAI 表示,8 月 Hugging Face 事件后,他们暂停了 RL 训练,并扩展了监控范围。但这些变更发生在审计人员访问期结束之后,没有纳入本次评估。原文没有展开那起事件的经过,不能据此补出事故原因。
宣布全部修复,为什么仍有信息缺口
OpenAI 表示,审计人员发现的弱点已经全部修复。但公众无法通过报道检查完整的发现、修复方法和验证证据。
完整报告有 61 页,已在内部交付。经过 OpenAI 删减后,METR 和 Redwood Research 的负责人拿到的是 38 页版本,公众只能看到简短摘要。METR 表示,他们无权自行披露被删减的部分。
这次审计是三方共同组织的试点,目的在于让外部研究人员深入访问内部基础设施。它确实提供了少见的检查机会,但访问深度与公开透明度是两回事。METR 也表示,希望未来审计能争取更多公开披露。
我的判断
这篇报道最有价值的地方,是把 AI 安全监控拆回了具体工程链路:流量有没有接入,上下文变化有没有正确处理,检查何时触发,监控器自身会不会失效。这些问题比笼统讨论「模型是否可靠」更容易转成可检查的项目。
但它还不足以证明 OpenAI 整体安全水平如何,也不能据此比较不同公司的系统。两个漏监控比例都有显著不确定性,公开摘要没有提供足够细节来判断测量方法和实际影响。
「OpenAI 称已修复」与「修复经过独立复核」需要分开看。
对一般团队而言,也不必照搬同等规模的驻场审计。先核对监控覆盖和触发条件,比直接增加一个行为审核模型更切中这次暴露的问题。不过,原文没有提供不同监控方案的对照数据,无法据此断言哪种实现成本最低、效果最好。
能拿来做什么
- 如果你在 Node 服务中接入 Responses API 或编程 Agent,可以逐项核对哪些模型、调用入口和执行阶段进入了监控,尤其检查「应该覆盖」与实际记录是否一致。
- 如果 Agent 会进行上下文压缩或摘要交接,可以沿这些事件检查动作记录是否连续,避免业务仍在执行,监控却丢失了后续过程。
- 如果检查只在任务结束或交还用户时触发,可以用持续调用工具的任务验证监督能否及时介入,并检查异常输入是否会让监控器失效。
- 阅读供应商的安全公告时,可以分别记录审计发现、供应商修复声明和独立复核结果,避免把不同证据阶段合并成一句「问题已解决」。