Inkling 2 Small开放权重,耗量成取舍
Thinking Machines发布5940亿参数的混合专家模型Inkling 2 Small,自称领先西方开放权重模型。其智能体能力有所提升,但token消耗也明显增加,性能排名仍需区分厂商宣称与独立验证。
AI 深度解读
Inkling 2 Small 的看点,是它把编程、多步骤任务和视觉能力往前推了一截,同时保持了相对低的评测任务成本。不过,「西方最强开放权重模型」这个说法得拆开看:成绩有比较范围,权重也还没有正式开放。
对前端和全栈开发者,更有用的是看清这些成绩怎么来的:它更擅长连续做事,却用了更多输出 token;幻觉率下降,也伴随着更少回答问题。这些取舍,比单看排行榜更接近实际选型。
编程成绩上涨,靠的是更长的任务训练
Thinking Machines 由前 OpenAI CTO Mira Murati 创立。其第二代模型 Inkling 2 Small 面向微调场景,适合作为专用应用的基础模型。它采用混合专家架构(MoE),总参数量为 5940 亿,每次计算激活其中 170 亿。它支持文本和图片输入,还能调整思考深度,在速度和处理充分程度之间取舍。
按 Thinking Machines 披露的数据,Inkling 2 Small 在 Artificial Analysis Intelligence Index 上得到 31 分,比前代 Inkling Small 的 13 分提高 18 分,大致追平 Gemini 3.8 Flash。
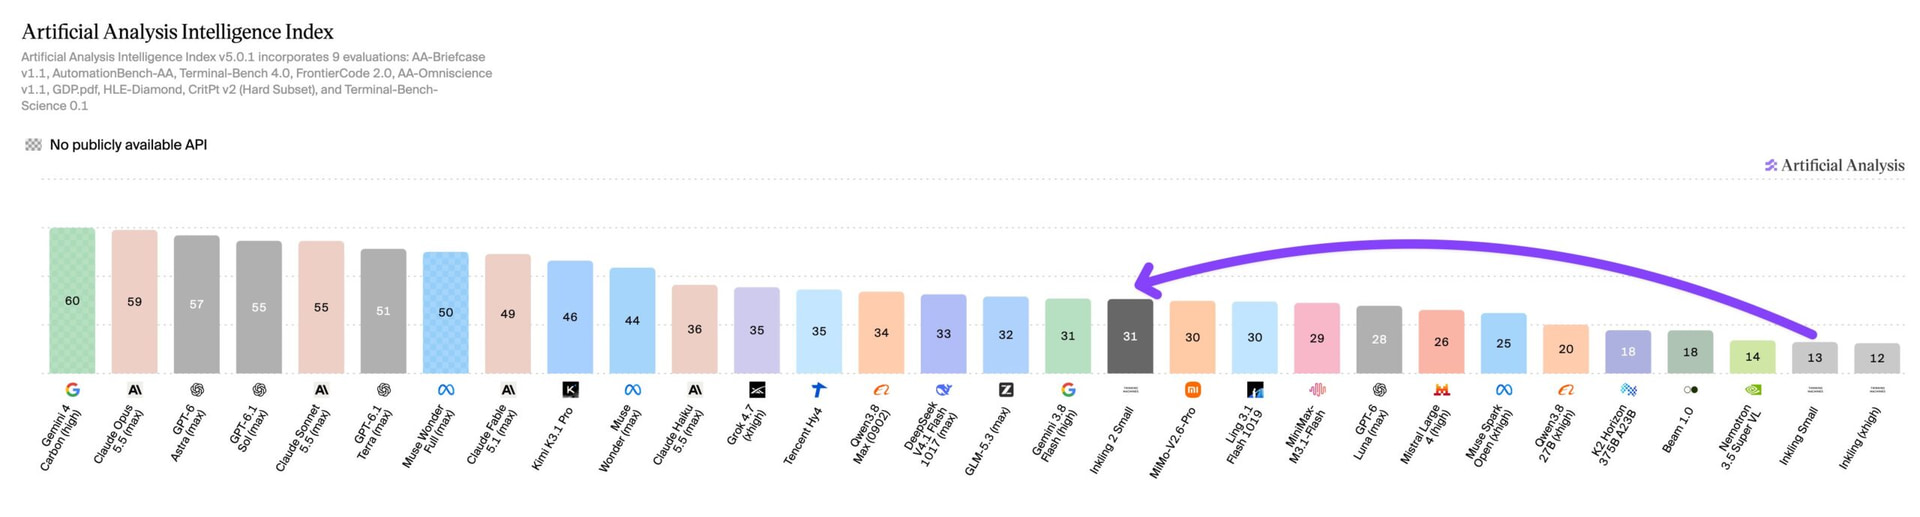
提升最明显的是智能体任务,即模型自己连续执行多个步骤的工作流。AutomationBench-AA 从 5% 升到 46%,FrontierCode 2.0 从约 5% 升到约 25%;知识工作评测 AA-Briefcase 达到 1,527 Elo,比前代高 615 分。
作者给出的训练解释是:他们团队用数十万个长周期编码任务做强化学习,再由自动评估系统检查代码能否工作,以及模型如何完成任务。训练目标因此不止是生成一段代码,还包括持续推进、检查结果和处理后续步骤。
更详细的成绩包括 FrontierCode 2.0 的 25.4%、DeepSWE v1.1 的 72.1%,以及 SWEBench Pro v2 (Hard) 的 86.3%。但它没有全面领先:DeepSeek V4.1 Flash 在前两项分别达到 28.5% 和 77%,Kimi K3 在后一项略胜,比较中也没有更新的 Kimi K3.1 Pro。
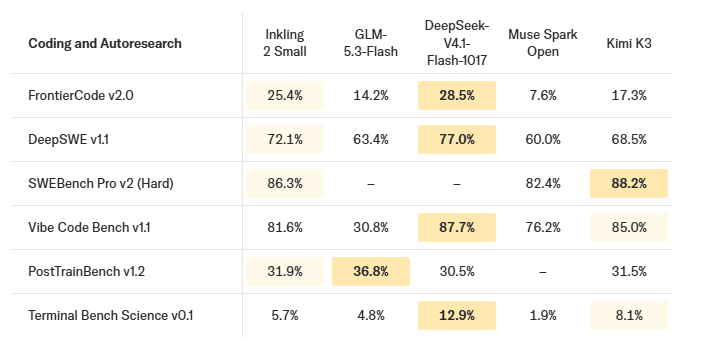
这些结果支持「比前代更能完成复杂任务」,还不足以支持「所有编程场景都更强」。
低成本和低幻觉,都要连着代价一起看
新模型每个评测任务平均生成约 15 万个输出 token,约为前代的 4 倍;任务成本为 1.18 美元,接近前代的 6 倍。能力上涨,并没有让它比上一代更省。
它相对其他模型仍然便宜。按 Artificial Analysis 的任务成本统计,Gemini 3.8 Flash 为 7.77 美元,Claude Sonnet 5.5 为 10.02 美元,Inkling 2 Small 更接近低价中国模型的区间。
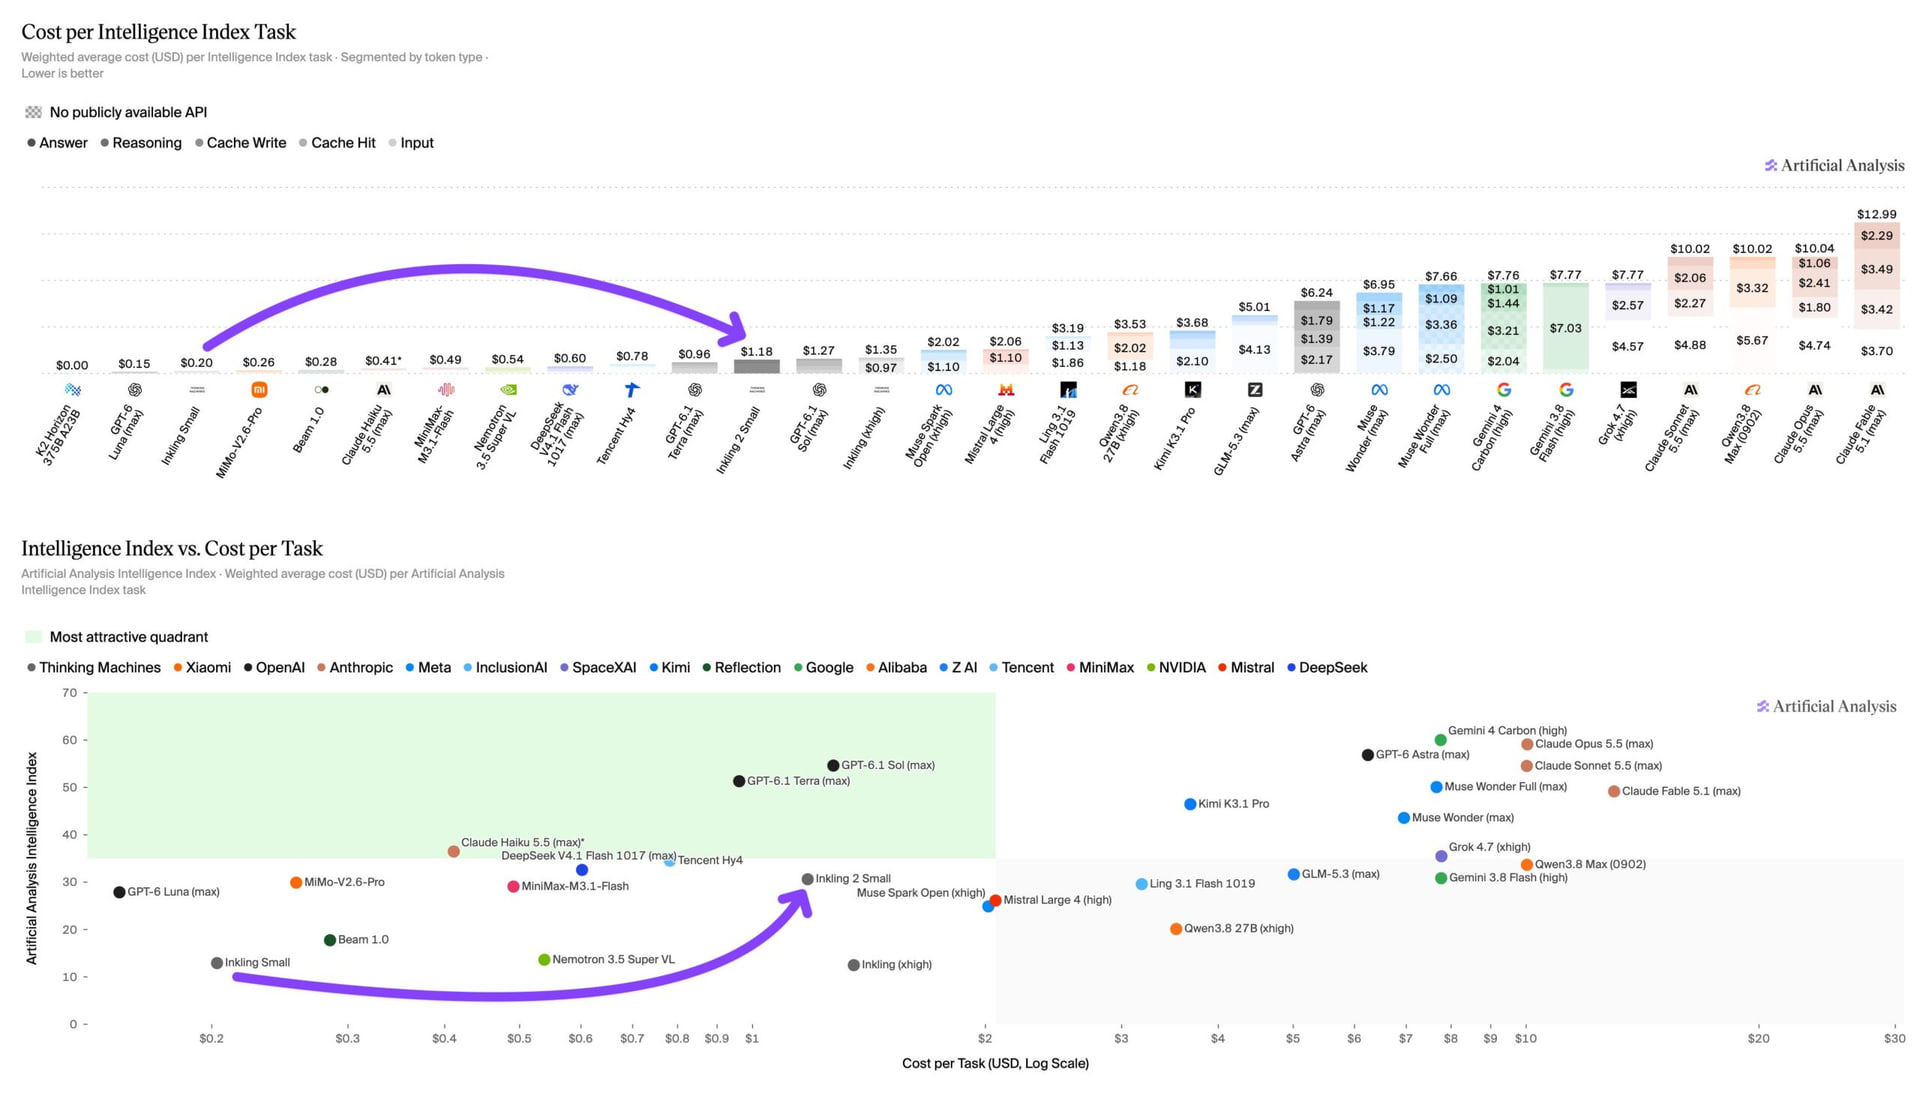
但 1.18 美元是评测中的每任务成本,不能直接当成一次接口请求的价格。原文没有交代这些任务对应的响应耗时,也没有给出一般团队自托管后的硬件成本。
170 亿激活参数不等于整个模型只有 170 亿参数,部署预算仍需考虑 5940 亿总参数。
幻觉指标也有类似问题:幻觉率从 61% 降到 27%,同时回答率从 77% 降到 53%。原文明确指出,下降很大程度上来自模型少回答问题。
这是一种有价值的取舍,但不能只报前一个数字。知识问答系统可能更需要谨慎回答;要求持续交付结果的自动化流程,则还得衡量剩余问题由谁处理。
网页设计值得试,开放权重还要等
视觉部分,Thinking Machines 称模型擅长文字识别、信息图理解和视觉推理。复杂 PDF 问答评测 GDP.pdf 得分为 25.2%,在所比较模型中最高;包含学术图表理解的 MMMU Pro 为 81.6%,视觉感知评测 PerceptionBench 为 64.7%。
和前端最直接相关的是 DesignArena Website:用户对生成的网站进行两两比较,Inkling 2 Small 获得 1,340 Elo,在开放权重模型比较中最高。这个结果值得拿来筛选网页生成候选模型,但不能直接替代对交互、可访问性和代码维护成本的检查。原文也没有提供这些维度的成绩。
他们团队还宣称模型在 3D 建模上有所进步,并展示了仅凭照片识别葡萄酒的实验:20 次尝试中,19 次正确识别三款酒。这个演示很吸睛,但原文没有充分说明实验设计,难以据此判断日常图像理解的可靠程度。
训练规模同样来自公司披露:全部阶段约处理 12 万亿 token;基础训练后的强化学习阶段用了 3 万亿 token,在 2,048 张 GPU 上运行 9 天。原文称训练规模小于同类竞争者,却没有列出完整的对照条件。
目前模型通过 Tinker 平台提供,仍是专有服务。公司计划在外部安全测试完成后,以 Apache 2.0 发布权重,具体日期没说清。原文将这种许可与 Meta、Mistral 的限制性开放权重许可作比较,但没有逐一展开条款。后续还计划推出其他尺寸的家族成员。
我的判断
我更看好它对专用编程和视觉工作流的价值。长周期任务训练、自动检查代码和可调思考深度,确实都对准了实际使用中的难点。不过,训练方法与涨分之间还缺少对照实验,不能把全部进步归因于某一项做法。
「西方最强」也只是限定范围内的说法。原文里的中国模型已经在多个编码项目上领先,且比较名单并不完整。国内团队选模型,没必要围着这个地域标签做决定。
更现实的限制来自公司自己的承认:它沟通有时低效,在大型代码库中不总能选对工具,不支持音频,对聊天优化不足,还可能对健康话题反应过度、输出杂乱。相比直接替换现有通用助手,先放进边界明确的任务里比较,更容易判断收益。
权重尚未发布,Apache 2.0 目前是发布计划,不能当成已经具备的部署条件。
能拿来做什么
- 如果你在比较 AI 编程助手,可以用同一批真实仓库任务测试它,记录测试通过情况、工具选择、总 token 和完成耗时,重点看长步骤任务是否值得多花成本。
- 如果你做网页生成,可以把它列入候选,用同一份需求比较视觉结果,再检查交互是否完整、生成代码是否方便继续修改。
- 如果你做 PDF 或图片问答,应同时记录回答准确率和回答率,确认少答问题带来的人工处理量是否可以接受。
- 如果你打算微调或自托管,可以先通过 Tinker 验证任务效果,等权重与许可正式发布后,再评估部署资源和使用条件。