把语音时间戳变成 Remotion 逐词字幕
教程利用 ElevenLabs 随音频返回的字符时间戳,聚合单词与句子后在 Remotion 中生成逐词字幕。流程还覆盖音乐节拍剪辑及 ffmpeg 冻帧、响度检查,并注明示例运行环境与验证情况。
AI 深度解读
用 ElevenLabs 生成旁白,再用 Remotion 做逐词字幕,最费时间的环节可能可以直接省掉:生成语音的接口已经返回了每个字符的起止时间,不必听一句拖一次时间轴,也不必再跑语音识别。
作者把这份时间数据串成了一条视频流水线:字幕随词出现,画面切换适度卡点,导出后自动检查冻结画面和响度。值得学的是如何让字幕跟着音频重新生成。不过,模型对齐精度、中文分词和成片质检,都有需要单独验证的前提。
字幕时间为什么应该从生成语音时就拿到
手工打轴的问题不只是慢。逐词字幕每个词都需要一个时间点,脚本一改、旁白一重生成,后面的标记就可能全部失效。
事后使用 Whisper 等语音识别工具,能减少工作量,但识别结果仍要与脚本核对。停顿和换气附近的词边界需要估计,数字、产品名、品牌拼写也可能与原稿不同。
作者选择直接使用 ElevenLabs 的 with-timestamps 接口,一次取得音频和字符时间。这段代码解决的是「旁白和字幕时间来自同一次生成」:
// tts.mjs (Node 18+): one request, audio + character timings back
import fs from "node:fs";

const VOICE_ID = "JBFqnCBsd6RMkjVDRZzb"; // any voice from your ElevenLabs library
const text = "Captions should land on the word. Not near it.";

const res = await fetch(
  `https://api.elevenlabs.io/v1/text-to-speech/${VOICE_ID}/with-timestamps?output_format=mp3_44100_128`,
  {
    method: "POST",
    headers: {
      "xi-api-key": process.env.ELEVENLABS_API_KEY,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({ text, model_id: "eleven_multilingual_v2" }),
  },
);
if (!res.ok) throw new Error(`${res.status}: ${await res.text()}`);

const { audio_base64, alignment } = await res.json();
fs.writeFileSync("voice.mp3", Buffer.from(audio_base64, "base64"));
fs.writeFileSync("alignment.json", JSON.stringify(alignment, null, 2));
要留意 model_id 和 alignment。响应还包含 normalized_alignment,对应数字展开等规范化处理后的文本;希望字幕保留脚本原来的写法,就按作者的方案使用 alignment。
它包含三个对应数组:characters、character_start_times_seconds、character_end_times_seconds。原文实际响应中,Captions 从 0 秒开始,到 0.546 秒结束,后面的空格结束于 0.58 秒。
生成端提供时间戳,省掉的是重复推断和人工维护,并不自动保证所有模型都同样准确。
作者实测 eleven_multilingual_v2 与音频贴合较好,较新的 v3-generation 模型却提前约 0.7–1 秒。原文没有交代样本量、语言和统计方法,因此这是排查线索,不能当作普遍结论。字幕整体偏早时,可以先换模型对照,再考虑手加偏移。
从字符到字幕,难点在分组和画面稳定
有了字符时间,下一步是把字符合成词,再把词合成句。下面这段保留了作者的完整转换逻辑:
// words.mjs: ElevenLabs character alignment -> words -> sentences
export function toWords(al, offset = 0) {
  const words = [];
  let text = "", start = 0, end = 0;
  const flush = () => {
    if (text) words.push({ text, start: start + offset, end: end + offset });
    text = "";
  };
  al.characters.forEach((ch, i) => {
    if (/\s/.test(ch)) return flush();
    if (!text) start = al.character_start_times_seconds[i];
    end = al.character_end_times_seconds[i];
    text += ch;
  });
  flush();
  return words;
}

export function toSentences(words) {
  const out = [[]];
  for (const w of words) {
    out[out.length - 1].push(w);
    if (/[.!?]["')\]]*$/.test(w.text)) out.push([]);
  }
  return out.filter((s) => s.length > 0);
}
关键是 /\s/ 和句末正则:前者按空白分词,后者识别英文句末标点及其后的引号、括号。标点会留在所属词上。旁白若从合成时间轴的第 2 秒开始,传入 offset = 2 即可整体平移时间。
这也暴露了中文适配边界。没有空格的中文不能直接靠这段代码得到逐词结果,。!? 也不在断句规则里。字符时间仍然有用,但需要补充分词、断句和索引映射。
Remotion 部分的设计很克制:屏幕只保留一句,当前句取「首词已经开始的最后一句」。旧句在下一句开始前的 0.1 秒淡出;新词从 85% 大小、0.35 不透明度入场,在 0.1 秒内恢复正常。代码用 transformOrigin: "0% 80%",配合顶部固定的字幕块,减少缩放和换行带来的晃动。
作者还把显示时间写成 frame / fps + 1 / fps,让词提前一帧出现。他们觉得这样更跟嘴,这是观看体验上的取舍,并非时间戳精度的证明。
作者称教学代码均已运行或通过类型检查,环境是 Node 18+、Remotion 4.0,并要求 PATH 中有 ffmpeg。音频组件使用 Html5Audio,较早的 4.0 版本叫 <Audio>,属性相同。生产使用还要固定行宽、等待字体加载后测量,并限制每句行数。示例中的 fontSize: 84、paddingTop: 700 属于具体版式参数,需要随画幅调整。
卡点和质检,分别应该管到哪里
作者给卡点划了一条边界:镜头切换、视觉冲击和音效可以向节拍靠,旁白时间保持原位。强行把语音挪进节拍网格,容易破坏自然节奏。
节拍来源可以是 librosa 的 beat_track。他们团队使用 Node 脚本读取 ffmpeg 输出的原始 PCM,分析声音起音强度,以自相关估计速度,再寻找合适的网格相位,并提高低频权重,让底鼓比踩镲更影响结果。
真正值得照搬的是移动上限。snapToBeat(t, beats, maxShift = 0.12) 只吸附到 120 ms 以内的最近节拍,否则保持原位。示例先取句首前 0.15 秒作为切点,再按 fps = 60 换算为帧。
在 120 BPM、每拍 0.5 秒的示例中,五个切点只有两个移动:4.587 → 4.540 秒、6.514 → 6.536 秒,其余三个保留。卡点服从叙事位置,避免为了整齐把镜头拖远。
导出后的检查则分两项:
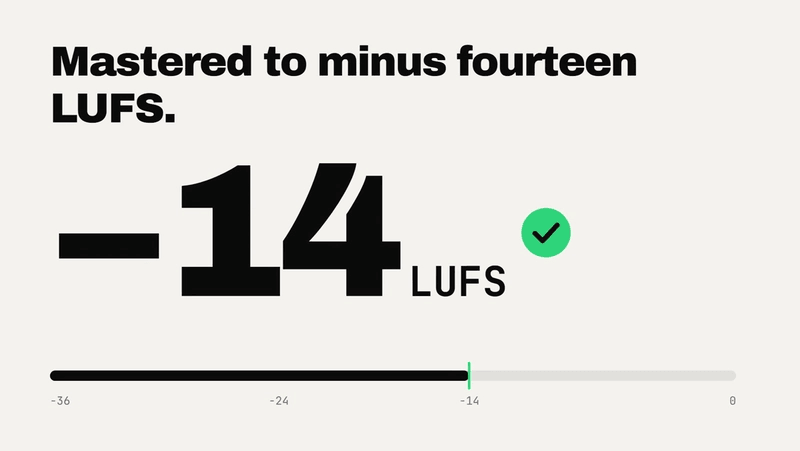
node qa.mjs out/video.mp4使用freezedetect=n=0.001:d=0.5检测至少0.5秒的冻结片段,噪声容差0.001对应-60 dB。ebur128=peak=true测量整段响度,示例以-14 LUFS为目标,偏差不超过1 LUFS判为通过。
作者人为插入一秒冻结并降低音量,检测得到起点 2.983333 秒、持续 1.016667 秒,以及 -23.6 LUFS 的响度。这说明脚本捕捉到了这个测试文件的问题,但检测到静止仍需判断:结尾卡片可能就是有意停留。
修复响度使用 node loudnorm.mjs in.mp4 out.mp4,分两遍执行 loudnorm,目标为 I=-14:TP=-1.5:LRA=11。第二遍传入测量结果并设置 linear=true,通过 -c:v copy 保留视频流,音频输出采用 -ar 48000、AAC、192k。
另一轮测量中,同一测试文件从 -23.7 LUFS 调整到 -14.0 LUFS。但 linear=true 并非保证:单次增益若会突破真峰值限制,滤镜会回退到动态模式,所以处理后必须重新检查。-14 LUFS 也是作者选择的常见目标,最终应服从发布平台要求。
我的判断
我赞成把音频和时间数据作为一组产物保存。它把改稿后的重复劳动变成了可重新执行的数据转换,对使用 TTS 的视频流程很实用。
不过,文章没有提供人工打轴、Whisper 与生成端时间戳的系统对照。模型精度和提前一帧的体验判断,都属于作者的实测经验。已有真人录音时,生成端时间戳也无从取得,仍需要识别或对齐方案。
质检脚本适合当初筛。字幕跳动也算画面变化,可能掩盖背景素材停住的问题;响度达标也不能证明旁白清楚、音乐比例合适。
原文同时在推广 Heyn Motion Kit:它是叠加在 Remotion 项目上的 Claude Code skill,加入 Whisper 回退、多画幅和渲染检查等功能。标价 $39,所述周末优惠 $10,截止 Nov 8, 23:59 KST,这是原文促销信息。原文还称 Remotion 对个人及最多 3 人公司免费,更大公司需要公司许可证;这些信息都不能替代购买或使用时的条件核对。
能拿来做什么
- 如果你在用 Node 批量生成 TTS 视频,可以同时保存
voice.mp3、alignment.json和脚本,改稿后重新生成字幕数据。 - 如果你要做中文 Remotion 字幕,可以先补齐中文分词、句末标点和字符索引映射,再调整逐词动画。
- 如果视频需要配乐卡点,可以保留旁白时间,只让切点在
120 ms范围内吸附,并检查切换后是否仍贴合句意。 - 如果已有自动渲染流程,可以把冻结检测和响度测量接到导出之后,将异常时间段交给人工复核。