本地语音模型实测:速度指标必须结合运行环境
作者在 M4 mini 上测试 Ming-3.0 TTS 的 MLX 8 位版本,两段缓存音频的实时率为 0.85 和 0.87,慢于标称的 0.39。文章区分首次下载与生成耗时,并强调应结合延迟预算和流水线控制需求判断适用性。
AI 深度解读
模型卡写着 RTF 0.39,作者在自己的 M4 mini 上测到 0.85,速度差了约 2.2 倍,却仍打算给它留一个位置。原因很实际:本地语音合成不能只看谁跑得快,还要看业务能等多久,以及是否需要声音克隆、情绪和语气控制。
这次测试更有价值的发现,是一个不会报错的依赖问题:版本装错,模型照样流畅发声,只是念的内容不对。对准备接入本地 TTS 的程序员来说,先验证运行环境和输出内容,再比较性能,比照抄榜单可靠。
RTF 小于 1,为什么还是不够快
RTF 是生成耗时与音频时长的比值。RTF 0.85 表示生成 1 秒音频大约需要 0.85 秒,但它不能直接回答用户按下按钮后,要等多久才能听到第一句话。
作者在 2026-10-28 测试了 inclusionAI/Ming-3.0-tts-0.5B 的 MLX 移植版 mlx-community/Ming-3.0-tts-0.5B-8bit。原模型采用 Qwen2.5-0.5B 骨干,搭配 DiT、音频 tokenizer 和 CAM++ 说话人编码器;移植版占用磁盘 1.5 GB。
两段缓存后的测试结果是:
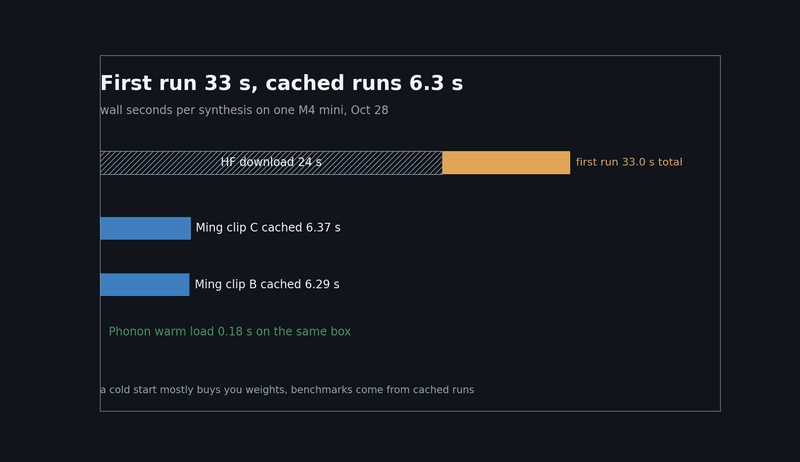
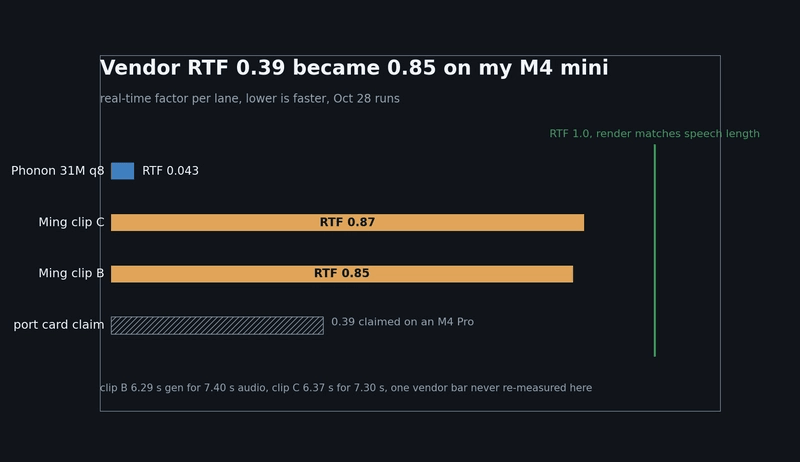
- B 段生成耗时 6.29 秒,音频长 7.40 秒,RTF 0.85。
- C 段生成耗时 6.37 秒,音频长 7.30 秒,RTF 0.87。
输出为 44.1 kHz、单声道、16-bit。首次运行总耗时 33.0 秒,其中 24 秒用于 HF 下载,不能混入缓存后的性能比较。
模型卡的 RTF 0.39、峰值内存 2.2 GB,来自 M4 Pro;作者用的是普通 M4 mini。两者不是同一台硬件,运行时构建也可能影响结果,因此约 2.2 倍的差距不能直接归结为厂商虚标。
但它足以说明:模型卡的速度不能直接当作自己机器的延迟承诺。
这里也要收住结论。缓存样本只有 n=2,RTF 相差 0.02,只能说明这两段表现接近,不能证明长文本、不同语言或连续运行都稳定。
慢约二十倍,买到的是什么能力
作者原来的速度基线是 Phonon S 31M q8。同一台机器上,它的 RTF 为 0.043,首块音频等待 8–23 ms,暖加载 0.18 秒,冷加载 4.5 秒,输出 24 kHz,仅支持英语。
Ming 的生成速度慢约二十倍,但两者提供的控制能力不同。Phonon 的 add_voice 需要 Gradium Studio 提供的 .safetensors,没有音频提示入口,也没有作者需要的风格指令和表达控制。
Ming 则提供短参考音频的零样本克隆、用自然语言描述声音的 Voice Design、自由表达控制,以及 14 种内联副语言标签,例如呼吸、咳嗽、叹息、笑声和犹豫。它还支持显式设置情绪、速度、音高、音量,提供 UK_George、US_Emma 等内置声音,覆盖七种语言及四川话、粤语。
所以作者的选择是保留两条路线:实时通话继续用快模型,需要声音设计或克隆时再考虑 Ming。按实测速度,一句约七秒的话需要约 6.4 秒生成,无法仅凭 RTF 小于 1 就认定适合双向通话。
移植版还有三处缺口:MLX 没有提取 CAM++ 说话人嵌入,克隆只使用参考音频和转录文本;文本规范化未移植,数字要预先写成文字;停止头偶尔不能及时结束,留下尾音。作者测得样本最后一秒 RMS 为 1439,相对满幅 32767 确实非零,但究竟是呼吸还是伪影,仍需试听判断。
比跑分更早该检查的是依赖版本
Ming 移植版要求 mlx-audio 0.6.1 或更新版本。0.6.0 及更早版本存在提示契约问题,修复对应 mlx-audio #1047。作者安装的是 0.6.3,并在跑分前检查了最低版本。
这个故障很容易漏掉:程序不抛异常,音频也流畅,却可能念错整句话。只检查文件是否生成、耗时是否正常,会把错误输出算成一次成功调用。
能生成音频,只证明链路跑通,不证明模型正确执行了输入。
质量表也需要同样谨慎。模型卡给出的 Seed-TTS 英语评测中,Ming 的词错误率 WER 为 1.584%,相似度为 0.691;CosyVoice3-1.5B 为 1.45%/0.695,GLM-TTS 为 2.23%/0.672,F5-TTS 为 1.83%/0.647,Qwen3-TTS-1.7B 的最佳 WER 为 1.24%。
这些都是厂商评测,作者没有复测。另一组 MiniMax 多语言结果为 DE 0.365%、ES 1.099%、FR 4.264%、KO 1.728%、JA 3.765%,同样不能直接当成自己业务的效果保证。
我的判断
我认同按延迟预算和控制需求选模型。离线生成配音与实时通话,对等待时间的容忍度不同,没有必要只用一张速度榜决定全部场景。
但原文开头说已经采用,后面又说仍要试听 ming_freeform、ming_tags、ming_pitch 三段音频后决定。更准确的理解是:作者已经给 Ming 留出候选位置,最终质量验收尚未完成,不能写成一次完整的生产落地验证。
现有材料也不足以证明它的声音克隆或表达控制优于其他模型。这里只有两段缓存性能测试,没有盲听、完整控制能力对照或业务验收数据。两条路线的取舍有道理,质量优势仍是待验证项。
模型卡创建于 2026-09-22,更新于 2026-10-27,作者查看时有 161 个赞、月下载 6,316 次。这些能帮助发现候选模型,不能代替正确性检查和试听。
能拿来做什么
- 给本地 TTS 的基准脚本加入依赖版本检查,将 mlx-audio 0.6.1 作为这次移植版的最低要求;测速度前先确认输出确实对应输入文本。
- 在 Node 调用或日常测试记录中,分别统计首次下载、冷加载、暖加载和生成耗时;实时交互还要单独记录首块音频等待时间。
- 如果项目同时需要实时通话和可控配音,可以分别验证快模型与 Ming;把延迟要求和克隆、情绪控制需求写成明确的验收条件。
- 为验收准备包含数字、表达标签和句尾停顿的固定文本,先按移植版要求把数字写成文字,再检查发音、控制效果及尾音,保留可重复试听的样本。