AI 编程提速后,审查成本追上生成成本
作者团队发现,AI 代理检查和交付代码的开销已接近编写代码,并复盘突破人工审查瓶颈的六步演进。其做法包括将团队经验固化到多代理审查中,让独立上下文的代理在提交 PR 前检查需求与验收条件。
AI 深度解读
AI 写代码越来越快,团队却未必交付得更快:PR 堆在评审环节,CI、冲突和返工继续吃掉时间。Cloud ex Machina 的解法,是让 Agent 接手更多检查与交付,再把审查前移到需求入口。
他们的账单显示,检查和交付代码的 Agent 开销已接近写代码,有些周甚至更高。这篇值得读的地方,是它把评审、订阅采购、成本计量和需求质量串成了一条链;但 PR 数增长能否代表业务收益,还得另算。
代码生成提速之后,为什么评审成了大头
作者把 Agent 写得比人审得快的临界点叫作「评审墙」。他们选择持续修好当前 PR:先由独立 Agent 检查,修完问题,再交给同事。
这套多 Agent 评审最初叫 ultrareview,后来改名 cxm-pr-review,与 Anthropic 的同名服务区分。评审 Agent 不携带写代码时的上下文,依次检查需求与验收、潜在破坏、安全性、测试有效性和重复实现。测试检查还会追问:改动行被故意变异后,测试能否发现?质量评分达到 85,才进入人工评审。
但原文没有公开评分公式,85 分不能直接搬成其他团队的质量标准。
全面启用后的一个月,产品 PR 增长超过 40%。作者也承认,模型同期进步,不能把增长全部归功于评审。
成本同样明显:一次评审约消耗 100 万 tokens,与 diff 大小关系不大。作者给出的 Anthropic ultrareview 价格为每次 $5–$25。他们故意用按量超额付费摸清成本,结果 5、6 月账单超过平时的 3 倍,峰值超额费用达到数千美元。
随后,每位开发者在 Claude Code 之外又获得 Codex 席位,重度用户增加额度。次月超额费用归零,8 月小幅回升,9 月起持续为零;整体 Agent 支出比峰值低 44%。9 月顶级固定费率套餐成为默认配置后,产品合并 PR 接近 8 月的两倍。
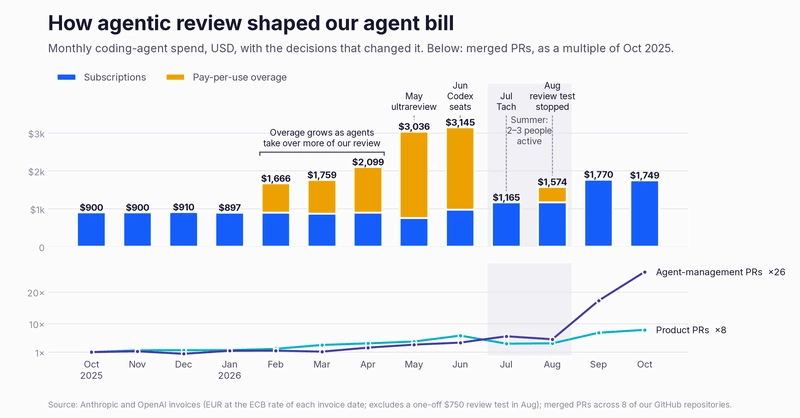
按作者估算,相同用量若按标价支付,至少贵 6 倍。从 2025 年 10 月到 2026 年 9 月,每个合并 PR 的 Agent 支出下降 4.6 倍;到 10 月,产品 PR 约为起点的 8 倍,Agent 管理 PR 约为 26 倍,后者起点更小。
这些数据首先证明了他们采购方式的效果,不能推出任何团队买订阅都会获得同样收益。
账单降下来,还得知道 tokens 花在了哪里
团队随后开发 Tach,名称来自 tachymeter。第一版记录每次 Agent 会话的 tokens、工具和工作内容,很快找出了一个被 Agent 绕行数周的工具 bug,以及问题修复后仍在误导 Agent 的旧记忆。
为了分类,他们给轨迹标注仓库、分支和工单。TypeSafe 的 Jev 提供了一个合适思路:输入文本与带类型的问题,返回标签和概率。出于不向第三方发送会话的考虑,他们自建 JEV,采用与 OpenJev 相同的请求结构,在小型快速模型后使用三次投票。原文没有给出模型名称、分类准确率或投票细节。
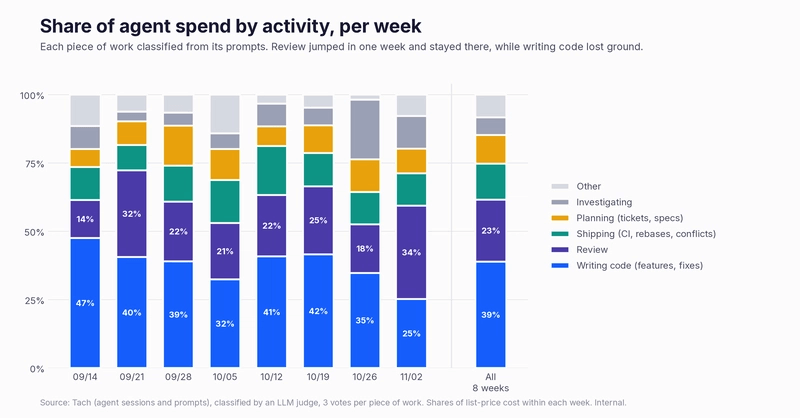
2026 年 9 月 14 日至 11 月 8 日的八周数据里,写代码占 39%,评审占 23%,交付占 13%,规划占 10%,调查占 7%,其他占 8%。交付包括 CI、变基和合并冲突。
9 月中旬,写代码接近一半,评审加交付约四分之一;9 月下旬起两者接近。11 月第一周,评审与交付合计 46%,写代码只有 25%。
生成代码变便宜之后,确认代码正确并把它交付出去,正在成为新的成本中心。
这里的「成本」需要限定:活动根据提示词分类,缓存 tokens 没有计价,所以这些比例适合观察开销结构,不能直接当作精确金额占比,更不是完整研发成本。
Tach 后来又接管了开发生命周期的执行框架,也就是 harness:把流程规则、工具调用和事件响应组织起来。它在负责人自己的机器上运行,响应评审请求、CI 失败等事件,推动 PR 从草稿走到合并。各仓库通过插件补充自己的规则,团队希望先压低交付环节的 13%。
保留自己的编排层,也让他们继续使用自己的订阅和机器。自建的动机既有流程控制,也有计费方式。
最贵的返工,可能在写代码之前就决定了
持续修好 PR 有个前提:这个 PR 原本就值得做。若工单方向错了,严格评审只是把错误需求实现得更完整。
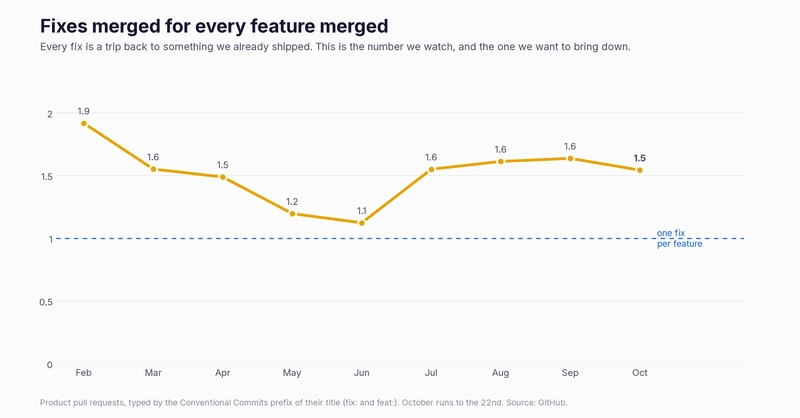
他们因此盯上「每个功能对应多少次修复」。2026 年 2 月,这个比值为 1.9,6 月降至 1.1,7 至 10 月约为 1.5–1.6,9、10 月约为 1.6。修复意味着重新处理已经交付过的东西,但这个比值并不等于功能缺陷率。
新的 Linear 工单必须说明预期结果、为什么重要、Agent 开工前就能检查的「done when」,以及上线后观察的指标。缺少这些内容,软件工厂拒绝接单。入口还会检查可交付性、重复需求和历史尝试,避免同一个问题付费两次。
他们也准备重放引入 bug 的 PR 评审,追查当时漏掉了什么,再把经验带入下一张工单。
原文引用的 Tokenomics 研究,在根据简短描述构建小程序的自动流水线中,评审占 tokens 的 59%,设计仅占 2%;他们团队对应的是评审 23%、规划 10%,后者比例为研究中设计的 5 倍。不过,两边任务和口径差异很大,作者明确承认不能公平比较。
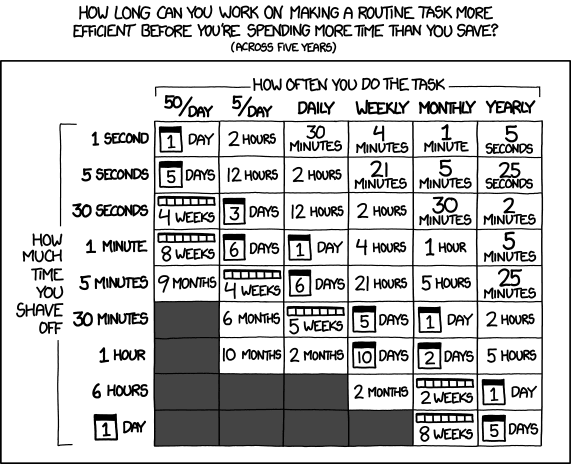
作者借 xkcd 1205 提出:构建变便宜后,更该问需求有没有价值。他们举过一个六行修复、每年约节省 $20,000 的案例,但本文没有展开核验过程。更关键的问题仍未解决:「done when」能判断功能是否完成,不能判断功能是否值得做。
统一紧凑术语以减少 tokens 和歧义、监测规则被错误泛化的漂移,也都还在研发阶段,没有效果数据。
我的判断
我认同把质量检查前移,以及用生产问题反查评审盲点。这比单纯增加评审轮次更接近减少返工的目标。
但「检查现在和写代码一样贵」只在他们的 Agent 使用结构中得到支持。人工评审时间、自建 Tach 的维护投入、线上故障损失,都没有被统一纳入这组比例。产品 PR 增长 8 倍,也不能直接等同于价值增长 8 倍。
固定费率订阅适合他们的高用量,本机编排也契合他们的执行方式。原文没有完整披露套餐容量、限流和团队规模,普通团队不能据此认定按量调用一定不划算。
与直接使用托管评审、现有 CI 相比,自建软件工厂能保留更多流程控制,也多了一套系统要维护。作者没有提供两种方案的对照成本,因此「应该拥有自己的编排层」仍是经验判断。Cloud ex Machina 同时提供软件工厂和 FinOps 服务,文章里的做法也带有他们的业务视角。
能拿来做什么
- 先统计上个月合并 PR 中
fix:与feat:的数量,再抽样核对修复原因。前端和 Node 项目都可以用它寻找返工线索,但不要把标题比值直接当作缺陷率。 - 给 AI 编程任务补齐预期结果、验收条件和上线观察指标。让 Agent 检查这些条件是否成立,再进入实现,尤其要提前查重。
- 在现有 CI 和人工评审前,增加一个不携带作者上下文的 Agent 检查步骤,优先审查需求覆盖与回归风险。评分规则尚未定义清楚时,不必照搬 85 分门槛。
- 先按实现、评审、交付记录 Agent 用量,再决定优化哪一段。若主要消耗来自 CI 重试和冲突处理,缩短生成代码的提示词未必能解决账单问题。