拆开事实提取、判断与写作三步
文章将混合多目标的长提示词拆为事实提取、规则判断和文稿生成三个阶段,以结构化字段传递结果。通过限制各阶段可见上下文,减少原文语气和写作目标对事实与判断的干扰。
AI 深度解读
让模型读材料、判断轻重,再写一份有说服力的回复,一个长提示词就能启动。但作者提醒:当这三个目标共享同一份上下文,写作倾向可能反过来影响判断,甚至让提取出的事实混入猜测。
他的建议是把流程拆成职责单一的 Agent,用固定 JSON 交接,并在每次交接时校验。对正在搭建 AI 工作流的程序员,这篇文章的价值是给出了一套明确职责和数据边界的方法。不过,它没有提供实验对照,效果仍需自己验证。
为什么提取、判断和写作要分开
作者用合规审查举例:一个提示词既要忠于原文,又要判断事件是否重要,还要把回复写得有说服力。这些目标可能互相干扰。例如,摘要里悄悄出现原文没有提过的处罚,或者模型为了配合已经起草的回复,调整了对事件的判断。
他的拆法是三个 Agent 串联:
- 提取 Agent 从原文中提取事件事实,填入固定字段。
- 评估 Agent 只根据这些字段,判断事实是否达到某个门槛,例如重要性门槛。
- 起草 Agent 根据评估结果撰写回复。
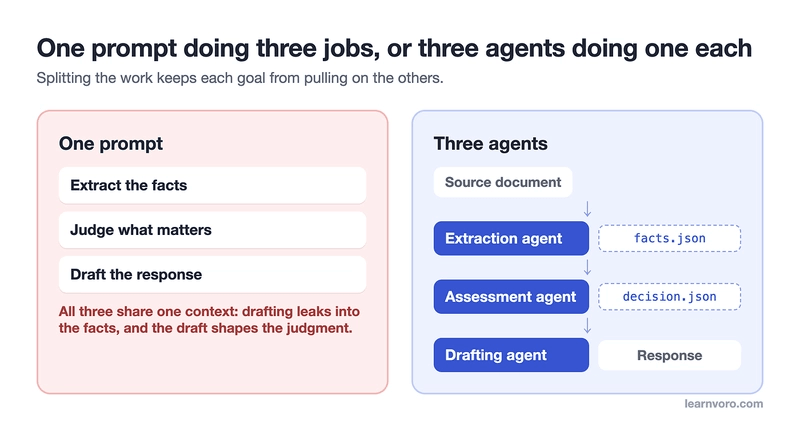
这里真正起作用的是可见信息的边界。评估 Agent 看不到原始文档,原文的措辞和语气就难以直接影响判断;提取 Agent 看不到草稿,写作方向也无法直接回流到事实提取。
拆分的依据是目标是否冲突,而不是任务能切成多少步。
作者也提醒,每增加一次交接,就多一个出错位置。职责清楚的三个 Agent,比边界模糊的八个更合适。
怎样让职责约束变得可以检查
「你是一名严谨的法律审计员」听起来很严格,却没有明确禁止什么。模型仍可能提供建议、改写句子,或者用猜测填补缺失信息。
作者建议写反目标(anti-goals),也就是明确列出不能做的事。对于提取 Agent,约束包括:
- 原文没有的事实不能补充,字段缺失时使用
null。 - 不能判断事件是否重要。
- 不能改写、概括或弱化原文措辞。
- 不能增加 schema 之外的字段。
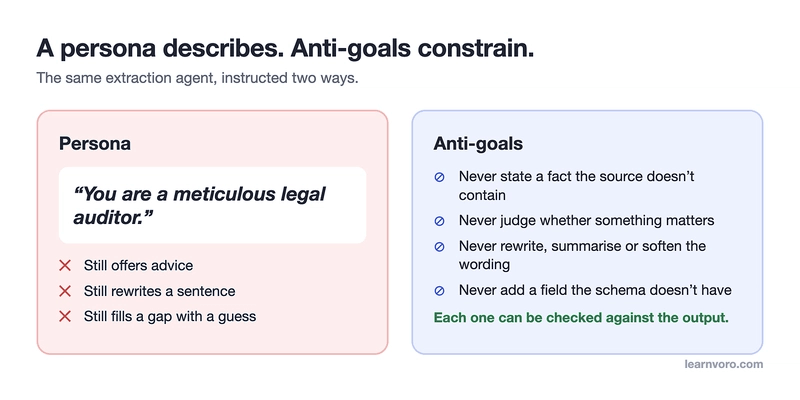
这些规则更容易转成验收条件。例如,额外字段可以通过程序检查,事实是否有出处则需要结合原文核对。「严谨」本身没有这样的检查入口。
交接也要遵循同样的思路。不要把整段聊天记录传给下一个 Agent,而是传固定 JSON,减少 token 消耗,也避免把无关上下文重新带回流程。
下面是原文给出的事件事实载荷,用来限定下游能够消费的数据:
{
  "incident_date": "2026-03-14",
  "systems_affected": ["billing"],
  "records_exposed": 12000,
  "data_types": ["email address", "postal address"],
  "source_quotes": ["Unauthorised access to the billing database was detected on 14 March."]
}
要注意 source_quotes:它提供了回查原文的线索,但示例中的这一条引文只直接支持受影响系统和发现日期,没有逐项支撑 12000 条记录及两种数据类型。原文没有给出完整材料,不能据此确认其他字段的准确性。
作者要求每次交接都校验载荷,缺键或类型错误就停止,避免让下游猜测。不过,上面的 JSON 只是数据示例,原文没有提供完整 schema,也没有说明具体校验实现。
为什么应该先写规格,再写提示词
作者建议先填一张 Agent Specification Matrix,为每个 Agent 写清角色、范围、反目标、输入和输出,再开始写提示词。
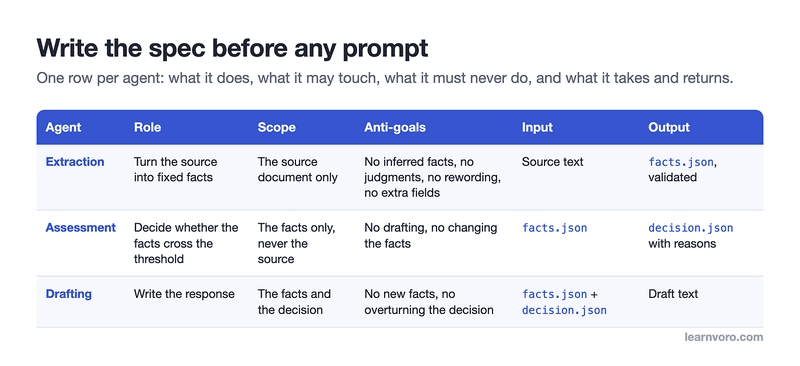
以提取 Agent 为例:角色是把原文转换成固定事实,范围仅限源文档,输入是源文本,输出是经过校验的 JSON,反目标就是前面的四条禁令。
这张表能提前暴露结构问题:两个 Agent 是否在做同一件事?某个输出是否根本没有消费者?下游需要的信息,上游是否承诺提供?
作者还建议,先用固定输入单独测试每个 Agent,再把它们串起来。这样至少能分清错误发生在提取、判断还是起草阶段。
我的判断
我认同把职责、输入和输出写清楚。这套方法最有用的部分,是让错误有位置可查,让约束有条件可验。
但作者把问题归因于设计而非模型,说得偏满。原文没有模型信息、测试集、错误率,也没有与单提示词方案的对照数据,因此「三个 Agent 更好」仍是经验性建议。
此外,评估 Agent 只看提取字段,也有代价:一旦提取漏掉关键限定条件,下游便无法从原文补救。JSON 类型正确,只能证明结构合格,不能证明事实正确。
对于简单任务,单次调用配合固定输出和校验,同样值得先试。是否拆成多个 Agent,应该由实际错误和维护成本决定。
能拿来做什么
- 在 Node 编排的文档处理流程中,先把提取、判断、起草的输入输出列成表,检查是否存在职责重叠或无人使用的输出。
- 如果当前任务经常在摘要中补出原文没有的信息,可以先单独约束提取步骤,要求缺失值返回
null,并保留对应原文引句。 - 在 JSON 交接处增加缺键和类型校验,让无效数据停止流转;同时保留事实核对步骤,避免把结构校验当成准确性保证。
- 用同一批固定输入分别检查各步骤和完整流程,再决定是否需要拆分,以及拆到哪一步就够了。