工程团队如何把Agent接入交付流水线
文章以Cognition、PostHog和Gumloop为例,梳理团队如何围绕Agent重做任务拆分、委派、审查与交付。PostHog单体仓库约70%的PR由Agent发起,Gumloop六周内合并了571个Agent编写的PR。
AI 深度解读
Cognition 报告称,工程团队从约 30 人增至 80 人,合并的 PR 数量却变成了原来的 40 倍。作者用「软件工厂」解释这种变化:由人定义需求和验收标准,由编码 Agent 执行,再由自动检查和人工评审决定哪些改动可以合并。
对前端和全栈团队来说,更值得看的是这套流程怎样接住突然增多的 PR。代码写得越快,需求漏掉的边界、测试覆盖不到的行为,以及多人同时改一处代码的冲突,就越容易集中到评审和交付环节。
40 倍 PR 背后,工程师改做了什么?
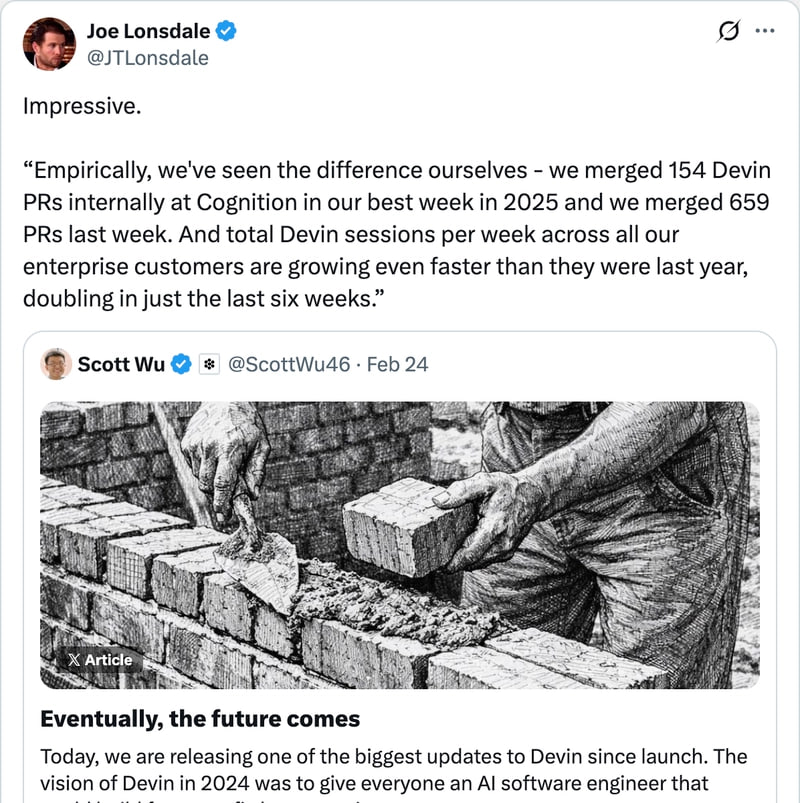
Cognition 的 40 倍来自 Walden Yan 在 AI Engineer 2026 分享的合并 PR 数据,同期工程师人数约为原来的 2.7 倍。原文还给了另一组周数据:2025 年表现最好的一周有 154 个 Devin PR,2026 年初达到每周 659 个,当时工程师提交的代码中有 89% 经由 Devin。这两组数字用了不同口径,原文也没有交代 40 倍的完整统计窗口。
Cognition 把团队划成负责各自产品领域的小组(pod),每组由 2–3 名工程师在 Slack 里管理多个 Devin 实例。人先写清楚要改什么、什么算做完、有哪些边界条件。Agent 卡住了就在 Slack 升级给人,提交 PR 后则进入自动检查和人工意图评审。原来散落在写代码过程中的判断,有一部分提前到了派工前,还有一部分集中到了合并前。
另外两个案例看的是不同环节。PostHog 的 monorepo 中,由 Agent 发起的 PR 占比在 4 个月里从约 20% 升至约 70%。Gumloop 围绕 Devin Bots 重组工作后,6 周内合并了 571 个 Agent 编写的 PR。一个统计发起比例,一个统计合并数量。它们都说明 Agent 开始承担经常性的工程任务,单靠这些数字还算不出交付时间缩短了多少。
多个 Agent 并行时,谁负责派工和隔离?
作者把截至 2026 年 11 月的工具归成四层。执行框架(harness)负责接收任务、调用工具、运行代码和返回结果,原文以超过 30 万 GitHub stars 的 Claude Code 为例。编排层负责拆任务、分配上下文、处理冲突和回滚。技能(skills)把项目的评审、测试、部署流程做成按需加载的能力,原文称 superpowers 在最近 30 天获得 32 万以上 stars。交付层则负责在合并前拦下有问题的改动。Stars 可以反映关注度,实际跑起来能否稳定交付,得看这些环节能不能衔接。
2026 年 10 月,Factory 和 Cognition 相隔 11 小时发布了面向多 Agent 的工具。Factory 的 Environments 为每个 Agent 提供隔离的执行环境。Cognition 的 Dynamic Workflows 让一个编排 Agent 拆分任务并委派给多个 Devin。常驻的 Devin Bots 又往前走了一步,它们可以在负责的产品区域内找 bug、清理或重构机会,为每项改动开小 PR。Software Factory 是 Devin Bots 的默认模板之一。
编排解决谁做哪件事,隔离解决一个任务出错时会波及谁。Thoughtworks 在 2026 年 4 月把编码 Agent 的沙箱执行纳入 Technology Radar。原文列出的做法包括每个实例一个沙箱、共享资源默认只读、网络出站仅允许已知端点、使用独立 git worktree,以及限制 CPU、内存、磁盘和执行时长。凭证在运行时注入。独立工作树能避免多个任务踩到同一份 checkout,文件权限、网络和资源限制还得由沙箱落实。
资本市场也在给这类基础设施定价。Factory 在 2026 年 9 月以 50 亿美元估值融资 2 亿美元,原文称 Cognition 最近一轮融资的估值超过 260 亿美元。投资人 Chamath Palihapitiya 判断,模型成本趋同后,独立执行框架和控制平面会变得更有价值。融资反映的是对这一方向的押注。
测试全绿以后,评审还要看什么?
作者借 Addy Osmani 的 Factory Model 提出,代码生成变快以后,验证会成为瓶颈。格式、已知安全模式和常见反模式可交给静态规则,测试可以验证已经写成断言的行为。评审者还得判断,需求有没有遗漏,改动是否符合现有架构,以及某段逻辑该不该由这个模块负责。原文以 Alibaba 的 Open Code Review 为例,它结合确定性静态分析与 LLM 评审,原文称其拥有 1.05 万以上 stars,并在阿里巴巴集团内部发现了约 100 万个缺陷。文中未给出统计周期和缺陷分类。
Greptile 分析了 470 个 PR,发现 AI 编写的 PR 中,逻辑和正确性问题的发现频率比人类编写的高 75%。作者把差异归因于规格和测试不完整。这个解释有道理,但给出的数据没有单独验证这个原因。PostHog 也报告,人仍会快速浏览 80% 的 Agent PR。测试全绿和需求表面吻合之间,还有一段需要人判断的空间。作者把迟迟没有补上的这部分叫「验证债」。
这也是原文提出三个角色的原因。编排者拆任务、设检查关卡并处理升级。规格编写者把需求写到可以验收。验证者守住跨模块的设计判断,发现那些能过测试、却会让系统越来越难维护的变更。Nader Dabit 称,当时 Cognition 有 70% 的 Devin 会话由人发起,并预测一年内会变成 90% 由自动化发起。后一个数字是预测。
我的判断
我认同先把验收写清楚,再增加并行量。三个 Agent 同时接到一个含糊需求,评审者就可能得从三份实现里反推各自的假设。遇到这种情况,把一个含糊的边界条件补成可执行的断言,往往比再加一个 AI 评审更直接。已有 CI 和人工评审的团队,可以先把反复出现的机械检查移进 CI,把人工时间留给业务边界和跨模块影响。
我会保留人工评审的知识共享作用。Agent 无需从评审中学习,维护系统的同事仍要理解为什么选了这个接口、哪些调用方会受影响。尤其当大部分改动由 Agent 生成,PR 可能是其他人第一次看见这次设计决策。涉及权限、共享状态或公共 API 的改动,局部实现也需要有人看。
原文用个人生产率提升 2–3 倍、团队吞吐量提升 5–40 倍区分两种工作方式。这组区间缺少统一口径和对照数据,只能当作作者归纳的经验。Cognition 本身就是 Devin 的开发者,团队熟悉工具,有条件为它重做流程。普通团队判断这套办法有没有收益,可以把合并量和评审耗时、返工情况、上线后的缺陷一起看。
能拿来做什么
- 下次把表单或 API 改动交给 Agent 时,在任务里写明验收标准和明确的边界条件。例如改重复提交逻辑,就约定重复请求的响应,以及首次请求失败后能否重试。
- 翻一遍最近的 Agent PR,把重复出现且规则明确的评审意见整理出来。能用 lint、类型检查或测试表达的,就放进 CI。人工评审集中看测试是否覆盖了真实用法,以及接口行为会不会影响现有调用方。
- 两个 Agent 并行改同一个仓库前,给它们各自的
git worktree和隔离环境,并在派工时写清楚共享文件归谁改。做完一轮后,把从派工到合并的耗时和返工次数记下来,再决定是否扩大并行。