用跨文件任务试选Gemini 4 Neon
谷歌将 Neon 定位于复杂分析和编程任务,文章建议用带页码引用的多份 PDF 对比表,以及涉及代码修改和测试的任务来试用。简单编辑可先试 Hydrogen,大型重构可把 Carbon 纳入比较。
AI 深度解读
两份供应商报价 PDF,加上一张对比表,听起来只是个摘要任务。可一旦同事要核对某笔月费出自哪一页,摘要省下的时间就可能花在翻原件上。原文建议把 Gemini 4 Neon 用在这类经常来回查文件的任务上,也可以拿它试试需要从代码改动追到测试的小需求。
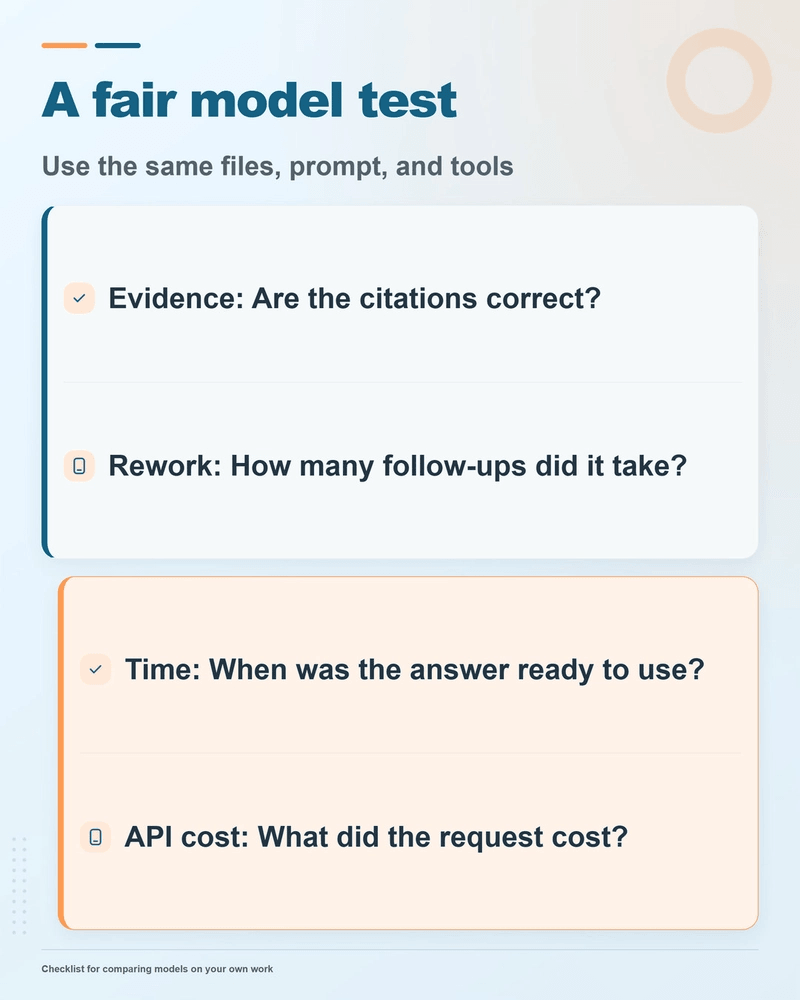
值不值得换模型,可以用同一批文件做一次对照。看每个值能不能从原件查到、补问了几轮、多久得到能交付的结果,再把 API 费用算进去。
哪些任务值得用 Gemini 4 Neon 跑一遍
Google 于 2026 年 11 月 18 日公布 Gemini 4 Neon,并在当天开始推出。按 Google 的定位,Hydrogen 适合邮件润色、快速摘要之类的日常工作,Neon 面向反复遇到的复杂分析和编程任务,Carbon 则面向耗时更长、难度更高的项目,比如要调整代码结构、同时保持现有行为的大重构。如果团队已经在用 Argon,作者建议把它也放进同一轮对比。按 Google 的说法,Argon 是独立模型,比 Carbon 响应更快,单次请求消耗的 token 更少。
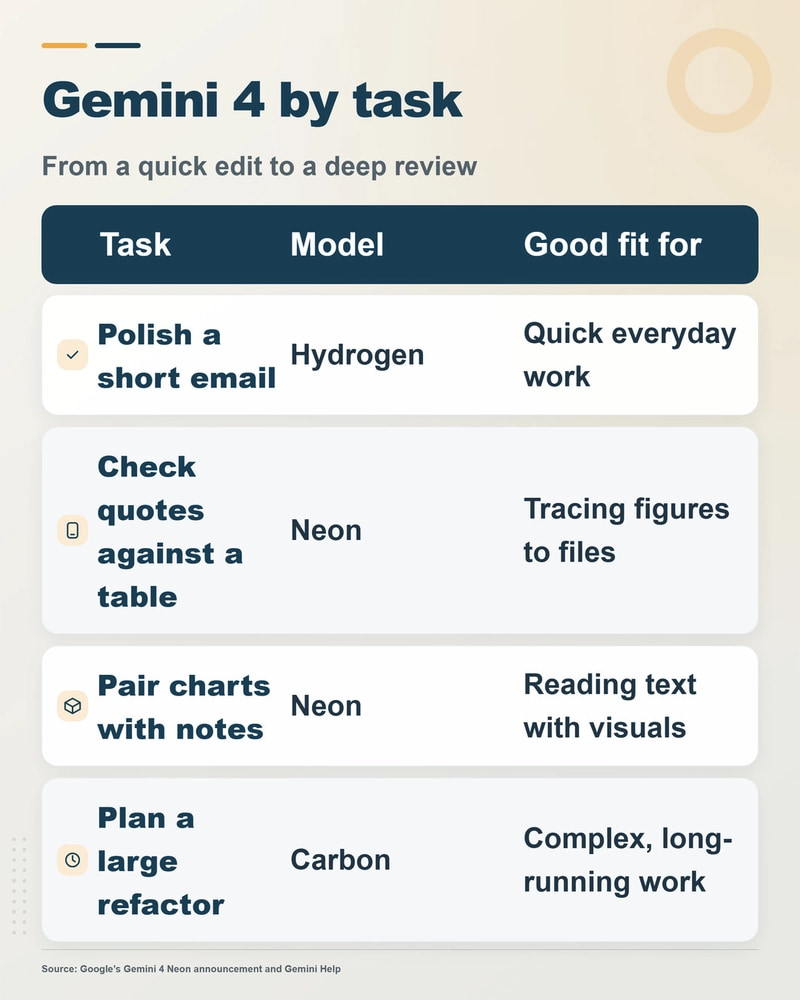
报价对比之所以适合试 Neon,是因为答案得跨文件对齐事实,还得留下核对路径。原文给出的提示词要求模型把安装费、月费和合同条款放到一张表里,每个值附上文件名及 PDF 页码或表格行号,源文件缺少的字段填 Missing from source。代码任务也能这么拆。比如排查空输入时,先让模型列出处理链路、涉及的文件和修改顺序,再给出空输入和合法输入各一条测试,写清预期结果。这样在动代码之前,就能检查它是否找对了入口和改动范围。
接入 API 时,长上下文和账单怎么算
通过 Gemini API,Neon 可以接收文本、图片、视频、音频和 PDF,返回文本。输入和输出共享 1,048,576 tokens 的上下文预算,发进去的文件越多,留给答案的空间就越少。标准请求的输出上限是 65,536 tokens。后台模式 long decode 的输出上限可以到 1,048,576 tokens,实际仍受同一个共享预算限制。做报价对比时,一张能逐格核对的短表就够了。
按原文转述的发布信息,个人 Google AI Pro 和 Ultra 订阅用户在获得访问权限后,可以从 Gemini app 输入框下方的模型菜单选用 Neon。网页版可在 Settings 里查看 Usage limits。大文件、更长的对话和更高的推理设置都可能消耗更多额度。
开发者可以先在 Google AI Studio 试请求。程序调用需要给 Gemini API 项目启用计费,模型 ID 填 gemini-4-neon。Neon 没有免费 API 档,项目当前的速率限制可在 AI Studio 查看。标准付费 API 每百万输入 tokens 收 3 美元,每百万输出 tokens 收 15 美元,推理消耗的 thinking tokens 也按输出计费。同样只返回一张短表,两次请求的费用也可能不同,做对照时可以直接记每次调用的实际成本。
56.3% 能告诉你什么
Zapier 在 2026 年 11 月 17–18 日运行了 AutomationBench 1.0.6。测试通过 API 在模拟应用里给模型安排了 657 项任务,每项最多 50 步。Neon 在 API 最深推理档位 xhigh 下通过 370 项,通过率为 56.3%。只有任务最终状态满足全部条件,才算通过。
原文建议借用这个判分办法。把同一批文件和同一份提示词交给 Neon 与现用模型,给两边相同的工具,事先定好哪些单元格必须附出处、缺项怎么算。拿到结果后,逐个打开引用的页和行,核对它们是否支持表里的值,再记下补问次数、从发出请求到拿到可用结果的分钟数,以及每次 API 调用的费用。
我的判断
我认同先定验收条件。页码填满了,金额也可能引用错行。测试用例写得像样,也可能根本没经过空输入分支。把「能查到出处」「预期结果说得清」写进任务,现用模型也能受益,比较时才看得出 Neon 多带来了什么。
56.3% 对应的是模拟应用任务和 xhigh 档位。原文给出了 Zapier 的实测结果,但没有给出作者用两份报价做对照的数据,也没有报告 Neon 在小型代码改动上省了多少时间。按任务大小选模型,仍是基于产品定位的经验建议。对一个只有几项费用的报价,人工核对可能很快。对已有清晰测试入口的小改动,现用模型可能一次就够。只有把核对和补问也计入耗时,才知道换模型能省下多少工夫。
能拿来做什么
- 拿一组已经人工核对过的报价做样本,事先写下每项费用对应的页码、表格行号和确实缺失的字段,再用同一份提示词跑两个模型。
- 用 AI 排查前端表单或 Node 接口的空输入时,先让模型列出实际处理链路和拟改文件,再检查它给的两条测试是否分别覆盖空输入与合法输入。
- 从程序试调
gemini-4-neon时,把补问次数、拿到可用结果的总耗时和每次请求的费用记在一起,用整次任务的数据决定是否换模型。