SageMaker 跨区推理切流的触发条件与实测
SageMaker AI 推理路由器支持将请求分发至跨区域、跨账号的模型端点,并在平台故障、限流或超时后切流,单纯响应慢不会触发迁移。Salesforce 实测中,错误出现约两分钟后备用区域开始接收请求,再过约一分钟承接约 78% 的探测流量。
AI 深度解读
SageMaker AI inference router 想解决一个具体问题:同一个模型部署在多个 Region,本地端点出故障时,怎样把请求交给别处的可用容量。它把跨 Region、跨账户的故障转移做成托管能力,但部署、扩容和数据驻留仍要团队负责。
原文最有价值的是 Salesforce 的测试:响应从 0.2 秒拖到几十秒,路由器仍然不切流;出现错误后才逐步迁移。理解这条边界,才能判断它能替代多少自建网关逻辑,以及哪些可用性问题还得自己处理。
它接管了跨区路由,但没有合并所有容量
据原文,跨 Region 推理路由于 2026 年 11 月 18 日正式可用,覆盖支持 SageMaker AI 实时推理的所有商业 Region。Salesforce 的 Agentforce Foundation 团队在超过 30 个 Region、数百个 AWS 账户中提供模型服务:各地客户的高峰重叠,本地容量可能耗尽,其他地方却还有空闲实例。
过去,他们通过 Internal Gateway 自建健康检查、重试和 Region 切换。问题是网关没有本地及远端端点的容量信号,跨区请求还需要经过 NAT gateway、internet gateway 和公共网络。接收方如果没有流量上限,一次故障转移也可能压垮另一个 Region。
新路由器是客户账户内的区域资源。应用传入 routing target 名称,沿用调用 InvokeEndpoint 时的请求体和 content type。一个 routing target 对应一个逻辑模型,以完整 ARN 列出目的地,可混合 single-model endpoint 与 inference component。不同模型分别配置 target,一个模型的目的地故障不会直接牵动其他模型。
跨账户访问由端点所属账户配置资源策略,授权指定 router 调用,并用条件约束到具体 router。模型所有者保留撤销权限的控制权,调用方无需拿到整个账户的凭据。
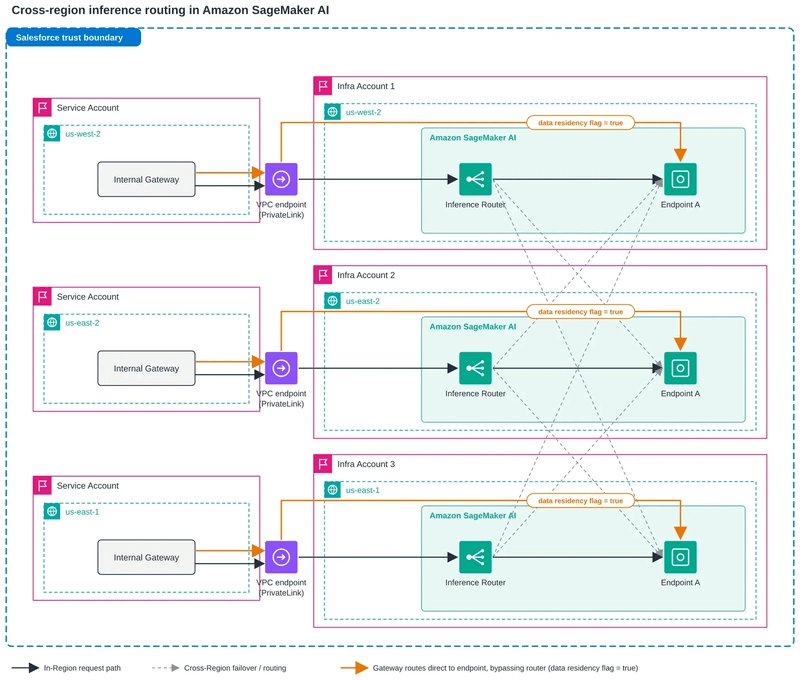
数据驻留仍由网关判断。Salesforce 把带驻留标记的请求送到只有本地端点的 routing target,其余请求才允许跨区。允许哪些请求离开本地,是团队配置的策略,不是路由器自动推断的结果。
为什么慢了几十秒,路由器还是不切流
路由器依据近期请求结果评估健康度:平台故障、模型容器的 5xx、限流和超时会触发逐步分流,通常约一分钟开始,低流量目的地可能需要几分钟。恢复时回流更慢,避免流量来回摆动。
两类情况不触发迁移。无效输入等客户端错误,换个 Region 通常还会失败;单纯响应慢,也可能只是 prompt 长,不能据此认定端点故障。文档还限制了重试范围:只有目的地没有执行模型,例如请求被限流,才允许向另一个目的地重试一次。
Salesforce 先测试了 us-west-2 内的本地路由,再让 us-west-2 的 router 注册另一个基础设施账户内的 us-east-2 端点。上线前,他们调用 DescribeInferenceRouter,确认两个目的地都显示 Routable。
随后,团队压满本地端点,用独立探针观测。约五分钟内,探针 p50 延迟从 0.2 秒升到 45 至 58 秒,但成功返回的慢请求仍被视为健康,流量留在 us-west-2。直到请求超过模型容器 60 秒的 handler timeout、开始返回错误,迁移才启动。
首次错误出现约两分钟后,us-east-2 收到第一批请求;再过约一分钟,约 78% 的探针流量由它承接。仍有 20% 至 25% 留在本地,为路由器提供判断恢复所需的请求结果。这个比例是测试观测值,原文没有把它定义为固定配置。
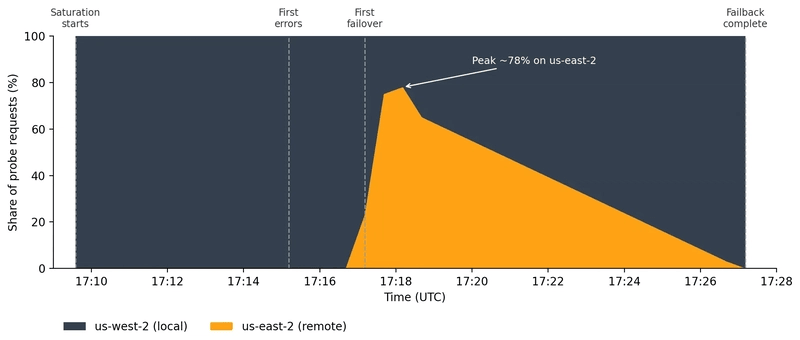
迁移后,p50 回到 0.2 秒,跨区路径增加的 p50 延迟低于 100 毫秒。本地恢复后,流量约用十分钟逐步返回;探针在切换和回切期间没有记录到错误。
这里要区分测量对象:触发迁移的请求出现了错误,独立探针没有报错,二者并不矛盾,也不能据此推导所有业务请求都无损。团队还计划延长饱和测试、以毫秒精度测量跨区延迟,并验证达到流量上限后的级联行为。
切流可以解释,接收方也必须有边界
每次响应都带 InvokedRoutedResourceArn 和 RoutingReason,对应响应头为 X-Amzn-SageMaker-Invoked-Routed-Resource-Arn、X-Amzn-SageMaker-Invoked-Routing-Reason。ARN 包含 Region 和账户,日志可以回答请求去了哪里。
路由原因有四种:local-preferred 表示本地健康且优先;failover 表示本地目的地服务不可靠;capacity-available 表示没有本地目的地能承接;only-healthy 表示只有一个符合条件的目的地健康。
聚合观测通过 OpenTelemetry 指标发布到 router 所在账户和 Region 的 CloudWatch:按目的地统计调用量,使用 error.type 区分 4xx、包含超时的 5xx 及模型错误;destination.duration 记录目的地耗时,overhead.duration 记录路由器自身开销;destination.status 则报告 healthy、overloaded 或 degraded。这些指标可与端点指标放进跨账户看板一起查询。
接收方的边界由 CrossRegionTrafficConfig 控制:设置每实例请求速率,以及远端流量最多占用的端点容量份额,本地流量不计入该上限。达到上限后,端点停止接收其他 Region 的请求,路由器寻找其他目的地。
路由器能寻找可用容量,但容量必须提前部署并留出余量。
每个 Region 都要有一致的模型、容器镜像和 artifacts,否则同一个逻辑模型可能返回不同版本的结果。每个 Region 还要为本地业务与预期溢出流量留出 autoscaling 空间。限额也必须依据真实容量计算,接收方扩容跟不上,仍然会返回自己的错误。
我的判断
这套设计合理的地方,是把故障判断、渐进切流、缓慢回切和审计信息放在一起。相比自建网关,团队有机会减少维护工作;但原文没有提供开发成本、总费用或可用性方面的对照数据,收益幅度仍属于经验判断。
它最大的适用前提,是业务愿意根据错误结果切流。如果接口的体验目标要求几秒内完成,45 至 58 秒后仍成功返回也早已不可接受。此时,仅靠这套健康判断不够,应用自己的超时与降级策略仍然重要。
同样,低于 100 毫秒的 p50 跨区开销,只说明这次测试的中位数表现。原文没有给出 p95、p99,也没有证明其他 Region 组合、模型或请求大小都能复现。已经部署多区模型的团队,更容易获得收益;只有单区部署的团队,首先要承担副本、版本同步和容量冗余的成本。
能拿来做什么
- 如果你用 Node 网关调用 SageMaker,把实际目的地 ARN 和路由原因加入请求日志,先建立请求是否跨区、为何跨区的查询能力。
- 为日常 AI 接口区分响应慢、限流、容器错误和超时,分别设计故障演练,检查客户端等待时间能否覆盖实际切流窗口。
- 为有驻留要求的请求配置仅含本地端点的 routing target,并在网关明确分类规则,让跨区资格可以检查。
- 接入前先核对各区模型版本、容器和 artifacts,再计算可承接的远端流量,用
CrossRegionTrafficConfig限制流入,并验证触顶后的行为。