用 Kiro 规格驱动开发打字训练游戏
作者复刻街机打字游戏,依据错键统计和热力图生成后续训练。项目自述在约 35 小时内,通过 19 份规格、钩子、两个自定义 Agent 和 MCP 服务完成开发,并通过 950 项测试。
AI 深度解读
Dead Keys 把老式街机打字游戏做成了一个训练闭环:记录错键、展示热力图,再围绕薄弱按键生成练习。作者用 Kiro 在三天、约 35 小时内完成项目,交付了 19 份规格和 950 个通过的测试。
但最值得程序员读的,是这些漂亮数字背后的失误:Hook 配好了却从没执行,测试全部通过却做错了界面,首次部署还直接进了生产。它展示了 AI 编程能推进多快,也展示了哪些责任仍得由人承担。
打字游戏为什么还需要 AI,又为什么默认关闭
Dead Keys 复活的是 MasterType(1981)和 Type Attack(1982)的玩法:单词下落,玩家在落地前输入。作者引用的 NCES 数据显示,美国高中毕业生中取得键盘输入课程学分的比例,从 2000 年的 44.1% 降到 2019 年的 2.5%。这是项目的动机,但不能直接证明今天的人更不会打字。
真正让它成为训练器的,是游戏后的反馈。系统统计每个按键的错误,把薄弱项画到键盘热力图,再推荐课程或专项练习。课程共有 14 节,从基准键位延伸到其他区域。演示中的 t、r 是重点练习对象,不过截图来自三轮脚本化热身,不能当作真人训练效果。
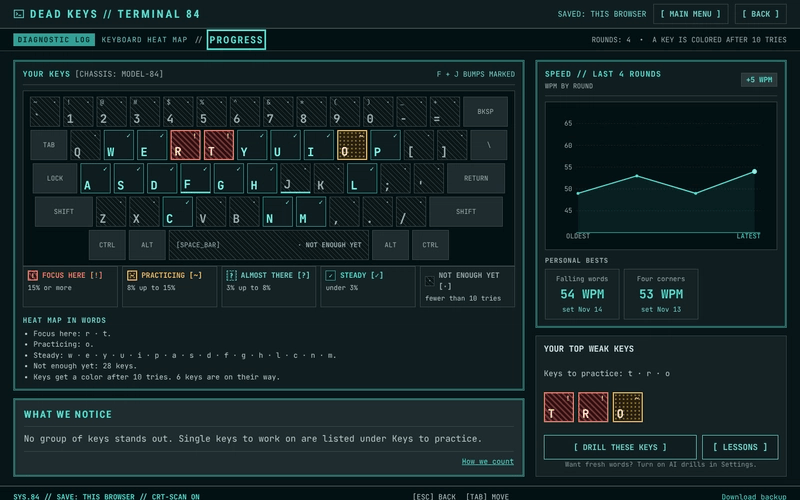
AI 只负责一个有限任务:通过 Bedrock 上的 Amazon Nova Micro,编写针对错键的练习句子。它默认关闭,游戏可以完全不调用模型。
哪些键薄弱,由代码根据计数决定;模型返回的句子也必须通过代码检查,包括字符范围、长度,以及每个单词是否存在于英语词典列表。超时、超过每日限额、输出异常,都会切回内置练习,而且界面会标明来源。
让代码决定练什么,让模型提供练习素材,是这个项目最清楚的职责划分。
不过,词典和长度检查只能保证素材符合部分格式要求。句子是否自然、难度是否合适,以及训练是否有效,原文没有给出评估结果。
规格驱动的价值,是提前暴露决策缺口
作者采用的流程是:先写需求文件,再写设计,最后拆成任务列表,每个任务对应一个文件。Kiro 负责引擎、存储、初期页面、玩法、练习和 MCP server,也从自己的终端执行提交、推送与部署。Claude(Opus 5.5)负责规格、逐块评审,并为了节省 Kiro credits 实现部分后期功能。
仓库里的 .kiro 目录包含 19 份规格、279 行需求、165 个已完成任务、5 个 Hook、5 个 steering 文件和 2 个自定义 agent。这些数字说明流程有记录,但不能单独证明流程有效。
更有价值的例子出现在 Block 1。规格要求遇到不明确的地方先指出来,Kiro 因此提出了十个问题:时间戳采用什么格式,schema version 0 的旧存档能否加载,是否允许存下一百个 ghost,以及没有薄弱按键时是否调用 AI。
作者说,回答花了约五分钟,后续没有为这些问题返工。这是项目经验,缺少对照组;但这些问题确实涉及数据兼容、容量限制和调用条件,拖到实现后再决定通常会牵动更多代码。
问题也可能出在规格本身。
Block 6 的页面出现了标题页键盘问题,以及可访问性和测试缺口,两位评审都建议不通过。更大的偏差却没人检查出来:页面没有按已经确定的设计稿实现。规格只把设计稿列为「参考」,任务和验收条件没有要求对齐。
作者此前做一个单人使用的发票应用时,也遇到过类似情况:八个开发切片和端到端测试都通过,实际使用才发现方案错了。这次他们把修正写进验收:每个页面都要将截图与设计稿并排比较,由作者批准。
测试通过能支持代码符合已写出的要求,不能证明要求覆盖了真实需求。
对前端团队,这尤其关键。设计稿里的视觉层级、交互状态和键盘路径,如果没有进入任务与验收,就容易成为所有人都以为别人会检查的部分。
自动化是否可信,要看它有没有真正失败过
作者设置了一个限制源码文件不超过 150 行的 Hook,原计划每个任务结束后运行。结果它一次都没触发:所选事件来自 Kiro 的任务运行器,而他们是直接编辑任务文件来勾选完成,根本没有产生那个事件。
修复时,他们把触发时机改到 agent 回合结束,再临时加入运行标记,确认每次产生时间戳,并亲眼看到面板中的 Run Command Hook line-cap。验证后才移除标记。
同一天,他们还发现 linter 没有配置文件,一直按默认配置扫描整个仓库,产生的 47 个错误随后被修复。文件存在、命令可用,与流程正确运行,是三件事。
测试方面,属性测试(property-based testing)找到了普通示例没覆盖的问题:极小时间值使每分钟单词数的计算中间步骤下溢为零,最终返回 NaN。Kiro 调整运算顺序后通过测试。他们还故意破坏一条规则,确认测试确实能失败并给出反例,再恢复规则。
Block 15 的 MCP server 则把检查包装成了两个工具:一个校验词包,已验证 1,500 个英语条目和 1,421 个西班牙语条目;另一个运行 AI 黄金测试集。后者会产生费用,必须显式传入 confirm: true。服务拒绝访问词包目录之外的路径,并用测试检查返回内容不包含秘密信息或练习文本。
部署和预算也暴露了边界。作者在全新项目中使用 Vercel CLI,首次部署没有生产参数也直接进入了生产环境。之后他们要求部署前先检查构建,默认保留为预览,生产发布由作者决定。
AWS 访问使用 Vercel OIDC federation 来承担专用 AWS role,不保存长期 access key;AI 练习还有代码级每日限额。但作者承认,这个计数由每个服务实例独立维护,只能近似限流,不能当作跨实例的严格预算上限。
我的判断
我更认可这篇文章对失败的记录,而不是「35 小时、950 个测试」的效率叙事。原文没有传统开发方式的对照,也没有说明规格编写、人工评审等时间如何计入,更没有提供总成本。这些数字适合描述一次交付,不适合推导一般团队的提效比例。
规格驱动也有维护成本。相比直接给 AI 一段任务描述,它能让数据约定、边界和验收更明确;但 19 份规格、多个 agent 和 MCP server,是否比简单的任务文档加脚本更划算,作者没有证明。小项目可以借用方法,不必照搬规模。
作者用自己的工具做了最后检查。Agentis Lux 给出 97/100,仍发现缺少跳转正文链接、两个外链缺少 rel。README Clew 2 在提交 fd6bd7c 上验证了 6 条声明,73 条无法由代码判断,还发现 README 漏列包括 MCP SDK、AWS SDK 在内的六个依赖。没有发现矛盾,不等于所有声明都已证实。
产品本身也有限制:需要实体键盘,目前只支持 QWERTY。菜单、课程、结果和进度支持屏幕阅读器,视觉玩法之外提供无计时练习。两位试玩者和作者自己的检查都曾卡在首个菜单,最终补上了菜单打开后按 Enter 启动 Play。这个小修复,比通过测试的总数更直接地影响用户能否开始使用。
能拿来做什么
- 给 AI 实现前端页面时,把设计稿对应的关键状态、键盘操作和截图对比写进验收条件;不要只留一句「参考设计稿」。
- 在 Node 或前端项目里增加 Hook、lint、部署脚本后,主动制造一次违规输入,确认它会运行、会报错,并且能阻止后续步骤。
- 为 AI 生成功能先建立可校验的输出约束和内置回退,再接模型。像 Dead Keys 一样,把结果来源展示给用户,也方便排查质量问题。
- 给付费模型调用设置代码级限额,同时检查计数是否跨实例共享。如果采用实例内计数,就把它视为近似控制,并在上线前明确这个限制。