Kubernetes Python 客户端将支持原生异步
官方 Python 客户端正计划升级至 OpenAPI Generator 7.20.0,并引入原生 asyncio 和带缓存、自动重连的 SharedInformer。维护者也在重做模型初始化逻辑,改善大集群列举 Pod 或节点时的反序列化耗时。
AI 深度解读
Kubernetes 官方 Python 客户端正在换掉多年失去上游维护的代码生成器,并计划把原生 asyncio、资源事件缓存和新版 WebSocket 流式协议纳入官方库。几项改动瞄准的是 Python 控制面在大集群里遇到的实际问题,从监听断线到一次列举 Pod 就要等 30 多秒。
如果你的前端或 Node 服务背后有一层 Python 在调度训练任务、管理推理服务,这份路线图会影响下一次依赖升级。读它时可以分清三笔账:请求如何并发、控制器如何获取资源状态,以及数据到了客户端之后还要花多久才能用。
为什么先换掉生成 40 万行代码的工具
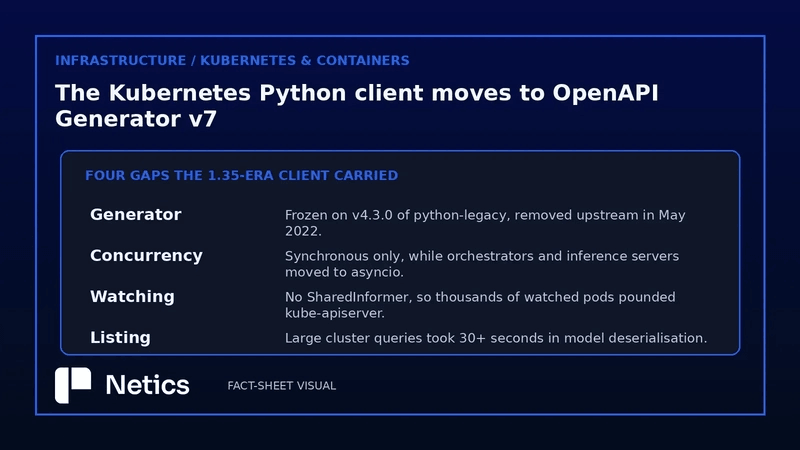
截至 Kubernetes 1.35,官方 Python 客户端仍在用 OpenAPI Generator v4.3.0 的 python-legacy 模板,生成约 40 万行 API 和模型代码。生成器负责把 Kubernetes 的 API 描述转成 Python 能调用的方法,以及表示 Pod、Node 等资源的数据对象。v4.3.0 在 2020 年被弃用,并于 2022 年 5 月从上游移除。客户端继续依赖这套工具链,新版 Python 上也积累了 DeprecationWarning。
Google Cloud 工程师与开源贡献者把目标定在 OpenAPI Generator v7.20.0,并计划持续跟进后续上游版本。按 Google 的说法,早期迁移卡在模板和 schema 的变动上,牵涉数百个 API 模型。同一处生成规则会作用于许多资源类型,所以升级需要分批落地。协作在 SIG API Machinery 下公开进行,生成器相关工作在 kubernetes-client/gen,团队可以在每两周一次的分诊会上提出自己的用例。项目优先处理 AI/ML 生产场景里的高影响问题,范围也据此取舍,完整追平 client-go 超出了此次路线图。
异步请求和资源缓存,各自解决什么问题
官方库的原生 asyncio 支持,瞄准的是 FastAPI 控制面、异步任务编排器和 notebook。等待 Kubernetes API 响应时,事件循环可以继续处理其他协程。此前,团队可以用官方同步客户端,也可以采用社区异步分支 kubernetes-asyncio,或选用 kr8s、lightkube 等第三方客户端。原生支持多给了一条维护路径,但原文没给出正式可用的客户端版本,也没说明这些替代库的调用能迁移到什么程度。
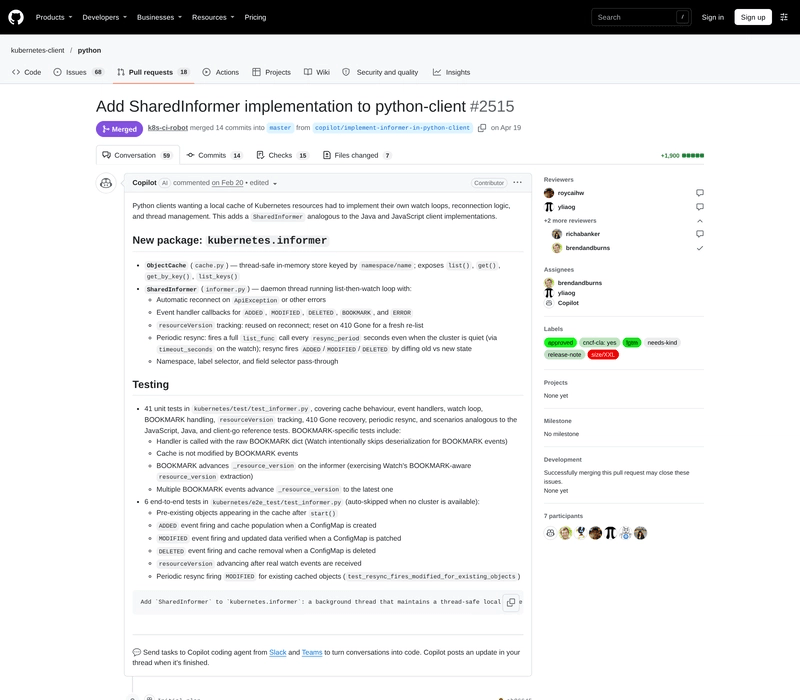
SharedInformer 处理的是另一层问题,相关工作见 PR #2515。它用 list-watch 先取资源快照、再接收后续变化,把状态维护在本地缓存里。控制器可以从缓存里读取当前状态,用 on_add、on_update 和 on_delete 响应资源变化,断线时由客户端负责自动重连。当控制器要反复查看成千上万个训练 Pod 时,这种模式有机会减少全量列举请求,降低 kube-apiserver 的负担。原文没有给出能减少多少请求的实测。
还有一项改动会直接影响平台工具。Kubernetes 的远程命令流式传输正从 SPDY 转向 WebSockets,Python 客户端对应补上 WebSocket v5 channel 支持,使用 v5.channel.k8s.io 子协议。原文给出的线索是 PR #2486 和 KEP-4006。内部平台如果提供容器终端、日志之外的进程交互或端口转发,升级时就要覆盖 exec、attach 和 port-forward,普通资源查询通过只能验证其中一部分。
列举 Pod 花 30 多秒,慢在哪一段
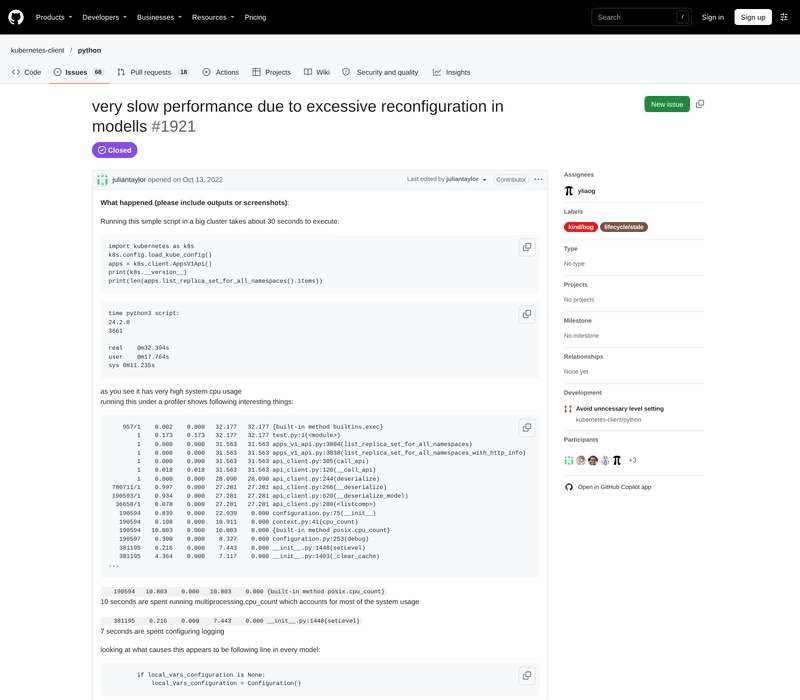
issue #1921 记录了一个具体案例。在大集群里,Python 客户端列举 Pod 或 Node 可能耗时 30+ 秒。按原文描述,开销出在反序列化环节。客户端解析 JSON 并构造 Python 模型时,生成的代码会反复创建并重新配置 schema 校验对象。一个列表返回的资源越多,模型初始化的重复开销就越容易拖长自动扩缩容、任务状态检查或控制器调谐的周期。Google 计划借 v7+ 模板重做模型初始化,原文没有给出改造后的耗时。
传输层还有一笔独立的账。原文说,客户端基于 urllib3 的传输层受限于 HTTP/1.1,缺少 client-go 可用的 HTTP/2 多路复用和流量控制。前者允许多条请求流共享连接,后者控制数据发送速度。此次公告里的性能改造落在模型初始化上。评估时可以把服务端响应和下载、客户端解析和构造对象分开计时,否则一个总耗时很难告诉你升级究竟改善了哪一段。
我的判断
这份路线图里证据最具体的是旧生成器的维护历史,以及 issue #1921 里的慢查询案例。前者解释了为什么一次工具链升级会牵涉大量模型,后者给了团队一个能在自己环境中测量的问题。原文还援引了 5 万节点的环境、超过 7,500 个 GitHub stars,以及 PyPI 每月超过 7,300 万次、每天约 170 万次的下载量。两组下载数字按自然月直接折算对不上,原文也没交代统计窗口。下载量适合用来理解依赖的覆盖面,无法估算有多少生产集群遇到了这些问题。
对常驻控制器,我会先看它是否反复全量列举同一批资源。频繁读取时,SharedInformer 的本地缓存更贴近问题。低频运维脚本继续按需请求,省去了维护本地缓存的复杂度。已经用社区异步库稳定运行的 FastAPI 服务,也有理由等到官方版本可用,再用同一批调用比较错误处理、断线恢复和迁移成本。原文没有提供这些对照数据,减少分支维护和降低 API 请求量是有机制支撑的工程判断,收益还得看实际负载。
能拿来做什么
- 给 Python 控制面固定客户端版本,评估下一次升级时按 changelog 确认可用能力。前端或 Node 平台依赖容器终端和端口转发的话,把实际的
exec、attach、port-forward流程放进升级验证。 - 排查训练任务列表慢时,用相同的资源范围和返回条数复测,把 Kubernetes API 响应与下载耗时、Python 客户端解析耗时分别记下来。这样能判断 v7+ 模板的模型改造是否对得上自己的瓶颈。
- 如果后台控制器在循环里反复列举同一批 Pod,记录当前的请求量和状态更新延迟。等 SharedInformer 在目标版本可用后,用相同负载验证初始同步、断线重连,以及增改删事件能否正确反映到平台状态。