五个容器争抢机械盘,重启后连续报 502
Proxmox 更新重启后,五个容器同时从一块 5400 转机械盘冷启动,数据库初始化和迁移等任务加剧了磁盘争用。I/O 等待升至 87%,前置 Caddy 持续返回 502,约 15 分钟后仪表盘才开始响应。
AI 深度解读
宿主机打完补丁重启,AI Agent 的仪表盘大约 15 分钟才处理第一笔请求,期间 Caddy 一直返回 502。服务在 systemd 里显示 active,端口却没人监听。作者最后查到,五个容器正在争用同一块 5400rpm 机械盘。
停掉负责链路追踪的 Langfuse 容器后,仪表盘在 21 秒内恢复。这个案例最值得记住的是,遇到重启后的 502,怎么判断上游是在等磁盘,以及该暂停哪个容器才能让关键服务先起来。
服务显示 active,为什么还接不了请求?
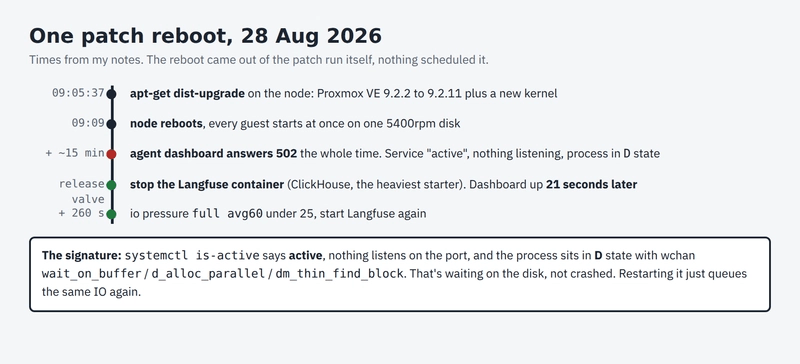
2026 年 8 月 28 日 09:05:37,作者按既定的补丁流程运行 apt-get dist-upgrade,将 Proxmox VE 从 9.2.2 升到 9.2.11,并装入新内核。09:09,补丁流程触发宿主机重启。五个容器同时冷启动,系统根分区所在的 13.4G Optane 虽然快,但容器数据全在另一块 931.5G、5400rpm 的机械盘上。启动时最重的两路负载,一路是 Langfuse 里的 ClickHouse,另一路是打印机监控容器里的 MariaDB 和正在执行的 python manage.py migrate。
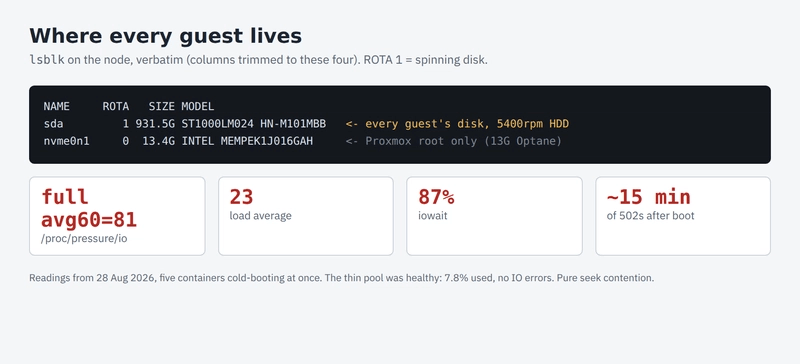
当时 /proc/pressure/io 的 full avg60=81,表示过去约 60 秒内,所有非空闲任务同时被 I/O 卡住的时间占比很高。系统平均负载到了 23,iowait 达到 87%。作者查到 thin pool 只用了 7.8%,日志里也没有 I/O 错误、device-mapper 或 ext4 故障。几路启动任务同时读写不同位置,机械盘的磁头得来回寻道,这足以解释当时的阻塞。
更直接的线索在进程身上。systemctl is-active 返回 active,只说明 systemd 认为服务处于活动状态,应用是否已绑定端口得另查。作者看到进程处于 D 状态,也就是不可中断睡眠,/proc/<pid>/wchan 显示 wait_on_buffer、d_alloc_parallel 或 dm_thin_find_block 等内核等待点。结合当时的 I/O 指标,这组信号指向磁盘等待。此时重启服务,启动所需的读写还得重新排队。
先暂停哪个容器,才能让关键服务起来?
作者停掉了跑 ClickHouse 的 Langfuse 容器,因为它只负责追踪,当时没有服务依赖它在线。仪表盘在 21 秒后恢复。作者等了 260 秒,看到 /proc/pressure/io 的 full avg60 降到 25 以下,才重新启动 Langfuse。另一个重负载容器则继续运行,因为它正在执行 Django 数据库迁移,中途终止会给恢复增加风险。
这台机器的容器都设了 onboot: 1,最终也都能自行起来。重启一分钟后看到个别容器仍是 stopped,可以先复查状态和存储压力,再决定是否手动介入。
慢启动还会暴露哪些隐含依赖?
作者给 Agent 网关配了 systemd watchdog,定时器用 OnBootSec=2min 在启动两分钟后触发。但那次 root 的用户管理器还没建好 /run/user/0,脚本执行 systemctl --user 时收到 Failed to connect to bus。作者把脚本改成最多等待用户总线 60 秒,必要时主动启动 user@0.service,并让失败路径以退出码 0 结束。对应的 systemd drop-in 也通过 After= 和 Wants=user@0.service 声明了启动顺序和依赖。另一个受影响的是容器内的 systemd-journal-flush.service,它在 90 秒后超时,使容器进入 degraded。等 I/O 压力回落后,执行 systemctl restart systemd-journal-flush 清除了这个状态。
修 watchdog 时,作者还踩了脚本传输的坑。heredoc 依次经过 ssh、pct exec 和 bash -lc,最终文件里留下了字面的 \$(seq ...),触发语法错误。后来改成本地写好文件,用 base64 -w0 编码,通过管道传到目标端解码,再用 bash -n 检查语法,最后才启动单元。
我的判断
这次排查最扎实的地方,是把代理的 502、上游端口、进程等待点和宿主机压力接起来看。暂停 Langfuse 后服务很快恢复,也为 I/O 争用的判断提供了现场证据。不过原文只有一次处置记录,没有重复冷启动的对照,也没给出换 SSD 或错峰启动后的数据。21 秒是这次操作后观察到的恢复时间,full avg60 低于 25 是作者当时采用的恢复条件,两个数字都属于这台机器上的经验。
错峰启动能减少开机时的并发读写,换 SSD 则直接缓解机械寻道的瓶颈。能否照搬「先停追踪」取决于服务依赖。作者的 Langfuse 可以短时离线,数据库迁移则需要继续跑。在团队环境里,同样是可观测性组件,也要先确认业务请求是否同步依赖它。
能拿来做什么
- 内部 AI 工具在宿主机重启后持续返回 502 时,先查上游端口是否监听。若服务显示
active、进程却处于D状态,再对照/proc/<pid>/wchan和宿主机的/proc/pressure/io,确认卡在哪一层。 - 给自托管环境的启动顺序标出可延后的组件和正在改写数据的任务。确认追踪链路可以短时中断后,再考虑暂停它,为前端依赖的 API 和数据库腾出 I/O。
- 在一次计划内的补丁重启中验证 watchdog,检查用户总线尚未就绪时脚本怎么处理,并从反向代理发一次真实请求,确认上游已经能够响应。