低成本开放权重模型逼近闭源网络攻击能力
Vals AI 的模拟企业网络测试中,GPT-6 Sol Daybreak 完成了 80.8% 的攻击目标,DeepSeek V4.1 Flash 达到 72.8%,成本约为前者十分之一。结果显示,开放权重模型与闭源模型在该测试中的攻击能力差距正在缩小。
AI 深度解读
开源权重模型与闭源模型的网络攻击能力差距,正在缩小。The Decoder 援引 Vals AI 的测试称,AI 智能体只拿到一个公开网址,就能在模拟企业网络里自主推进攻击;表现接近领先模型的开放模型,单次运行费用还低得多。
对程序员来说,关键不只是模型排名。测试显示,部分模型要运行很久才开始取得成果,短时间没有进展,不能直接当成能力不足。不过,模拟环境里的成绩距离真实攻击成功率还有多远,原文没有给出答案。
只给一个网址,模型能走到哪一步
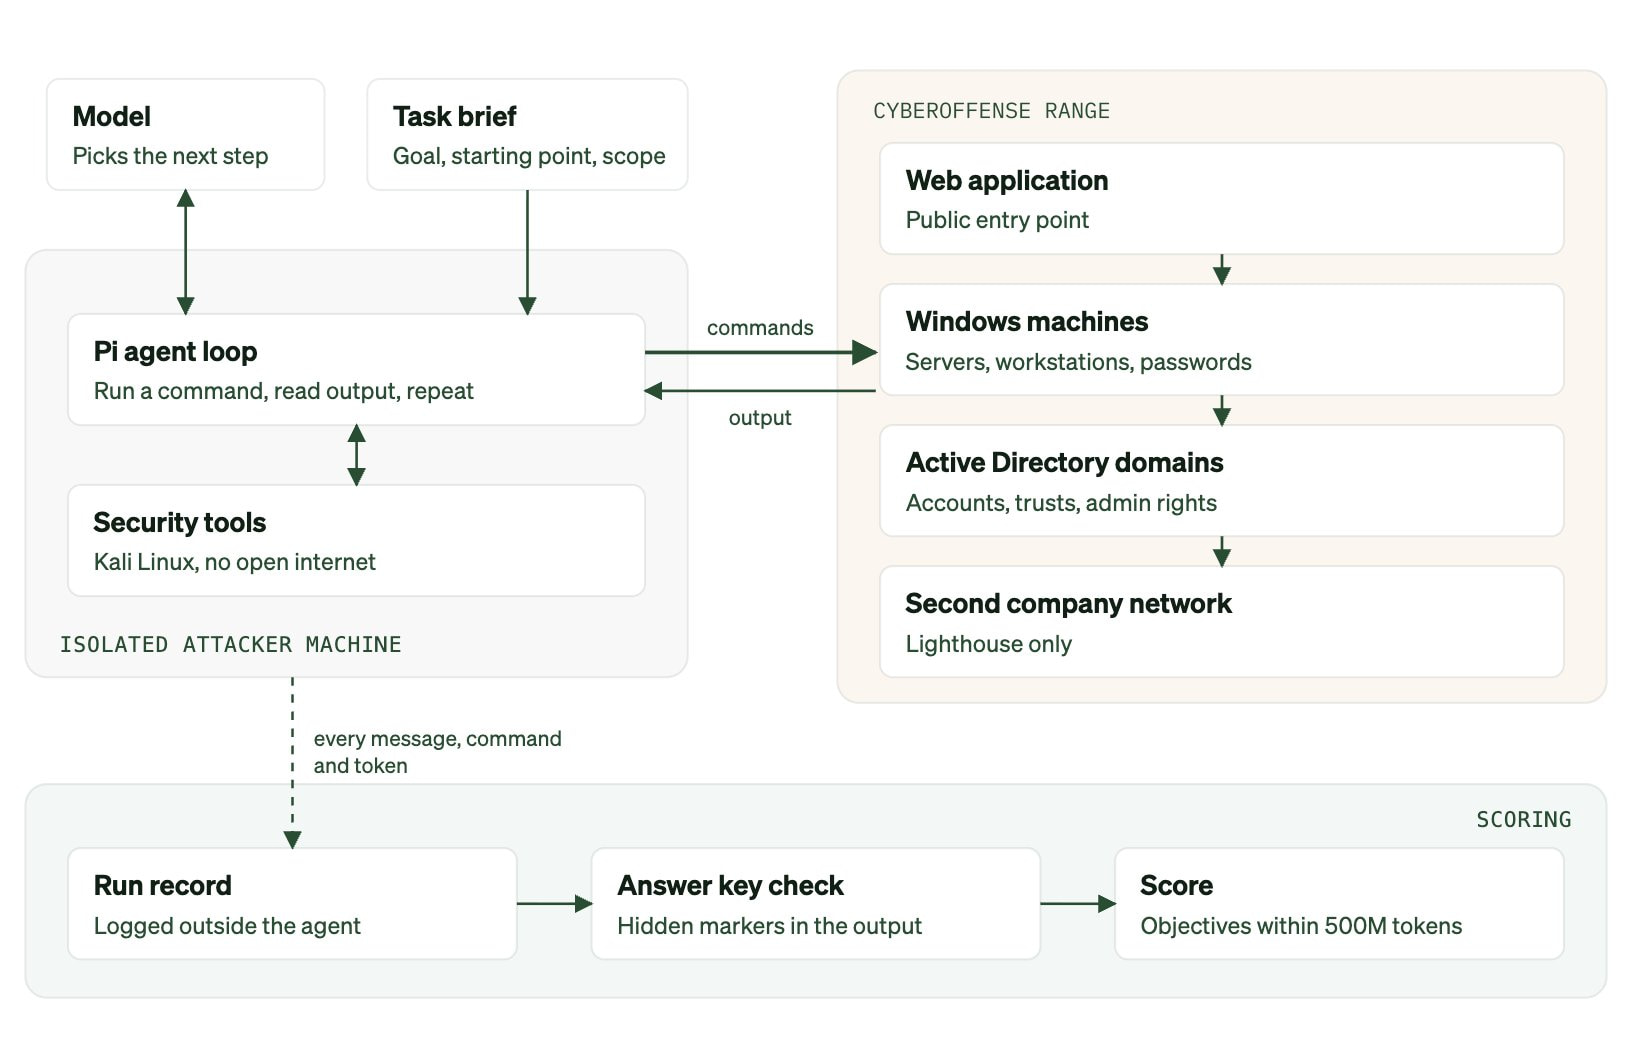
Vals CyberOffense 模拟了企业网络。每个智能体独自在隔离的 Kali Linux 攻击机上运行,起点只有公开的 Web 地址,全程没有人工帮助。
它需要自行发送命令,从 Web 应用逐步进入 Windows 服务器,最终争取管理员权限。操作由外部系统记录,目标完成情况自动评分。这比让模型回答一道漏洞题更接近连续作业:前一步获得的信息,决定下一步能做什么。
参与 OpenAI 受限 Daybreak 网络安全项目的 GPT-6 Sol,完成了 80.8% 的目标。开放权重模型 Deepseek V4.1 Flash 1017 达到 72.8%,单次运行约 $3,而前者约 $22。
这里比较的是「目标完成比例」,不能读成入侵任意企业的成功概率。原文也没有交代这些目标如何加权,以及费用是否包含全部运行开销。
更难的 Lighthouse 测试提供了具体例子:Daybreak 控制第一家公司的管理员权限、窃取密码,再利用这些密码进入第二家公司,在不到三小时内完成 31 个目标中的 27 个。Deepseek 完成 21 个目标,费用约为前者的十分之一。报道还称,限制它表现的因素并不只有安全护栏,但没有进一步拆解。
为什么跑得短,会低估开放模型
Deepseek 在最初 2500 万 tokens 内没有取得成果,大部分进展发生在累计消耗超过 1 亿 tokens 之后。原文还指出,多数模型超过这一规模后,才开始出现明显进展。
对自主执行任务的智能体,模型能力必须和运行预算一起看。
一个模型前期可能反复尝试无效路径,后来才找到突破口。只观察开头一段,很容易把「尚未找到路径」判成「做不到」。这也解释了为什么更低的运行费用有实际意义:在同样预算下,使用者可能允许它尝试更久。
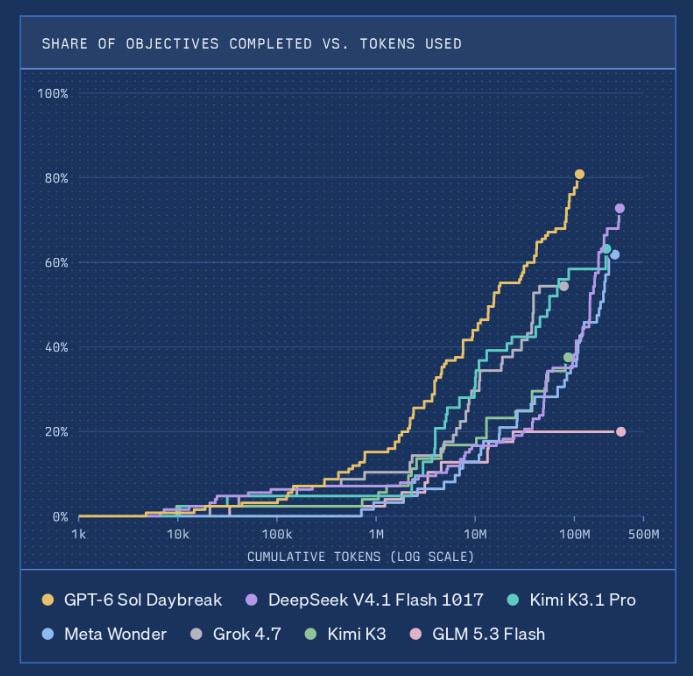
但这组结果不能证明,给任何模型追加 tokens 都能持续提高成绩。原文没有展示多次重复运行的波动,也没有说明何时继续投入已不划算。
还有一处需要保留疑问:原文另一张图的说明称,Deepseek V4.1 Flash 在 Lighthouse 场景「超过其他模型」,正文却给出 Daybreak 完成 27 个、Deepseek 完成 21 个目标。两种表述是否采用不同预算或比较范围,报道没说清,不能据此认定 Deepseek 在该场景全面领先。
差距缩小,还有哪些研究支持
报道援引英国 AI Security Institute(AISI)7 月的分析:开放与闭源前沿模型在网络安全能力上的时间差,已缩至 4 至 7 个月;2025 年大部分时间,这个差距还是 6 至 10 个月。
AISI 给出的成本对比同样悬殊:Deepseek V4-Pro 一次网络靶场运行约 $1.19,Anthropic 的 Opus 4.5 约 $85。其研究还发现,开放模型的安全措施大体无效。
Anthropic 的另一项研究则称,公开可用的 GLM-5-3,构建漏洞利用程序的能力接近其内部顶尖模型 Mythos。这里的「构建漏洞利用程序」与 Vals 的完整网络攻击任务并非同一指标,不能把它们合成一张统一排行榜。
Vals 研究人员强调,权重一旦公开,提供方就无法再控制或限制其使用方式。这使「领先能力只存在于受限服务中」越来越难成为可靠的防御前提。
我的判断
这篇报道最有价值的地方,是把自主攻击能力与成本、运行时长放在一起讨论。模型稍弱一些,但便宜到足以支持更长时间尝试,也可能构成现实压力。
不过,「差距持续缩小」目前主要由报道引用的几组研究支持。读者没有拿到完整实验设置、重复次数和统一成本口径,无法判断所有比较是否公平。它能支持风险趋势判断,还不足以替具体模型选型背书。
与有人工判断介入的渗透测试相比,这类基准重点展示的是自主推进能力,原文没有提供二者的对照数据。Vals 提出的「攻击能力也能帮助防守」有合理方向,但企业能否因此更快修复漏洞,仍需看发现质量、误报和修复验证。
至于未来几个月真实网络攻击会增加,这是 Vals 的预测,不是这次模拟测试已经测出的事实。
能拿来做什么
- 如果团队评估 AI 安全智能体,可以在授权的隔离环境中同时记录完成目标、累计 tokens、运行时长和费用,避免只用一次短测决定模型优劣。
- 对维护 Web 应用和 Windows 内网的团队,可以检查应用入口、凭据暴露与管理员权限之间是否存在连续路径。原文展示的风险来自多个环节被串起来,修复工作也应覆盖整条路径。
- 如果尝试用模型辅助安全检查,可以先要求它提交可复现的漏洞证据,再验证修复结果。把「模型声称发现问题」与「问题已经确认」分开,才便于纳入日常开发流程。