Terra API 测评聚焦视觉与结构化输出
文章围绕 gpt-6.1-terra 的图片理解、桌面操作步骤规划和 JSON 输出展开测试,并列出百万级上下文等参数。材料称其定位偏速度与成本,复杂编程仍建议选择 Sol 或 Astra,但摘录未展示具体测试结果。
AI 深度解读
GPT-6.1 Terra 能不能接进现有项目,原文给出的答案是:兼容 OpenAI 的调用代码通常只需调整 base_url 和 model。但接通接口只是起点,作者实际检查的是截图识别、桌面操作规划、JSON 提取和短文生成。
这些单次测试都得到了可用结果,却不足以证明模型适合生产。对前端和全栈开发者,更有参考价值的是测试方法:把任务拆成能核对的字段和步骤,再判断模型输出能否进入下一道流程。
接口容易迁移,模型定位还得分清
原文称,OpenAI 于 2026 年 10 月 26 日发布 GPT-6.1 Terra,API 模型 ID 为 gpt-6.1-terra,接替 GPT-5.6 Terra,定位是 GPT-6.1 家族的中档模型,侧重速度、成本、图像理解、计算机操作和写作。
按原文的产品划分,Luna 面向轻量批处理,Sol 面向更复杂的任务,Astra 则是最高档。复杂编程仍推荐 Sol 或 Astra。因此,不能因为 Terra 能识别界面,就进一步推断它适合承担复杂代码修改。
作者实际测试走的是第三方 Crazyrouter,端点为 https://api.crazyrouter.com/v1,请求路径是 /chat/completions。下面这段代码用于验证 SDK 调用,作者报告它返回了 HTTP 200:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CRAZYROUTER_API_KEY"],
    base_url="https://api.crazyrouter.com/v1",
)

resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Beschreibe die Einordnung von GPT-6.1 Terra in drei Sätzen, ausschließlich auf Basis dieser Fakten: OpenAI hat GPT-6.1 Terra am 26. Oktober 2026 veröffentlicht. API-Modell-ID: gpt-6.1-terra. Schnell und günstiger, Schwerpunkt Bildverständnis, Computerbedienung und Schreiben. Nachfolger von GPT-5.6 Terra."}],
)
print(resp.choices[0].message.content)
要看清 base_url 那一行:这是第三方兼容接口的实测,不能直接当作 OpenAI 官方端点的验证结果。密钥通过环境变量 CRAZYROUTER_API_KEY 读取。
作者还提醒检查响应里的 usage,其中分别记录 Prompt、Completion 和 Reasoning Tokens。按输出字数估算开销会漏掉推理部分。不过,原文没有给出实际 Token 数和账单,所谓「更便宜」还不能从这组测试中得到量化验证。
截图识别要核对字段,桌面操作要核对结果
图像测试使用了一张深色轨道动画截图:中央有发光主体,六个带标签的点分布在轨道上,左上角有 FPS 和速度显示,底部有按钮及滑块。
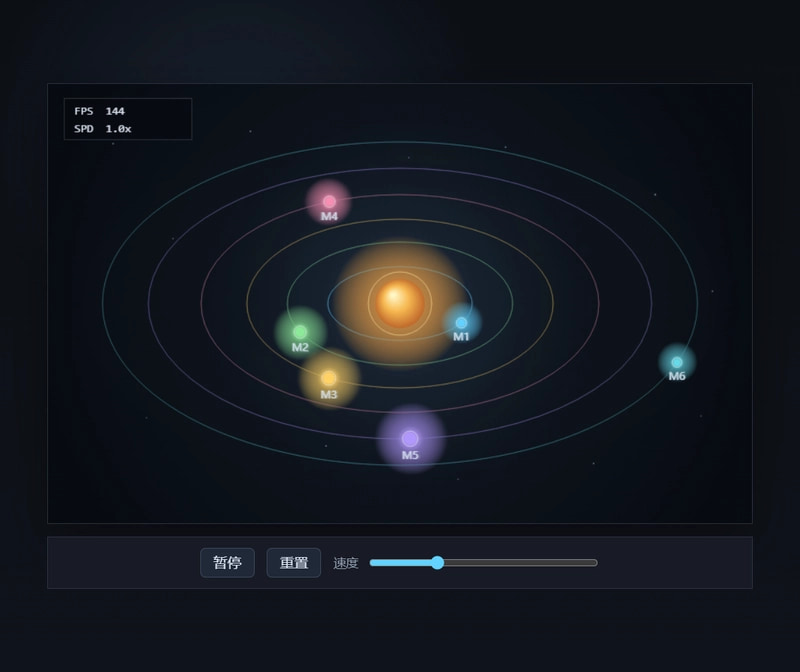
作者逐项对照后认为,模型识别对了中央主体、六个标签及其颜色、两个显示值、按钮文字和滑块位置。这个检查比「描述得挺像」更有价值,因为每一项都有原图可以核验。
但它依然只有一张截图,无法说明模型遇到小字、遮挡、弹窗或其他布局时是否稳定。作者也建议,重要字段写入数据库前仍要抽查。
桌面操作测试则揭示了另一个边界:模型能规划操作,不等于它已经完成操作。
在开启数据共享的任务中,模型给出三个步骤:点击隐私标签页,点击 toggle_share,检查开关是否开启。遇到覆盖文件的对话框时,目标是保留旧文件并另存新文件,模型选择了「另存为」,命名为 report_v2.pdf,还要求确认原文件未被修改。
这说明该次输出考虑到了任务约束。真正的点击、对话框识别和错误处理,仍由执行层负责。作者建议,覆盖、删除和支付操作应要求人工确认;一次合理的规划,并不能替代执行过程中的保护措施。
JSON 能解析,只完成了第一层检查
在结构化提取测试里,作者要求返回一个 JSON 对象,包含模型 ID、发布日期、定位、输入与输出模态、上下文窗口和最大输出。作者报告,返回结果包含全部字段,类型也正确,可以直接解析。
这里有两层检查:能解析,说明 JSON 语法成立;符合 JSON Schema,才说明字段和类型满足约定。即使两层都通过,字段内容是否真实仍需另行核对。
原文没有展示这次响应,也没有给出上下文窗口和最大输出的具体数值,因此不能据此补齐模型规格。它验证的是一次提取结果,尚未提供长期运行中的字段遗漏率或解析成功率。
写作测试同样比较克制:作者提供发布日期、模型 ID 和产品定位,模型据此生成简短新闻导语,覆盖了要求的信息。作者把它视为草稿,语气和超出来源的陈述仍需人工检查。
我的判断
我认可这篇的任务拆法:截图按元素核对,操作计划包含结果检查,JSON 再加 Schema 校验。对日常 AI 编程,这些方法比一句「模型很强」更容易复用。
但它的证据强度需要降一档看。作者明确说了,每项都是单次调用,没有基准测试,也没有 Terra 与 Sol 的对照数据。识图准确率、延迟、成本和危险操作下的稳定性,都还没有可比较的结果。选型建议目前属于经验之谈。
原文转述 OpenAI 称,Terra 的计算机操作能力在其内部测试中接近 GPT-6 Astra,但没有展开测试条件。这个说法不能替代作者自己的验证。
其他限制也会影响接入:原文称,发布时不支持微调,ChatGPT Chat、免费套餐和 Go 套餐不在支持范围,部分功能受地区限制;输出仅有文本,不提供音频或视频。超长请求还可能跨过上下文阈值,产生额外费用,但阈值和价格没有写清。持续累积历史的 Agent 循环尤其需要单独算账。
这篇足以提供一套试用方法,还不足以替团队完成模型选型。
能拿来做什么
- 给前端截图识别准备一批真实样本,列出按钮文字、数值、颜色和控件位置,让 Terra 与 Sol 使用相同提示词,再比较字段准确率。
- 在 Node 提取流程中,把 JSON 解析、Schema 校验和内容核对分开处理;校验失败的结果进入重试或人工检查流程,再决定是否入库。
- 做桌面 Agent 时,让模型输出操作计划,由执行层负责点击和状态检查;把
toggle_share是否开启、原文件是否保留写成明确的完成条件。 - 决定接入前记录
usage、耗时和实际费用,覆盖长对话样本;复杂编程任务仍需单独比较 Sol 或 Astra,不能沿用截图测试的结论。