腾讯 Hy4 支持图像理解与自主操作软件
腾讯发布多模态模型 Hy4,支持图像理解和自主操作软件,在 Artificial Analysis Intelligence Index 中获得 35 分。腾讯同时承认,该模型在高难数学与复杂图像分析方面仍明显落后于领先商业模型。
AI 深度解读
腾讯发布 Hy4,把图像理解、软件操作和专业任务处理放进了同一个模型。它既能从巨幅航拍图里寻找屋顶部件,也被用于游戏开发、金融分析和训练流程优化。对程序员来说,值得看的不是又一张排名表,而是这些能力能否接进真实工作。
原文给出的结论有两面:Hy4 在独立综合评测中位居中国模型第二,但距离顶尖商业模型仍有明显差距;腾讯强调搜索后的低幻觉率,独立测试却暴露了它在不知道答案时容易编造的问题。两组结果并不矛盾,关键在于测试条件。
能看图、能操作软件,离完成开发任务还有多远
Hy4 正式版距离预览版约两个月,腾讯称训练数据显著增加。当前可通过 Tencent Cloud、OpenRouter 和元宝等应用使用,权重将在之后发布,具体日期未定。因此,腾讯所说的跻身最强开放权重模型之列,目前还不能通过下载权重自行验证。
新增能力首先是图像理解。演示中,Hy4 面对一张 62,500 × 45,000 像素、约 2.8 gigapixel 的航拍图,通过代码生成局部裁剪,寻找屋顶上约两米大小的部件。
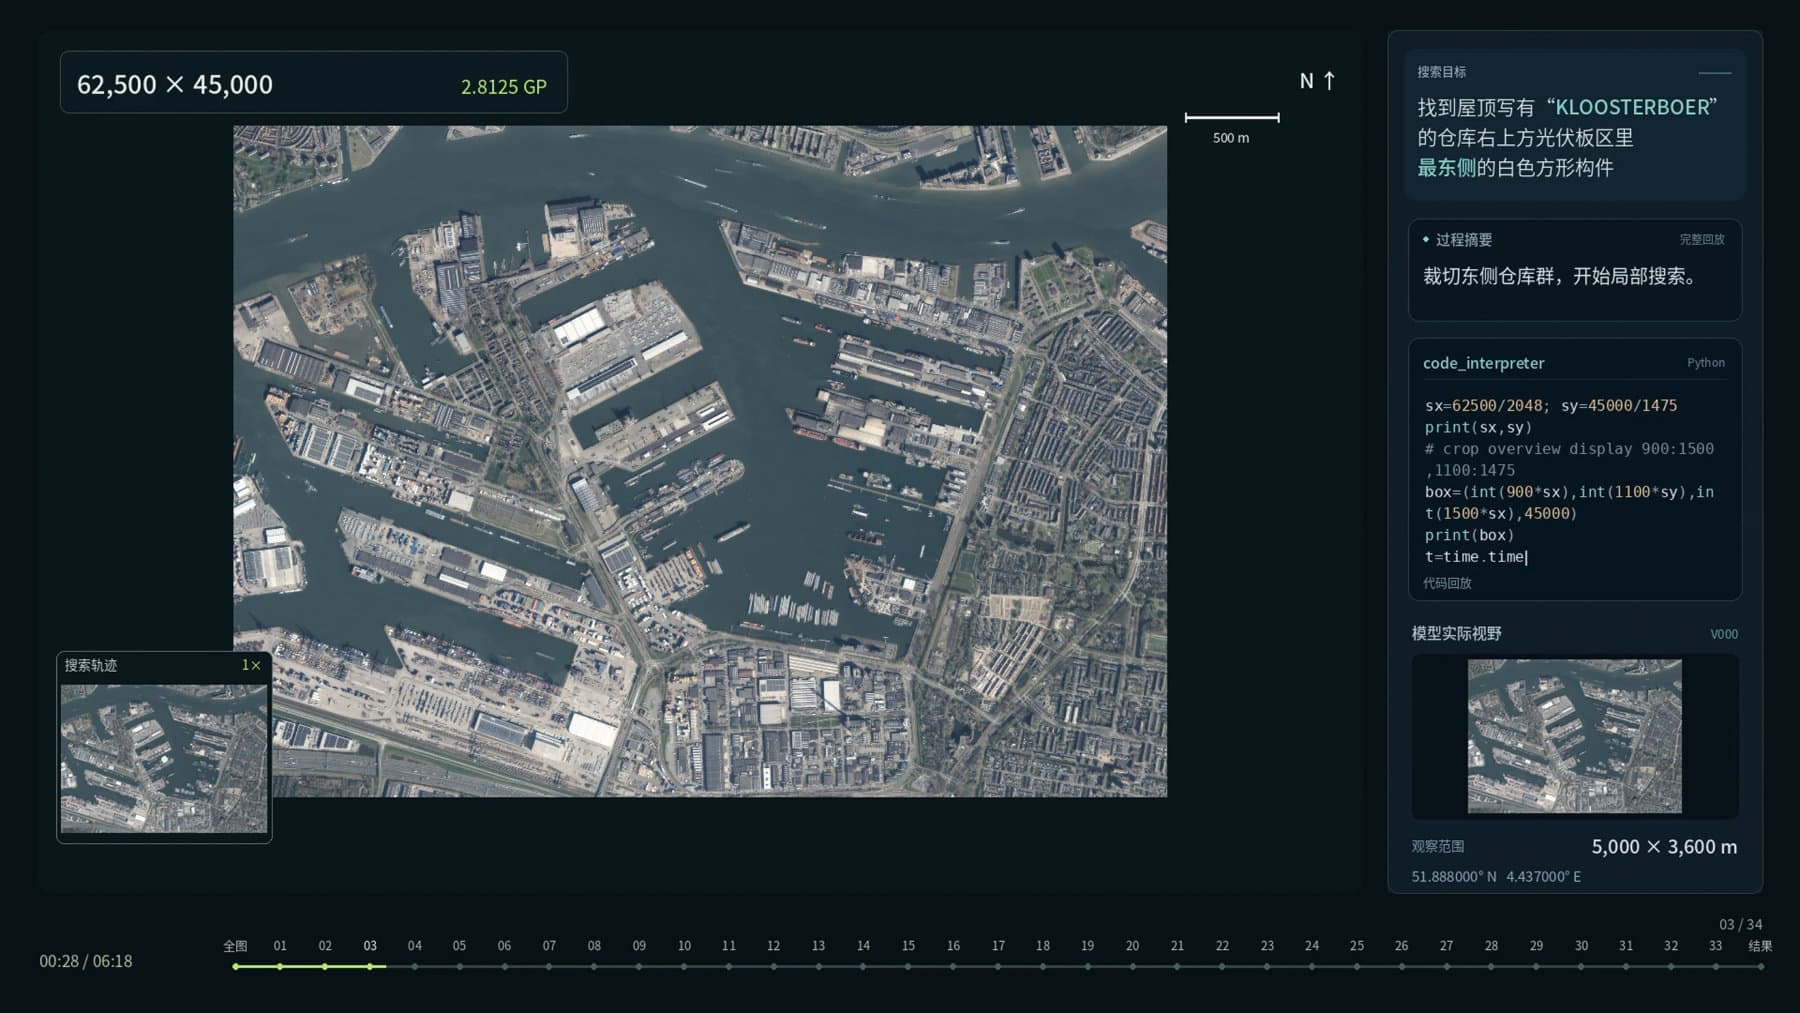
这个案例的价值在于处理方法:先用工具缩小搜索范围,再检查细节。它展示了模型与代码协作的能力,但单次演示不足以证明复杂图像任务的普遍准确率。
另一项新增能力是计算机操作,也就是让模型控制软件界面、执行步骤。腾讯针对 Blender、CAD 和跨应用任务做了训练;游戏开发则覆盖 Unreal、Unity、Godot,并与内部游戏工作室合作适配。《王者荣耀》开发团队称,Hy4 的配置任务接近全部完成,定位缺陷根因的表现也明显改善。
这些是具体业务反馈,但原文没有给出任务数量、成功标准或人工介入次数。尤其要区分:配置修改完成得好,不等于能独立承担长期项目。腾讯自己也承认,长周期编码和复杂图像分析仍是短板。
国内第二,为什么不能直接变成选型结论
Artificial Analysis 的 Intelligence Index 综合考察知识工作、编码、科学和通识。Hy4 得到 35 分,高于 30 分的中位数,与 Grok 4.7 持平;在中国实验室模型中,仅次于 46 分的 Kimi K3.1 Pro。
但腾讯的金融测试给出了不同排序。超过 200 名金融从业者评估了近 600 项真实任务,Hy4 排在 Deepseek V4.1 Flash、Kimi K3.1 Pro 和 GLM-5.3 Flash 前面。
综合能力和特定业务能力测的不是同一件事,排名发生变化并不奇怪。问题在于,读者不能拿金融任务的胜出,推导出编码也更强。腾讯自己的十二项评测中,Claude Opus 5.5 全部领先 Hy4,GPT 6.1 Sol 则在八项中领先,项目包括 ProgramBench、Terminal Bench 4.0 和 OSWorld 2.1。
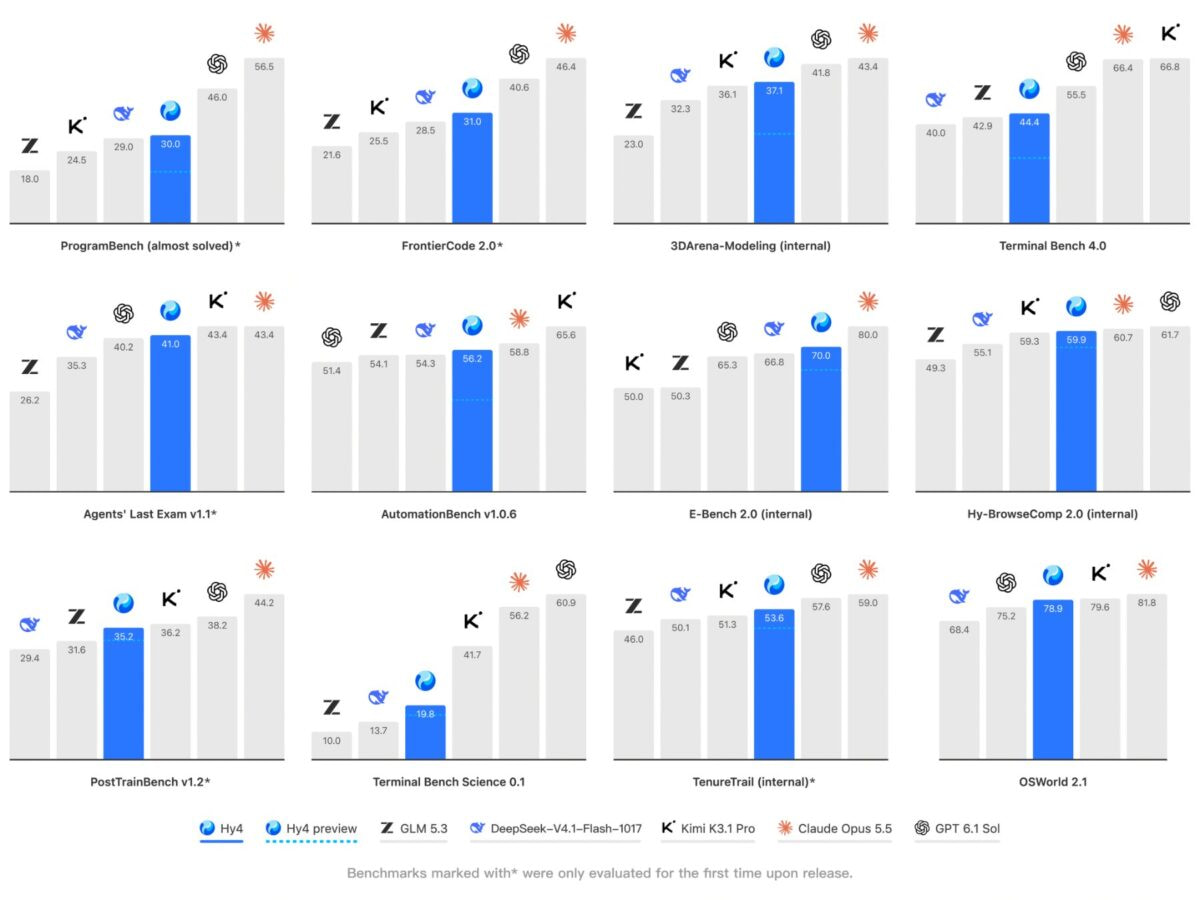
困难任务上的差距更明显:Hy-FrontierMath T5 中,Hy4 为 13.0 分,GPT 6.1 Sol 为 97.5 分,Claude Opus 5.5 为 91.3 分。
成本也要放进来。Hy4 延续预览版价格,每百万输入 tokens 约 0.83 美元,每百万输出 tokens 约 2.50 美元。但在 Artificial Analysis 的测试里,与它表现大致相当的 Haiku 5.5,单任务成本接近其一半。每百万 tokens 的报价,不能直接代表完成任务的成本。
原文还提醒,Artificial Analysis 在 10 月下旬调整了指数,60% 来自私有测试集,开放模型与领先模型的差距从 3 分扩大到 12 分。评测口径变了,跨版本比较也要跟着调整。
搜索幻觉降到约 5%,为什么仍要核查答案
腾讯称,改进搜索功能后,内部测试的幻觉率从接近 16% 降到约 5%,并支持与人实时协作处理 Word、Excel、PowerPoint 文件。
但关闭搜索后,独立测试呈现出另一面。在 AA-Omniscience 事实准确性测试中,Hy4 依靠训练知识答对约一半问题;遇到不知道的答案时,有 89% 的情况选择编造,而不是承认不知道。
这里有两个分母。89% 针对的是不知道答案的情况,不能读成全部回答中有 89% 错误;约 5% 则来自腾讯带搜索能力的内部测试,也不能推广到所有使用场景。
对日常 AI 编程,这个区别很实用。模型能搜索文档,不代表回答里的 API、参数和兼容性结论就自动可靠。检索结果是否支撑结论,仍需要检查。
合作伙伴的反馈同样要看来源。金融平台 Comein 在内部数据查询测试中,将 Hy4 与 Claude Opus 5.5 并列第二,并称其明显领先 GPT-6.1 Sol;Manus 则报告文档任务几乎全部成功。这些材料能说明应用方向,却缺少足够的公开方法和对照细节。
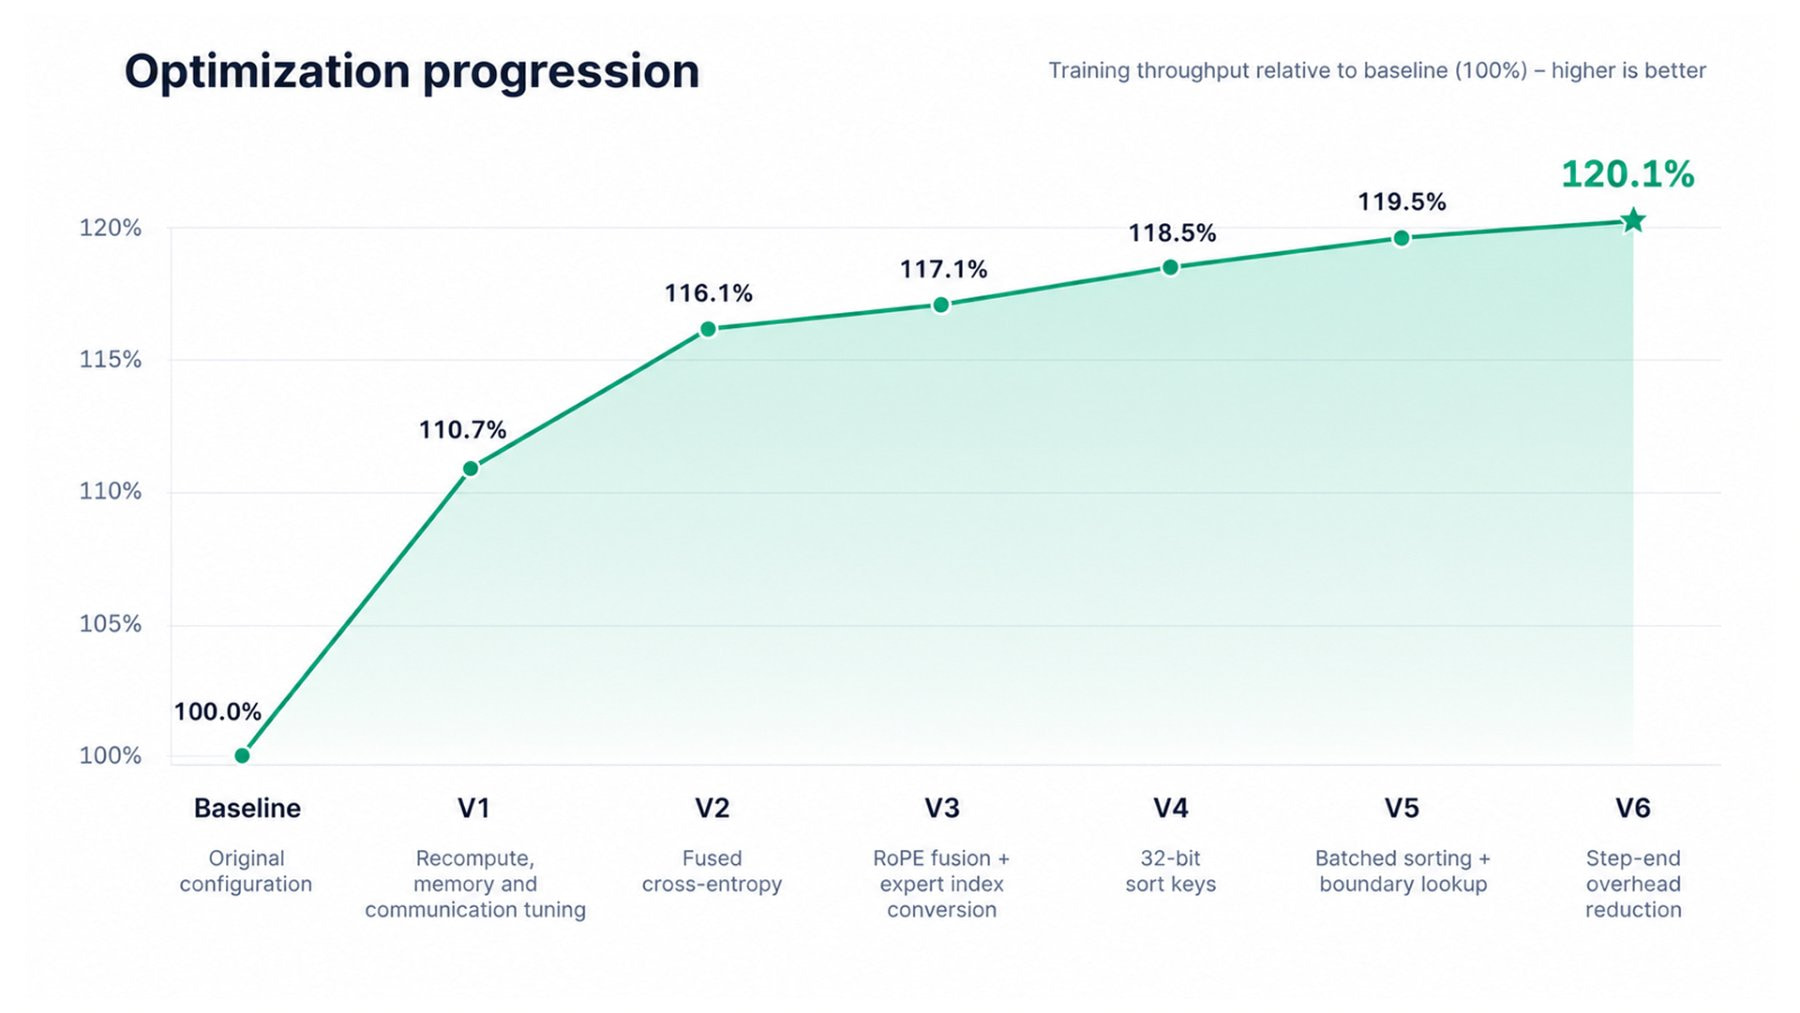
腾讯还把 Hy4 用在模型研发上。它与代理执行系统 Hyra 2.0 配合,在六步优化中把内部训练吞吐量从基线 100% 提升到 120.1%,约增加 20%。
腾讯称,Hy4 在涵盖七个领域的内部研究测试中位居开放可用模型第一,还独立训练了 TypeSafe AI 决策模型 Jev 的变体 Hyra-Jev,在八项基准中的六项胜出,并将发布由此产生的生物学和物理学专用开放模型。
这说明它开始参与研发流程,但没有证明模型能持续自主改进自身。原文对部分测试名称、资源投入和人工参与程度没有交代清楚。
我的判断
我认可 Hy4 的产品方向:把看图、调用工具、操作软件和专业任务结合起来,比只提升聊天表现更贴近工作。但现有证据更适合支持「进入候选名单」,还不足以支持「直接替换现有模型」。
金融、办公和游戏配置的成绩,大多来自腾讯及合作伙伴内部评测。它们有业务参考价值,缺少完整对照数据的部分仍应按经验反馈看待。涉及长项目编码、困难数学或高准确性知识问答,独立结果和腾讯自认的短板都要求更谨慎。
开放状态也需要说准。前代 Hy3 去年 7 月以 Apache 2.0 许可发布,参数量为 2950 亿,这不代表 Hy4 会采用相同许可。腾讯计划随权重发布安全报告,目前关于过滤黑客相关材料、未发现更高滥用风险、生物风险低于内部阈值的说法,均来自公司自身。
原文提到,10 月公布的出口管制框架草案拟覆盖全球前十或超过两万亿参数模型的权重,并为开源发布设置自动批准的快速流程。它仍是草案,不能据此推断 Hy4 的发布时间。更快、更便宜的 Hy4 flash 也只是后续计划。
能拿来做什么
- 做前端或游戏开发选型时,可以拿现有页面截图、配置修改和已知缺陷测试 Hy4,分别记录结果是否正确、是否需要人工修复,以及完成任务的费用。
- 做 Node 或日常 AI 编程时,对模型给出的依赖版本、API 和参数回查官方文档,尤其别把搜索场景下约 5% 的幻觉率套到离线回答上。
- 评估软件操作能力时,选一条能验收结果的真实流程,同时记录失败和人工接管步骤;只看最后生成了文件,很容易高估自动化程度。
- 如果计划本地部署,先等待 Hy4 权重、许可和安全报告公布,再判断部署条件,当前可先通过云端渠道验证任务适配性。