用大模型为 Kubernetes 日志做初诊
作者在 EKS 上用定时任务每隔十五分钟读取错误日志,调用 Bedrock 模型分析后将诊断发送至 Slack。方案结合 Fluentd 和 OpenSearch,尝试自动完成重复错误归纳与排查方向整理。
AI 深度解读
Log Doctor 想解决的,是告警之后最耗耐心的一步:从几百行重复报错里,找出主要故障、可能原因和排查入口。作者用一个每 15 分钟运行的 Kubernetes CronJob,把 OpenSearch 中的错误整理后交给 Amazon Bedrock,再将诊断发到 Slack。
这套方案的价值在于边界清楚:程序负责查询、计数、裁剪和脱敏,模型只负责解释。作者用模拟故障跑通了流程,但演示也留下一个关键问题:模型给出的合理解释,距离经过验证的根因还有多远?
为什么先聚合日志,再让模型开口
告警能告诉你错误率超过了 5%,日志搜索能返回大量 ERROR,但两者之间还缺一次整理:哪些错误重复最多,哪些可能相关,先查哪里。
作者把这一步交给约 500 行 Python 实现的 Log Doctor。数据链路是:
orders-api / payments-api → Fluentd → OpenSearch → Log Doctor (CronJob) → Amazon Bedrock → Slack
两个 FastAPI 服务向 stdout 输出 JSON 日志,Fluentd 在每个节点采集日志并补充 Kubernetes 元数据,写入每日索引 app-logs-YYYY.MM.DD。CronJob 每次查询过去 15 分钟的错误,没有错误就不发消息。
关键选择发生在模型调用之前。作者没有直接塞入几百行日志,而是让 OpenSearch 按服务、错误消息分组,返回次数、首次和最后出现时间,以及最近样本:
"aggs": {
    "services": {
        "terms": {"field": cfg.service_field, "size": cfg.max_services, "missing": "(unknown)"},
        "aggs": {
            "messages": {
                "terms": {"field": cfg.message_field, "size": cfg.max_messages_per_service},
                "aggs": {
                    "first_seen": {"min": {"field": cfg.timestamp_field}},
                    "last_seen": {"max": {"field": cfg.timestamp_field}},
                    "samples": {
                        "top_hits": {
                            "size": cfg.samples_per_message,
                            "sort": [{cfg.timestamp_field: {"order": "desc"}}],
                            "_source": {"includes": SAMPLE_SOURCE_FIELDS},
                        }
                    },
                },
            }
        },
    }
},
要看的是三处 size:默认最多 10 个服务,每个服务 5 类消息,每类 2 个样本。模型收到的是「这类错误出现了 25 次」,不用自己数日志。
Python 随后继续裁剪:堆栈只留最后 12 行,整个提示词最多 16,000 字符;超限时先删样本,再删整个服务,并说明省略了什么。maxTokens 另行限制回复长度。
先把证据整理成有上限的输入,再让模型解释,是这套设计最值得借鉴的部分。
但这些限制也会丢信息。出现次数少的错误可能更接近故障起点,动态 ID 也可能把同类消息拆成多个分组。原文没有说明消息归一化方式。作者强调聚合提供真实计数,但仅凭这段代码,也不能认定所有分布式 terms 查询的计数都绝对精确。
日志里的文字,为什么不能当成指令
日志可能包含用户输入。攻击者写入的一段文字,会经过日志系统进入提示词,再影响发到值班频道的内容。
作者做了三层处理:提示词构造前脱敏;系统提示明确要求忽略日志中的指令;发送 Slack 前转义控制字符,避免日志里的 <!channel> 触发全员提醒。
脱敏规则覆盖 AWS Access Key、Bearer Token、常见秘密字段、邮箱和 Slack webhook:
_REDACTIONS = [
    (re.compile(r"AKIA[0-9A-Z]{16}"), "[REDACTED_AWS_KEY]"),
    (re.compile(r"(?i)bearer\s+[a-z0-9._\-]+"), "Bearer [REDACTED]"),
    (re.compile(r"(?i)(password|passwd|secret|token|api[_-]?key)\s*[=:]\s*\S+"), r"\1=[REDACTED]"),
    (re.compile(r"[A-Za-z0-9._%+\-]+@[A-Za-z0-9.\-]+\.[A-Za-z]{2,}"), "[REDACTED_EMAIL]"),
    (re.compile(r"https://hooks\.slack\.com/\S+"), "[REDACTED_WEBHOOK]"),
]
要留意第三条规则:它只能匹配预设字段和格式,无法保证识别所有秘密。作者也承认,正则和系统提示都不完美。
更强的约束来自权限设计:模型没有工具,也没有集群凭证,只能生成文本。AWS 访问由工作负载通过 IRSA 获取 IAM role,信任策略绑定具体 service account;CronJob 的角色只允许调用指定模型。
这里的「没有 AWS keys」不等于没有秘密。Slack webhook 仍是能向频道发消息的凭证,通过 SLACK_WEBHOOK_URL 进入 Kubernetes Secret,不写入仓库。
OpenSearch 位于 VPC 内,只接受签名 IAM 请求。作者选择 IAM-only access policy,省掉主用户和角色映射配置,但 Fluentd 通过 /_bulk 写入,索引名位于请求体,所以其角色可以写任意索引。需要按索引限制写权限时,仍要使用 fine-grained access control。
跑通一次,需要验证哪些环节
作者使用 Terraform 1.6 或更高版本,并要求安装 envsubst,macOS 对应 brew install gettext。账户需要 Paid plan、目标区域访问权限,以及创建 IAM OIDC provider 的 iam:CreateOpenIDConnectProvider 权限;AWS Organization 的 service control policy 也可能阻止创建。
示例区域是 ap-south-1,节点为 t3.medium。部署前先用 aws sts get-caller-identity 核对账户,再通过 aws ssm get-parameter 获取 AMI,用 aws ec2 run-instances --dry-run 检查启动权限。
模型检查同样分两步:aws bedrock list-foundation-models 配合 --by-output-modality TEXT 和 ON_DEMAND 筛选,再用 aws bedrock-runtime converse 发起真实请求。列表里有模型,不代表账户能调用。
作者选择 openai.gpt-oss-20b-1:0,测试设置为 --inference-config '{"maxTokens":800}'。它返回的 reasoning blocks 也占用 maxTokens,程序只保留文本块。部分模型使用以 global. 或 apac. 开头的跨区域推理配置,可能被单区域策略阻止。第三方模型首次使用还可能触发 AWS Marketplace 订阅,因此作者先用管理员身份调用。
基础设施通过复制 infra/terraform.tfvars.example 配置,再执行 make infra-up 创建。作者设置 cluster_endpoint_public_access_cidrs = ["<your-ip>/32"],共创建 67 个资源,实测耗时 23 分钟,其中 OpenSearch 约 14 分钟,EKS 控制平面略超 8 分钟。kubectl get nodes 的示例版本为 v1.36.5-eks-6e7947a,这些都是该次部署结果。
之后运行 make build-push、make slack-secret、make deploy 和 make status。镜像目标是 linux/amd64,Apple Silicon 用户若构建成其他架构,Pod 可能出现 exec format error。
CronJob 使用 concurrencyPolicy: Forbid 避免任务重叠,设置 backoffLimit: 0 避免重试重复发消息。Bedrock 失败时,它仍发送原始消息及计数摘要,然后以退出码 1 结束,让失败 Job 留下记录。
演示通过 make simulate-errors 制造 44 次错误:orders-api 有 25 次数据库失败和 4 次 NoneType 错误,payments-api 有 12 次超时和 3 次数据库失败。等待 Fluentd 刷新 30 秒后,make dry-run SKIP_LLM=1 检查模型输入;make dry-run 调用模型但不发送;make run-now 执行完整链路。
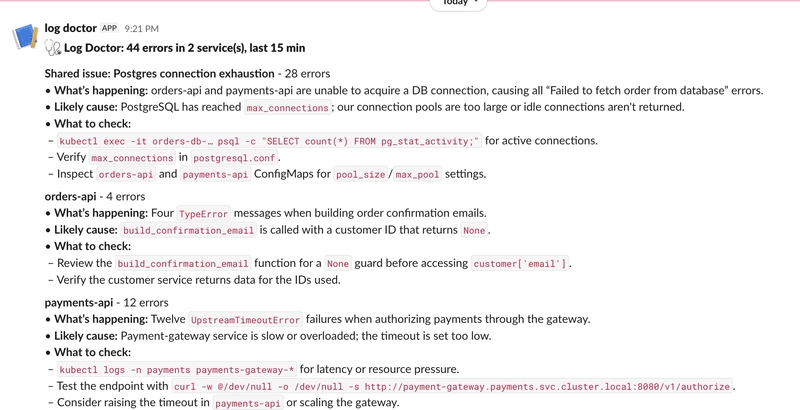
模型把两个服务的数据库错误关联到连接耗尽,并建议检查 pg_stat_activity、连接池参数和空值处理。不过,这只能证明流程能生成解释,不能证明它已经找到真实系统中的根因。
我的判断
我赞成把 AI 放在日志整理之后。与直接提交原始日志相比,这样更容易控制输入、复查证据,也能减少重复内容。与拥有集群操作权限的 Agent 相比,这个只输出文本的组件更容易引入现有值班流程。
但诊断应当作为待验证的排查假设,不能直接变成操作指令。
演示里的 orders-db、payment gateway 都来自模拟场景,模型建议执行的 kubectl exec、kubectl logs 或 curl -v,未必对应实际存在的资源。增加 max_connections、延长超时或启用重试,也需要结合容量和故障机制判断。误导性消息仍可能把值班人员带偏。
作者没有提供人工排查耗时对照、诊断准确率或真实事故样本,也没有给出具体成本数字。输入上限能限制单次模型调用规模,不能证明包含 EKS、OpenSearch、NAT 等资源的总账单有明确上限。每 15 分钟扫描一次,也更适合补充告警,承担不了所有紧急故障的响应需求。
能拿来做什么
- 已有 OpenSearch 的团队,可以先按服务和消息做聚合,保留次数、时间范围和少量样本,再评估 AI 摘要是否减少了阅读负担。
- 给 Node 或全栈服务接入类似流程时,先统一结构化日志字段,并检查动态参数是否把同类错误拆散,避免聚合结果失真。
- 将
make dry-run SKIP_LLM=1和make dry-run这样的分阶段验证保留下来,分别检查输入是否完整、脱敏是否生效,以及模型是否编造资源和因果关系。 - 复现实验后执行
make infra-down清理资源;正式使用前,再补上通知去重、漏报检查和费用观测,验证它是否适合自己的值班流程。