用握手埋点排查语音应用连接卡顿
文章针对 AI 语音应用卡在连接阶段的问题,将 WebSocket 握手记录为阿里云 RUM 自定义资源,观测结果、耗时与受影响环境。结合端云链路关联,可继续定位对应的服务端处理环节。
AI 深度解读
AI 语音一直停在「Connecting」,不一定是模型慢,也可能连音频上传的通道都没建好。原文给出了一条排查路径:用 Alibaba Cloud 的 Cloud Monitor 2.0 RUM 记录每次 WebSocket 握手,再关联服务端 trace,把用户的等待定位到连接、网关或鉴权环节。
它真正值得借鉴的是采集口径:一次连接怎么算、什么时候停止计时、取消是否算失败。口径不统一,监控接得再全,也可能把排查方向带偏。
模型指标正常,为什么用户仍然等不到回复
原文的场景是一副智能眼镜:眼镜负责录音和播放,手机 App 通过 WebSocket 连接云端语音服务。用户按下语音按钮,App 却一直显示连接中,偶尔重试又能恢复。
服务端模型指标正常,常规 API 监控里也找不到对应失败,并不矛盾。问题可能发生在连接建立阶段,此时音频还没发出去,模型自然没有异常可记录。
示例使用 ASR、Agent、模型和 TTS 串联的级联语音架构。WebSocket 承担持续上传音频、接收结果和处理打断所需的双向通信;实时多模态模型可能合并其中一些阶段,但连接仍然是排查入口。
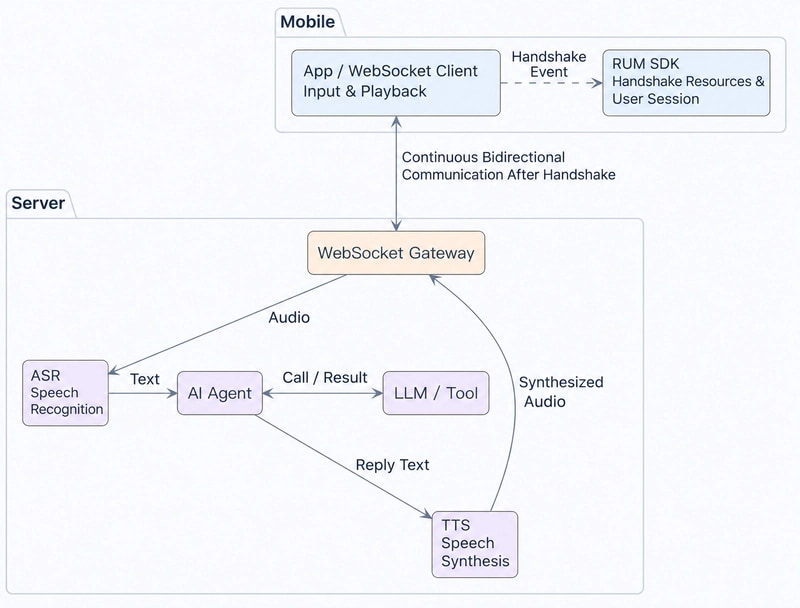
第一步还不能直接查握手失败。要先确认这次语音操作是否发起了新连接,如果复用了已有连接,就不该期待出现一条新的握手记录。
假设找到的握手结果是 403,可以把问题缩小到握手被拒绝,接下来检查服务端握手处理。但 403 只能证明请求被拒绝,不能单独证明签名过期。
普通日志同样能记录 403。RUM 的额外价值,是把它放回用户会话和操作中,结合 App 版本、设备、网络环境判断故障是否集中。它帮助回答的是「哪些用户受影响」,而不只是「发生过一次错误」。
一次连接只报一次,计时才有意义
原文把握手建模为 HTTP/1.1 Upgrade:从发起连接开始,到第一个终态结束。终态包括连接打开、失败,以及客户端主动终止。
这里测的是建立连接用了多久。连接存活时间、消息传输耗时、AI 对话轮次,都不计入握手耗时。
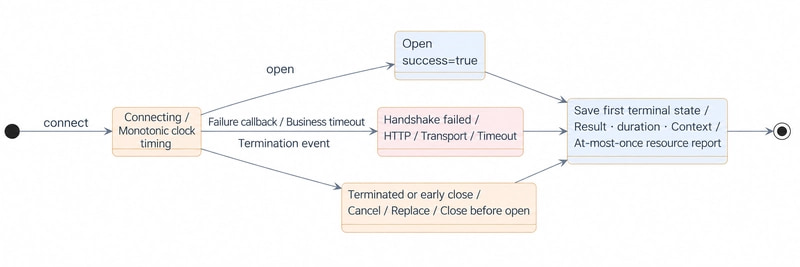
每次连接尝试最多上报一条握手资源。 已经 open 后发生断开或失败,不再补报握手;重连则开启新的尝试。replaced 只表示尚未结束的旧尝试被新尝试替代,不能拿它统计所有重连。
实现上的难点是,取消、超时、系统失败回调可能接连触发,甚至并发到达。原文建议让它们汇入同一个完成函数,只接受第一个结果,统一停止计时并上报。
取消前还要保存原因。用户退出页面和业务超时,都可能最终触发底层取消回调,但前者属于客户端主动终止,后者应该归为超时。只看系统回调,区分不出来。
几个字段也不能混用:
- 资源类型使用
websocket,示例请求方法为GET。 - 收到 101 后仍可能因为 Upgrade 校验失败进入失败回调,因此以
open确认握手成功。 statusCode为-1表示没有可用的 HTTP 响应,不能直接判定为网络故障,也不能在这里填 WebSocket close code。- 错误分类是作者约定的口径,不是产品固定枚举。
Android 的 OkHttp 示例在终态去重完成后,通过下面的调用上报:
// resourceUrl is the redacted address; measuring records the duration of this handshake, in ms.
AlibabaCloudRum.reportCustomResource(
    "websocket", resourceUrl, "GET", statusCode, errorMessage,
    success, "OkHttp3", traceContext, measuring);
要注意 measuring:它记录的是本次握手耗时,单位为 ms;traceContext 则来自这次握手请求使用的上下文。
iOS 的 URLSessionWebSocketTask 对应调用如下:
// resourceURL is the redacted address; measure records the duration of this handshake, in ms.
_ = AlibabaCloudRUM.setCustomResource(
    "websocket", success: success, url: resourceURL, method: "GET",
    statusCode: statusCode, errorMessage: errorMessage,
    provider: "URLSessionWebSocketTask", tracing: traceContext, measure: measure)
这里要注意 tracing: traceContext 与实际请求保持一致。两个片段都只是上报入口,终态去重、取消原因和计时逻辑仍需在调用前处理,原文没有给出完整实现。
找到握手记录后,怎样继续追到服务端
RUM 记录连接结果和用户环境,trace 补充服务端处理证据。两者关联的前提,是 Upgrade 请求与 RUM 资源携带相同的 traceparent。
网关提取上下文后,需要创建自己的 span。假设传入的是 trace-id=T、parent-id=A,网关应记录 trace-id=T、span-id=B、parent=A。也就是沿用同一条链路的 trace-id,同时用自己的 span ID 表示当前操作。
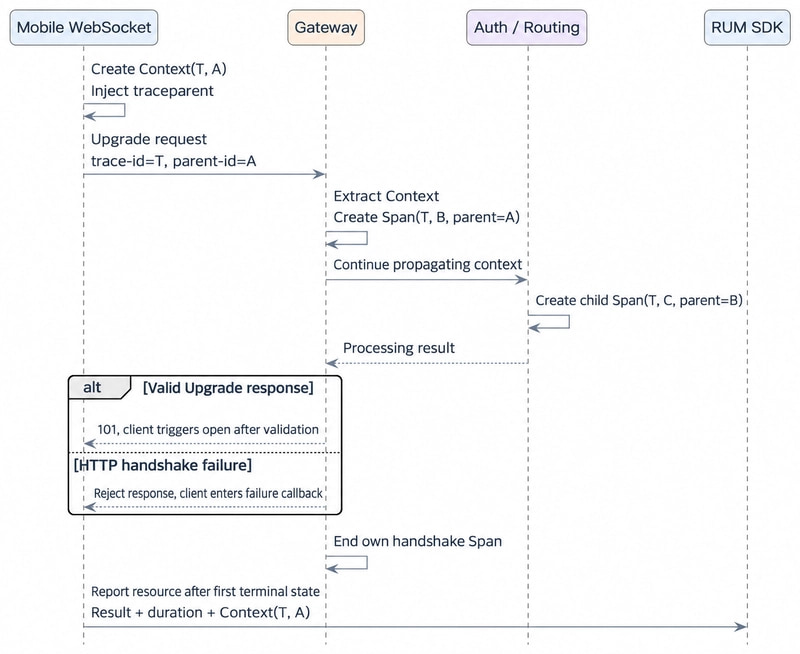
上下文负责提供关联标识,span 才提供耗时、状态和调用关系。服务端已经接入 tracing、控制台关联配置生效之后,才能从握手记录追到实际采集的网关与鉴权处理。只在客户端多传一个字段,不会自动补齐服务端证据。
如果后续诊断指向签名过期,再查凭证刷新、签名有效期和设备时间,并针对受影响版本或环境回归。原文给的是条件性排查路径,没有展示足以独立验证结论的完整诊断材料。
统计同样要守住口径。原文将成功率定义为:成功次数除以上报了终态的总尝试数,cancelled、replaced 保留在分母,另列占比。如果另算排除主动放弃的技术成功率,只能剔除已确认的业务主动终止,超时和原因不明的取消仍要保留。
耗时分位数则应按成功、失败、客户端主动终止分别计算,未知原因单列。否则大量快速取消可能把混合 P95 拉低,掩盖成功连接正在变慢的问题。采集范围、采样和时间窗口也必须注明,因为统计覆盖的是已上报记录,不能默认代表全部用户尝试。
我的判断
我认同它把排查起点前移到握手,以及用统一完成函数收敛回调。这两点不依赖特定监控平台,也能直接改善日志和指标质量。
RUM 的优势在于把连接结果与会话、版本、设备等信息放在一起,适合调查用户环境差异。已有结构化日志和 trace 的团队,也可以先补连接尝试标识、终态和取消原因。是否值得再引入 RUM,要看现有系统能否方便地回答影响范围,而不是看能不能记录一个 403。
文章没有给出接入前后的定位耗时、误报率、采样覆盖率或开销对照,也没有展示具体的环境聚合结果。因此,这是一套有工程合理性的实施建议,还不能当作效果已被数据验证的案例。
对前端开发者还要划清适用范围:示例针对移动端 OkHttp 和 URLSessionWebSocketTask,不是浏览器 WebSocket 的完整接入教程。状态采集和去重思路可以借鉴,具体如何传递上下文,需要按目标客户端确认,不能直接照搬这两个 API 调用。
能拿来做什么
- 给语音 App 的「连接中」补一条独立的连接尝试记录,包含起止时间、首个终态和取消原因,先让连接问题能与模型处理问题分开定位。
- 在前端或移动端连接管理中统一收敛成功、失败、取消和超时回调,验证一次尝试只上报一次,尤其检查重试替换旧连接时的行为。
- 如果 Node 网关已经接入 tracing,就核对握手请求与客户端资源的上下文是否一致,再沿实际 span 检查鉴权、路由和初始化处理。
- 调整连接监控看板,分别展示各结果的次数与耗时分位数,保留取消占比,并写清采样范围和时间窗口,避免只靠一个成功率或混合 P95 判断体验。