用客户消息证据判断工单是否真正解决
该开源项目结合 Snowflake Cortex AI、SQL 与 Streamlit,从客户消息中识别问题解决状态,避免把礼貌措辞误当成问题已解决。项目提供可复现 SQL、合成数据、已保存的模型输出和评估查询,无需 Snowflake 账号也能检查结果。
AI 深度解读
客户说「谢谢更新,但我的账号还是锁着」,语气很客气,问题却没有解决。把这条消息标成中性或正面,对客服运营的帮助有限。作者用 Snowflake Cortex AI、SQL 和 Streamlit 做了一个实验:不判断客户态度好不好,而是判断消息里有没有问题已解决、仍未解决或客户反驳结案的证据。
这套实现值得看的地方,是标签怎么划、推理结果怎么留、看板怎么避免重复调用模型。至于最终的 200/200,作者明确承认:它验证的是受控合成数据上的分类表现,不能当成真实客服场景的准确率。
客气不代表解决,修复失败也不等于反驳结案
作者把三个概念拆开:情绪倾向、表达不满,以及问题解决状态的证据。三者可能相关,但不能互相代替。一个客户可以礼貌地报告故障,也可以带着不满确认问题已经修好。
实验只评估第三项,没有验证情绪或不满分类的准确率。它使用四个标签:
confirmed_resolved:客户明确确认测试过修复,或已经获得预期结果,问题得到解决。reported_unresolved:客户报告问题仍在,或某次修复尝试失败,但没有明确反驳此前的解决声明。disputed:客户明确质疑其他人的声明或工单状态,例如客服说已修复,客户指出仍然无法使用。unknown:没有足够证据判断当前状态,例如索要文档、询问操作步骤、承诺稍后测试或礼貌结束对话。
最容易混淆的是中间两类。「我试了你的建议,还是失败」通常只能证明问题还在;只有上下文里存在「已经解决」的声明,客户又明确反驳它,才构成 disputed。
分类要回答的是消息提供了什么证据,而不是替客户猜一个最终状态。
unknown 因此有实际用途。客户说稍后测试,模型就不该提前宣布成功或失败。它保留的是信息缺口,也提醒后续流程继续收集证据。
把分类边界写进 SQL,比只给四个标签更具体
作者将样本和参考标签放进 RESOLUTION_V3_CASES,将输出保存到 RESOLUTION_V3_RESULTS。下面这段调用解决的是分类边界问题:每个标签都有描述,任务指令还专门限制了 disputed 和 unknown 的使用条件。
SELECT
  c.CASE_ID,
  'resolution-v3.0' AS VERSION,
  CURRENT_TIMESTAMP() AS RUN_AT,
  AI_CLASSIFY(
    c.TRANSCRIPT,
    [
      {'label':'confirmed_resolved',
       'description':'The customer explicitly confirms they tested a fix or received the desired outcome and the problem is resolved.'},
      {'label':'reported_unresolved',
       'description':'The customer reports the problem is ongoing or an attempted fix failed, without explicitly contradicting a previous declaration that it was resolved.'},
      {'label':'disputed',
       'description':'The customer explicitly challenges another actor''s statement or ticket status asserting the issue is resolved, completed, or fixed.'},
      {'label':'unknown',
       'description':'There is insufficient evidence about current resolution status: a procedural question, future promise, documentation request, or polite closing.'}
    ],
    {
      'task_description':
        'Classify resolution evidence only, not sentiment or courtesy. '
        || 'Choose disputed only for explicit contradiction of a prior '
        || 'completion claim. For future plans or questions without '
        || 'current issue evidence, choose unknown. Return one label.',
      'output_mode':'single'
    }
  ) AS RESOLUTION_RAW
FROM RESOLUTION_V3_CASES c;
重点看 task_description:它要求只分类解决证据,忽略情绪和礼貌,并且只在明确反驳此前完成声明时选择 disputed。output_mode:'single' 则要求返回一个标签。
这段代码是说明性节选,不能代替完整脚本。可执行文件 sql/09_resolution_v3_200_benchmark.sql 还包含建表、持久化和重复执行处理;已有成功结果的样本与版本组合,不再重新分类。
输出也没有提取完标签就丢弃。作者用 VARIANT 保存 RESOLUTION_RAW,保留运行版本与时间,再通过 r.RESOLUTION_RAW:labels[0]::VARCHAR 提取预测,与 GOLD_RESOLUTION 比较得到 EXACT_MATCH。标签缺失时返回 NULL,不会直接混入普通错误。
完整比较视图还会为每条样本选择最新运行,并带上产品、领域、分组和时间。这些字段让排查落到具体消息,而不是只剩一个总百分比。
仓库另有使用 AI_SENTIMENT、AI_EXTRACT 和问题类别 AI_CLASSIFY 的数据补充流程,但它们不属于这次解决状态实验。
看板刷新不跑推理,200/200 也不代表上线可用
Streamlit 读取已经保存的比较视图,不在刷新页面时重新分类。下面的代码负责取数:
import streamlit as st
from snowflake.snowpark.context import get_active_session

@st.cache_data(ttl=300)
def load_predictions():
    session = get_active_session()
    return session.sql("""
        SELECT CASE_ID, PRODUCT, DOMAIN, COHORT,
               TRANSCRIPT, GOLD_RESOLUTION,
               CORTEX_RESOLUTION, EXACT_MATCH,
               TO_VARCHAR(RESOLUTION_RAW) AS RESOLUTION_RAW_TEXT
        FROM CORTEX_CI_DEMO.APP.V_RESOLUTION_V3_COMPARISON
        WHERE CASE_ID LIKE 'R3-%'
        ORDER BY CASE_ID
    """).to_pandas()
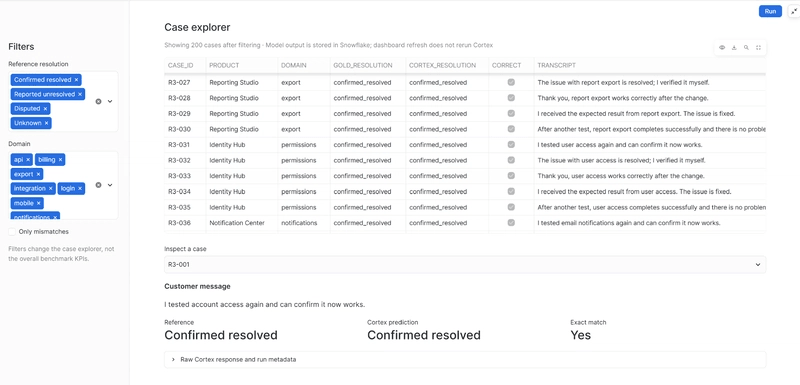
注意 session.sql() 查询的是 CORTEX_CI_DEMO.APP.V_RESOLUTION_V3_COMPARISON;ttl=300 是取数缓存时间。推理与展示分开后,用户切换筛选条件不会触发新的 Cortex 推理费用,也更容易复查同一批结果。
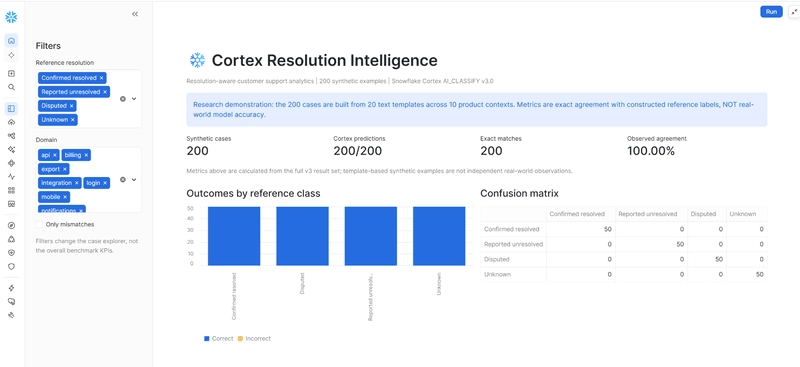
看板提供各类别数量、混淆矩阵、参考标签和领域筛选。单条浏览器还能查看原消息、参考标签、预测与原始响应。
作者称在 2026 年 11 月的 Snowflake 试用期间做了三轮小实验,正文具体说明了其中两组。24 条样本的实验出现四处不匹配:三条问题持续存在的消息被判成争议,一条面向未来的请求被判成未解决。这些错误暴露了需要收紧的语义边界。
修订标签指令后,作者运行了 200 条合成样本,每类 50 条,预测全部匹配参考标签。
但这 200 条来自 20 个句式模板和 10 个产品或功能上下文,标签也在造数据时写好。它们不是 200 段独立采集的真实对话。而且 v2 到 v3 同时改了指令和数据,无法把结果变化单独归功于指令优化。
200/200 证明这套流程能在构造的数据上跑通,不能证明真实业务准确率达到 100%。
复现需要兼容的 Cortex 权限和计算仓库。默认资源是数据库 CORTEX_CI_DEMO、schema APP 和 warehouse CORTEX_CI_WH;在 Snowsight 执行完整 SQL 后,再用 streamlit_resolution_v3.py 创建应用并授予视图读取权限。没有账号也能检查仓库保存的 200 行 CSV、代码和截图。原文还列出归档 DOI 10.5281/zenodo.24098765 与 90 秒演示,但没有提供第二个 Snowflake 环境的独立复现结果。
我的判断
我认可的是先定义业务证据,再调用模型,以及保留原始输出的做法。相比直接给客服消息打情绪分,它更贴近「是否需要继续跟进」这类运营问题;相比刷新即推理的看板,保存结果再展示也更容易控制费用、核对异常。
不过,四类标签仍然依赖上下文完整度。单条客户消息可能没提此前的结案声明,历史对话里却存在。此时模型即使严格遵循指令,也可能因为输入缺信息,把真实争议归到未解决。作者提出要测试更长的多轮历史,但当前实验还没有证明这部分能力。
原文也没有与关键词规则、其他分类器或人工流程做对照,更没有给出成本和延迟数据。因此,不能据此判断 Cortex 是否比替代方案更划算。这是一份实现与分类体系的演示。
下一轮评估更应该补独立标注的真实表达、部分修复、含糊结案和只差一个关键分句的对照样本。涉及真实客户数据时,还需要作者列出的授权、PII 保护、角色权限、保留期限、漂移监控与重要操作人工复核。当前项目只使用合成对话,没有使用雇主或真实客户记录。
能拿来做什么
- 给客服分析增加 AI 分类前,先把「仍未解决」与「反驳已解决」写成可执行的标签定义,并为每个边界准备容易混淆的例子。
- 用 Streamlit 或现有前端做分析看板时,让页面读取持久化预测,同时展示原消息、版本与原始响应,方便业务人员逐条核对。
- 检查 AI 分类效果时,先看混淆矩阵和错例,再看总命中率;调整提示词后保留同一套独立测试集,才能比较改动是否有效。
- 对索要文档、稍后测试等证据不足的消息保留
unknown,把它用于后续跟进,避免直接驱动结案等重要操作。